
容器与云原生 / 系统课时
etcd 备份与恢复
etcd 备份与恢复
etcd 保存 Kubernetes API 对象的持久状态,备份失效会让控制面故障缺少可靠恢复点。本课完成一次带 TLS 的快照备份、完整性检查和离线恢复演练,并明确生产恢复的切换边界。
学习目标
- 说明 etcd 快照能恢复什么,以及它不能替代哪些备份。
- 使用
etcdctl创建快照并用etcdutl校验状态。 - 按停止写入、恢复数据目录、切换配置和集群验收的顺序设计恢复。
备份前确认
先确认 etcd 的部署方式、版本、端点和证书路径。kubeadm 的堆叠式控制平面通常把本地 etcd 作为静态 Pod 运行,但托管 Kubernetes 或外部 etcd 集群的备份入口可能完全不同,应优先遵循平台提供方的恢复流程。
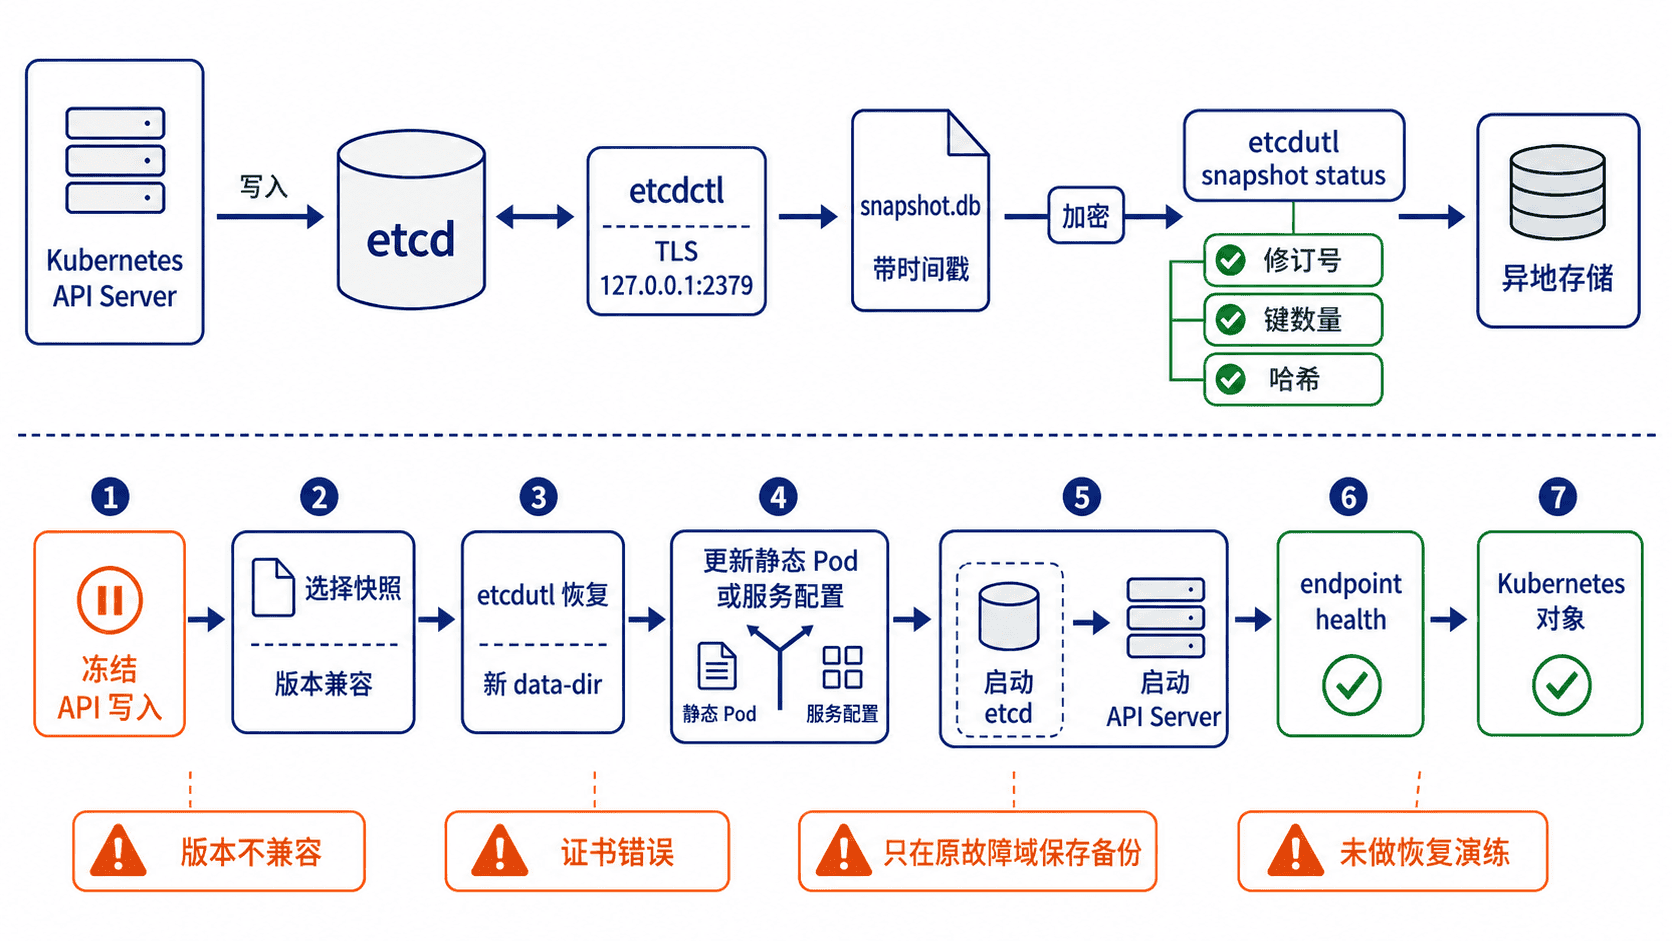
快照保存 Kubernetes 对象状态,却不包含容器镜像、节点文件、外部数据库数据或持久卷业务数据。备份文件还可能含有 Secret 等敏感信息,因此应加密存储、限制读取权限,并复制到与控制平面故障域不同的位置。
创建并校验快照
备份路径应带时间戳,且在快照完成后立即执行状态检查。下面示例适用于常见的 kubeadm 本地 etcd,要求当前主机已安装与集群版本兼容的 etcdctl 和 etcdutl。
set -euo pipefail

# 使用受限目录保存快照,避免普通用户直接读取集群敏感状态
BACKUP_DIR="/var/backups/etcd"
SNAPSHOT="$BACKUP_DIR/snapshot-$(date +%Y%m%d-%H%M%S).db"

sudo install -d -m 0700 "$BACKUP_DIR"
sudo env ETCDCTL_API=3 etcdctl --endpoints="https://127.0.0.1:2379" --cacert="/etc/kubernetes/pki/etcd/ca.crt" --cert="/etc/kubernetes/pki/etcd/healthcheck-client.crt" --key="/etc/kubernetes/pki/etcd/healthcheck-client.key" endpoint health
sudo env ETCDCTL_API=3 etcdctl --endpoints="https://127.0.0.1:2379" --cacert="/etc/kubernetes/pki/etcd/ca.crt" --cert="/etc/kubernetes/pki/etcd/healthcheck-client.crt" --key="/etc/kubernetes/pki/etcd/healthcheck-client.key" snapshot save "$SNAPSHOT"
# 快照完成后立即校验元数据,不能只依赖文件存在
sudo etcdutl --write-out=table snapshot status "$SNAPSHOT"
sudo chmod 0600 "$SNAPSHOT"
echo "SNAPSHOT=$SNAPSHOT"
预期输出
https://127.0.0.1:2379 is healthy: successfully committed proposal: took = <TIME>
Snapshot saved at /var/backups/etcd/snapshot-<TIME>.db
+--------------+------------+------------+------------+
|     HASH     |  REVISION  | TOTAL KEYS | TOTAL SIZE |
+--------------+------------+------------+------------+
|    <HASH>    |   <REV>    |  <COUNT>   |   <SIZE>   |
+--------------+------------+------------+------------+
SNAPSHOT=/var/backups/etcd/snapshot-<TIME>.db
快照文件名、修订号、键数量和大小会随集群变化。只有 snapshot save 成功还不够,必须保留状态检查结果,并定期验证备份能在隔离环境恢复。
执行离线恢复演练
恢复会创建新的 etcd 数据目录,不应直接覆盖正在运行的 /var/lib/etcd。以下示例只恢复到测试目录,用于验证快照可读和目录结构可生成,不会自动切换生产控制平面。
set -euo pipefail

# 自动选择最新快照,仅恢复到隔离测试目录
SNAPSHOT="$(sudo bash -c 'ls -1t /var/backups/etcd/snapshot-*.db | head -n 1')"
RESTORE_DIR="/var/lib/etcd-restore-test"

test -n "$SNAPSHOT"
sudo rm -rf "$RESTORE_DIR"
sudo etcdutl --data-dir="$RESTORE_DIR" snapshot restore "$SNAPSHOT"
# 通过后端数据库文件确认恢复目录结构已经生成
sudo test -f "$RESTORE_DIR/member/snap/db"
echo "restore directory ready: $RESTORE_DIR"
预期输出
restore directory ready: /var/lib/etcd-restore-testetcdutl 在此之前还会输出恢复过程日志,具体内容随版本变化。演练成功只证明快照能够生成新的数据目录;生产切换还需要根据单成员、外部多成员或 kubeadm 堆叠式 etcd 的实际拓扑设置成员名称、对等地址和初始集群参数。
生产恢复顺序与验证
真正恢复前,应停止或隔离 API Server 写入,备份现有数据目录和静态 Pod 清单,并使用与快照相同主次版本的 etcd 工具执行恢复。随后把 etcd 配置指向新数据目录,先启动并验证 etcd 健康,再启动 API Server;多控制平面集群必须保证所有成员使用一致的新集群配置。
控制面恢复后,依次检查 etcd 端点健康、API Server 可用性、节点状态、命名空间、关键 Deployment、Secret、ConfigMap 和自定义资源。还要核对快照时间之后发生的对象变更,因为恢复是回到某个历史时点,不会自动补回后续写入。
常见失败包括证书与端点不匹配、快照版本不兼容、恢复目录权限错误、静态 Pod 仍引用旧目录,以及只备份在原控制平面磁盘上。正确做法是把备份、校验记录和恢复手册一并纳入周期演练。