
容器与云原生 / 系统课时
使用 kubeadm 创建集群
使用 kubeadm 创建集群
本课完成一条最小但完整的 kubeadm 建集群链路:检查节点环境、初始化控制平面、配置 kubectl、安装网络插件、加入工作节点并验证状态。示例使用占位符表达地址和网段,执行前需替换为当前环境的真实值。
学习目标
- 理解 kubeadm、kubelet、容器运行时和网络插件的协作顺序
- 完成控制平面初始化与工作节点加入
- 根据节点和系统 Pod 状态判断集群是否可用
前置检查
准备至少一台控制平面节点和一台工作节点。所有节点应能互相解析并访问所需端口,主机名与地址不能冲突;容器运行时、kubelet 和 kubeadm 已安装,并按当前版本要求统一 cgroup 配置。若环境未显式支持 swap,应先按部署规范处理。
在每台节点执行基础检查:
# 核对引导工具、节点代理和 CRI 运行时是否可用。
printf 'kubeadm=%s\n' "$(kubeadm version -o short)"
printf 'kubelet=%s\n' "$(kubelet --version)"
sudo crictl info >/dev/null && echo "runtime=ready"
预期输出
kubeadm=<VERSION>
kubelet=Kubernetes <VERSION>
runtime=ready
<VERSION> 会随安装版本变化。若运行时检查失败,应先修复 CRI 端点或容器运行时服务,不能直接继续初始化。
初始化与加入的完整链路
kubeadm 先生成证书和静态 Pod 清单,kubelet 再启动控制面组件;随后管理员配置 kubectl,安装 CNI 网络插件。工作节点使用令牌和 CA 公钥摘要加入,最终由调度器把工作负载分配到 Ready 节点。
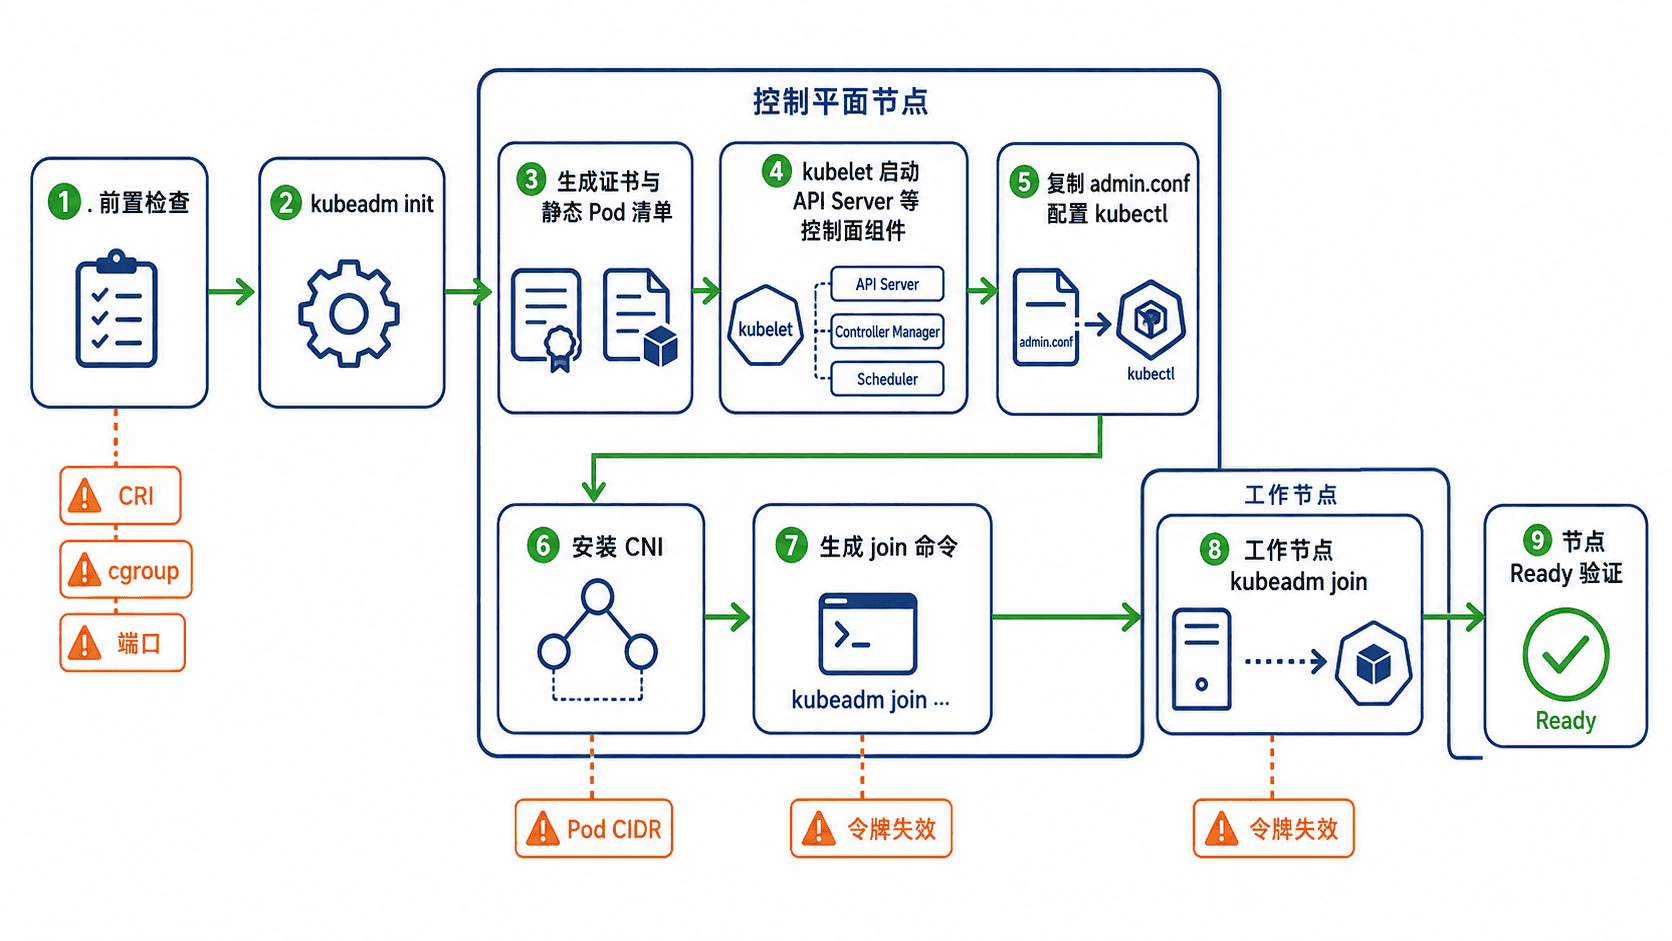
初始化控制平面
在控制平面节点执行以下命令。<API_ENDPOINT> 可以是控制平面地址或为高可用集群预留的负载均衡地址,<POD_CIDR> 必须与所选网络插件的配置一致。
# 初始化控制面;高可用场景应把 endpoint 指向负载均衡地址。
sudo kubeadm init \
  --control-plane-endpoint "<API_ENDPOINT>:<PORT>" \
  --pod-network-cidr "<POD_CIDR>"

# 复制管理员凭据,使当前用户可以执行 kubectl。
mkdir -p "$HOME/.kube"
sudo cp /etc/kubernetes/admin.conf "$HOME/.kube/config"
sudo chown "$(id -u):$(id -g)" "$HOME/.kube/config"
预期结果
Your Kubernetes control-plane has initialized successfully!
kubeadm join <API_ENDPOINT>:<PORT> --token <TOKEN> --discovery-token-ca-cert-hash sha256:<HASH>
完整输出还会给出配置 kubectl 和安装 Pod 网络的提示。<PORT>、<TOKEN> 与 <HASH> 为动态值,必须使用当前集群实际输出。
安装网络插件
控制面初始化完成后,节点可能暂时显示 NotReady,CoreDNS 也可能等待调度。这通常是因为 Pod 网络尚未建立。使用与 <POD_CIDR> 匹配的官方或团队审核过的 CNI 清单:
# 清单参数必须与初始化时使用的 Pod CIDR 匹配。
kubectl apply -f <CNI_MANIFEST_URL>
kubectl -n kube-system get pods
网络插件就绪后的预期关键状态
<NETWORK_POD>   1/1   Running
coredns-<ID>    1/1   Running
不同插件的资源名称和副本数会不同。若网络 Pod 持续失败,应检查清单参数、节点网络、内核能力和 Pod CIDR 是否一致。
加入工作节点并验证
若初始化时的加入命令已经丢失或令牌失效,可在控制平面节点重新生成:
# 重新生成当前有效的节点加入命令。
kubeadm token create --print-join-command
预期输出
kubeadm join <API_ENDPOINT>:<PORT> --token <TOKEN> --discovery-token-ca-cert-hash sha256:<HASH>复制该命令到工作节点,并使用管理员权限执行。成功后回到控制平面验证:
# 在待加入的工作节点执行控制平面生成的命令。
sudo kubeadm join <API_ENDPOINT>:<PORT> \
  --token <TOKEN> \
  --discovery-token-ca-cert-hash sha256:<HASH>
预期结果
This node has joined the cluster随后检查节点状态:
# 节点应在网络插件就绪后进入 Ready。
kubectl get nodes
预期输出
NAME              STATUS   ROLES           AGE      VERSION
control-plane-1   Ready    control-plane   <TIME>   <VERSION>
worker-1          Ready    <none>          <TIME>   <VERSION>
再检查所有命名空间中的系统组件:
# 重点确认网络插件和 CoreDNS 处于 Running。
kubectl get pods -A
预期关键结果
NAMESPACE     NAME              READY   STATUS    RESTARTS   AGE
kube-system   coredns-<ID>      1/1     Running   <COUNT>    <TIME>
kube-system <NETWORK_POD> 1/1 Running <COUNT> <TIME><TIME>、<COUNT>、节点名、Pod 名和版本以实际环境为准。节点 Ready 只说明基础注册和网络正常,上线业务前还应继续验证 DNS、Service 通信、存储和资源配额。
典型失败处理
kubeadm init 在预检阶段失败时,先按错误定位端口占用、残留清单、内核参数或运行时问题。只有确认节点可重新初始化时,才使用 kubeadm reset 清理状态,生产节点不要把它当作通用修复命令。
工作节点加入失败时,优先重新生成 join 命令,并确认节点能访问 API Endpoint。节点长期 NotReady 时,查看 kubelet 日志和 CNI Pod 状态;CoreDNS 长期 Pending 或反复重启时,重点检查网络插件是否成功、网段是否冲突以及节点 DNS 配置。