
容器与云原生 / 系统课时
集群容量与成本管理
集群容量与成本管理
本课建立一套可执行的容量分析方法:把节点可分配资源、工作负载请求、实际使用量和弹性边界放到同一张账上,找到成本浪费来源,并在不牺牲稳定性的前提下持续优化。
学习目标
- 区分节点容量、资源请求、实际使用量和安全余量
- 使用 kubectl 采集容量与调度证据
- 按请求校准、节点池调整和弹性策略形成成本优化闭环
建立统一的容量账本
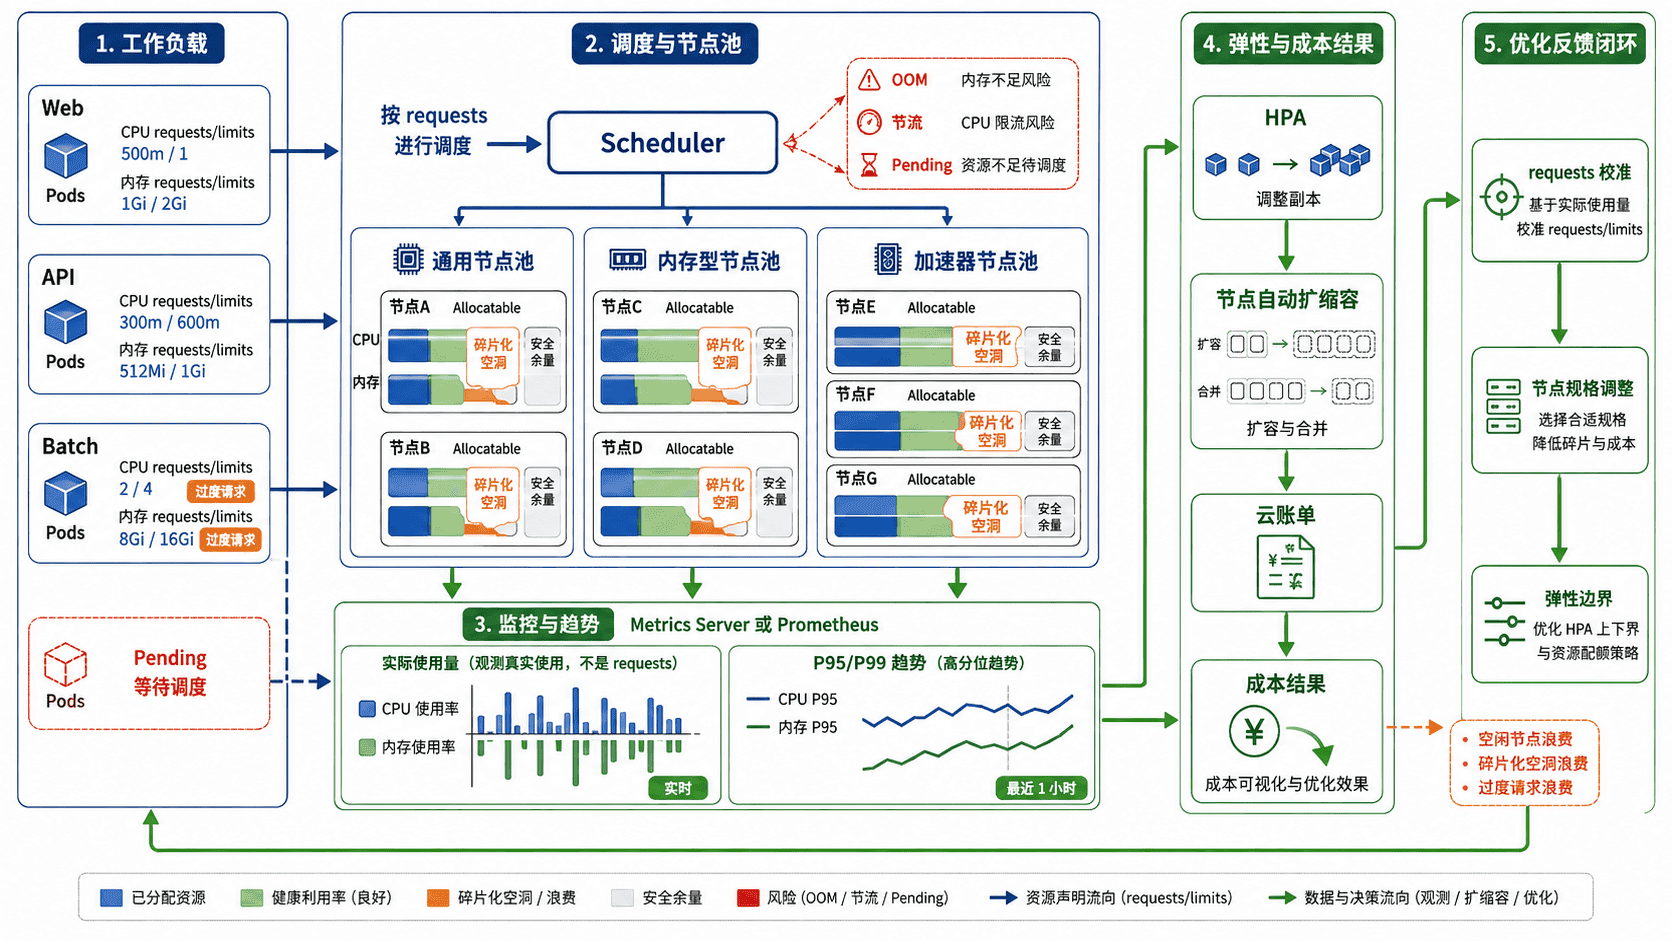
节点成本首先由已购买或已运行的节点决定,但调度器主要根据 Pod 的资源 requests 选择节点,而不是根据容器当时的真实使用量。limits 用于限制运行时资源,CPU 超限通常表现为节流,内存超限可能触发 OOM 终止。因此,过大的 requests 会造成“账面已满、机器很闲”,过小的 requests 又会提高争抢、驱逐和扩容滞后的风险。:contentReference[oaicite:2]{index=2}
分析时至少同时记录四组数据:节点 Allocatable、全部 Pod requests、CPU 与内存的 P95 或 P99 使用量、为故障迁移与流量突增保留的安全余量。请求利用率可写成 总 requests ÷ 总 Allocatable,实际利用率则应使用观察窗口内的高分位值,而不是某一分钟的快照。
采集容量与调度证据
下面的命令适用于已配置 kubectl 的集群。kubectl top 依赖资源指标管道;若命令不可用,应先修复 Metrics Server 或等价指标来源,再做使用率判断。
# 查看节点可分配容量、当前使用量和是否存在未调度 Pod
kubectl get nodes -o custom-columns='NAME:.metadata.name,CPU:.status.allocatable.cpu,MEMORY:.status.allocatable.memory'
kubectl top nodes
kubectl get pods -A --field-selector=status.phase=Pending

# 查看每个节点已经承诺的 requests 与 limits
for node in $(kubectl get nodes -o name); do
  echo "=== ${node#node/} ==="
  kubectl describe "$node" | sed -n '/Allocated resources:/,/Events:/p'
done

# 查找最近的调度失败原因
kubectl get events -A --field-selector=reason=FailedScheduling
预期输出
NAME       CPU        MEMORY
<NODE_A>   <CPU>      <MEMORY>
<NODE_B>   <CPU>      <MEMORY>

NAME       CPU(cores)   CPU%   MEMORY(bytes)   MEMORY%
<NODE_A>   <VALUE>      <PCT>  <VALUE>         <PCT>

Allocated resources:
  Resource   Requests           Limits
  cpu        <VALUE> (<PCT>)    <VALUE> (<PCT>)
  memory     <VALUE> (<PCT>)    <VALUE> (<PCT>)
实际节点名和数值会不同。若 kubectl top 显示使用率较低,而 Allocated resources 中 requests 比例很高,优先检查请求是否长期偏大;若总请求不高但仍有 Pending Pod,则继续检查节点选择器、亲和性、污点、可用区、端口或单 Pod 规格造成的碎片化。
识别成本浪费的来源
容量浪费通常不是单一问题,应按以下顺序定位:
- 请求膨胀:长期使用量远低于 requests,导致调度器认为节点已满
- 规格碎片:大量小空洞无法容纳目标 Pod,集群总空闲仍然触发扩容
- 固定余量过大:节点池最小规模、跨可用区冗余或专用节点长期空闲
- 弹性受阻:PodDisruptionBudget、本地存储、强亲和性或不可迁移工作负载阻止节点合并
节点自动扩缩容在扩容和合并时主要依据 Pod requests 与调度约束,并不会直接按 Pod 启动后的真实使用量决策;因此,错误的 requests 会同时误导调度器和节点自动扩缩容。:contentReference[oaicite:3]{index=3}
形成安全的优化闭环
先选择至少一周、最好覆盖业务峰谷的观察窗口,为每类工作负载比较 requests、P95/P99 使用量、节流、OOM 和重启记录。CPU 可保留可突发空间;内存必须为堆增长、缓存和瞬时峰值留出更谨慎的余量。调整应分批进行,并保留快速恢复旧配置的版本。
随后调整节点池:通用负载使用与主要 Pod 形状匹配的节点规格;大内存、GPU 或本地盘负载进入独立节点池;通过污点、容忍和亲和性减少昂贵节点被普通 Pod 占用。再组合 HPA 与节点自动扩缩容:HPA 先改变副本需求,节点扩缩容再根据不可调度 Pod 增加容量,并在工作负载可迁移时合并低利用率节点。
最后把边界写入治理规则,包括命名空间配额、默认 requests、节点池最小与最大规模、允许使用抢占式实例的工作负载范围,以及扩缩容冷却和维护窗口。成本优化的目标不是把利用率推到 100%,而是让每单位业务量的成本下降,同时保持故障迁移和突发流量所需的余量。
验证优化没有损害稳定性
每轮修改后重新执行容量采集命令,并连续观察业务 SLO、Pending Pod、CPU 节流、OOM、节点扩缩容次数和成本变化。只有“成本下降、关键错误不增加、峰值仍有余量”同时成立,才应扩大调整范围;如果故障恢复容量不足,应先恢复安全余量,再继续优化。