
容器与云原生 / 系统课时
网络与存储故障排查
网络与存储故障排查
本课建立一套可重复的 Kubernetes 网络与存储排查顺序:先从事件和资源状态确认故障层级,再沿请求链或卷挂载链逐段验证,最终用最小改动修复并完成端到端复测。
学习目标
- 按 Ingress、Service、EndpointSlice、Pod、DNS 的顺序定位网络中断点。
- 识别 NetworkPolicy 导致的入口、出口与 DNS 访问问题。
- 区分 PVC Pending、卷附加失败、挂载失败和容器内权限问题。
建立两条排查链路
网络问题不要从“重启 Pod”开始,而应先判断请求在哪一段中断。外部请求链通常是客户端到 Ingress Controller,再到 Service、EndpointSlice 和后端 Pod;集群内调用还要额外检查 DNS 与 NetworkPolicy。存储问题则沿 PVC、PV、StorageClass、CSI、节点挂载和容器目录逐层确认。
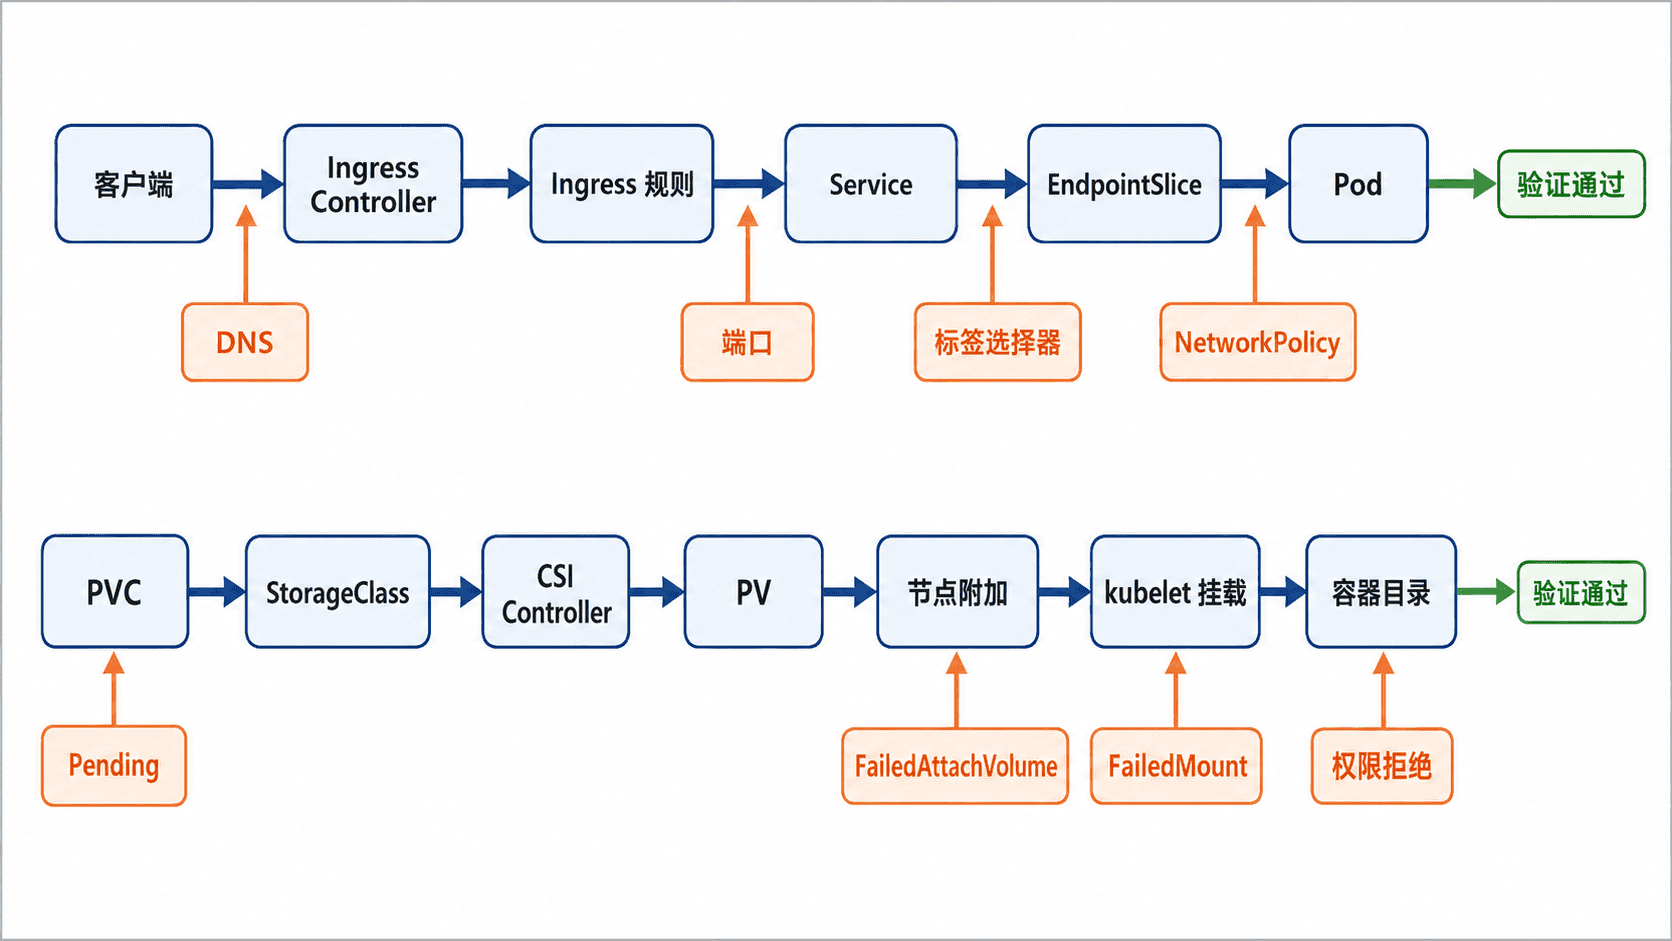
先执行只读检查,保留当时的对象状态和事件。若直接删除 Pod、PVC 或重启控制面组件,原始证据可能消失,后续只能猜测根因。
排查 Service、DNS 与 Ingress
下面以 shop 命名空间中的 backend 服务为例。第一组命令同时查看 Pod、Service、EndpointSlice 与 Ingress,确认标签选择、端口映射和后端地址是否连贯。
kubectl -n shop get pod,svc,endpointslice,ingress -o wide
kubectl -n shop describe ingress shop
预期结果
backend Pod 为 Running 且 Ready
Service/backend 暴露 8080/TCP
EndpointSlice/backend-<ID> 中存在 <POD_IP>:8080
Ingress/shop 的规则指向 Service/backend:8080
如果 Service 存在但 EndpointSlice 没有地址,优先比较 Service 的 spec.selector 与 Pod 标签,并确认 Pod 的就绪探针已经通过。若 EndpointSlice 正常而访问失败,再从临时诊断 Pod 验证 DNS 与服务端口。
kubectl -n shop run netcheck --rm -i --restart=Never --image=busybox:1.36 -- sh -c 'nslookup backend.shop.svc.cluster.local && wget -qO- http://backend:8080/health'预期输出
DNS 结果包含 backend.shop.svc.cluster.local 与 <CLUSTER_IP>
健康检查返回 ok
pod "netcheck" deleted
实际 IP、临时 Pod 名称和删除提示可能不同。若 DNS 失败,检查 CoreDNS Pod、kube-dns Service、节点到 DNS Service 的网络以及 NetworkPolicy 的 UDP/TCP 53 出站规则。若集群内访问正常而外部失败,检查 IngressClass、Controller 日志、主机名、TLS Secret、后端 Service 名称和端口。
排查 NetworkPolicy
NetworkPolicy 只对支持该能力的 CNI 生效。出现“同命名空间可访问、跨命名空间失败”或“业务端口失败但 DNS 也失败”时,应检查是否存在默认拒绝策略,以及允许规则的 Pod 标签、命名空间标签、端口和方向是否完整。
kubectl -n shop get networkpolicy
kubectl -n shop describe networkpolicy
kubectl get namespace --show-labels
预期结果
能够列出 shop 命名空间中的策略名称、Pod 选择器与入站/出站方向
目标命名空间具有规则引用的标签
允许规则覆盖业务端口,并在需要时允许 DNS 的 UDP/TCP 53
不要只检查目标 Pod 的策略。入口流量由目标端的 Ingress 规则控制,出口流量由源 Pod 的 Egress 规则控制;任一侧启用默认拒绝后,都需要显式放行。策略修改后应重新运行同一条 netcheck 命令,而不是只观察对象已成功提交。
排查 PVC 与挂载
PVC 长时间处于 Pending,通常与 StorageClass、动态制备器、容量、访问模式或绑定模式有关。Pod 已调度但停在 ContainerCreating,则重点查看事件中的 FailedAttachVolume、Multi-Attach、FailedMount 和超时信息。
kubectl -n shop get pvc,pod -o wide
kubectl -n shop describe pvc data-postgres-0
kubectl -n shop describe pod postgres-0
kubectl get pv
预期结果
PVC/data-postgres-0 状态为 Bound,并关联一个 PV
Pod/postgres-0 的 Volumes 指向该 PVC
Events 中没有持续出现 FailedAttachVolume 或 FailedMount
PVC Pending 时,检查 storageClassName 是否存在、是否有默认 StorageClass、CSI provisioner 是否健康,以及请求容量和 accessModes 是否被后端支持。使用 WaitForFirstConsumer 时,PVC 可能在 Pod 选定节点前暂不绑定,这不一定是故障。挂载阶段失败时,还要检查 CSI Controller、CSI Node、kubelet 日志、节点磁盘路径和可用区限制。
卷已挂载但应用报权限错误,检查容器运行用户、目录属主、fsGroup、只读挂载和存储后端权限。不要把删除 PVC 作为首选修复手段,因为动态制备卷可能按回收策略删除真实数据。
完成修复后的验证
网络修复后应同时验证 EndpointSlice、集群内 DNS、Service 访问和外部入口;存储修复后应验证 PVC Bound、Pod Ready、目录可写以及 Pod 重建后的数据仍然存在。
kubectl -n shop get endpointslice,pvc,pod
kubectl -n shop exec postgres-0 -- sh -c 'echo verify > /var/lib/postgresql/data/anystack-check && cat /var/lib/postgresql/data/anystack-check'
kubectl -n shop rollout restart statefulset/postgres
kubectl -n shop rollout status statefulset/postgres --timeout=180s
kubectl -n shop exec postgres-0 -- cat /var/lib/postgresql/data/anystack-check
预期输出
verify
statefulset.apps/postgres restarted
statefulset rolling update complete
verify
该示例假设 postgres-0 由 StatefulSet/postgres 管理,且容器允许写入指定数据目录;实际名称、路径和滚动更新提示可能不同。若第二次读取失败,说明卷没有重新挂载到预期位置,或工作负载使用了临时存储。