
容器与云原生 / 系统课时
Kubernetes 是什么
Kubernetes 是什么
Kubernetes 是一个用于自动部署、扩缩和管理容器化应用的开源编排系统。它接收团队声明的期望状态,再通过调度、控制循环和网络抽象维持运行结果。本课将建立核心心智模型,并说明它适合解决什么问题、又在哪些场景中过于复杂。
学习目标
- 用期望状态和控制循环解释 Kubernetes。
- 认识调度、自愈、服务发现和滚动更新等能力。
- 根据系统规模与团队条件判断是否适合采用。
Kubernetes 的核心定位
Kubernetes 不是制作镜像的工具,也不是直接执行容器进程的运行时。它位于容器之上,负责决定工作负载何时创建、运行在哪个节点、需要多少副本,以及发生故障后如何恢复。底层容器运行时执行容器,Kubernetes 负责整体协调。
用户通过资源对象描述目标,例如副本数、镜像版本和网络入口。控制面保存这些声明,调度器选择节点,控制器持续比较实际状态与期望状态。当两者不一致时,系统会创建、替换、迁移或更新工作负载。
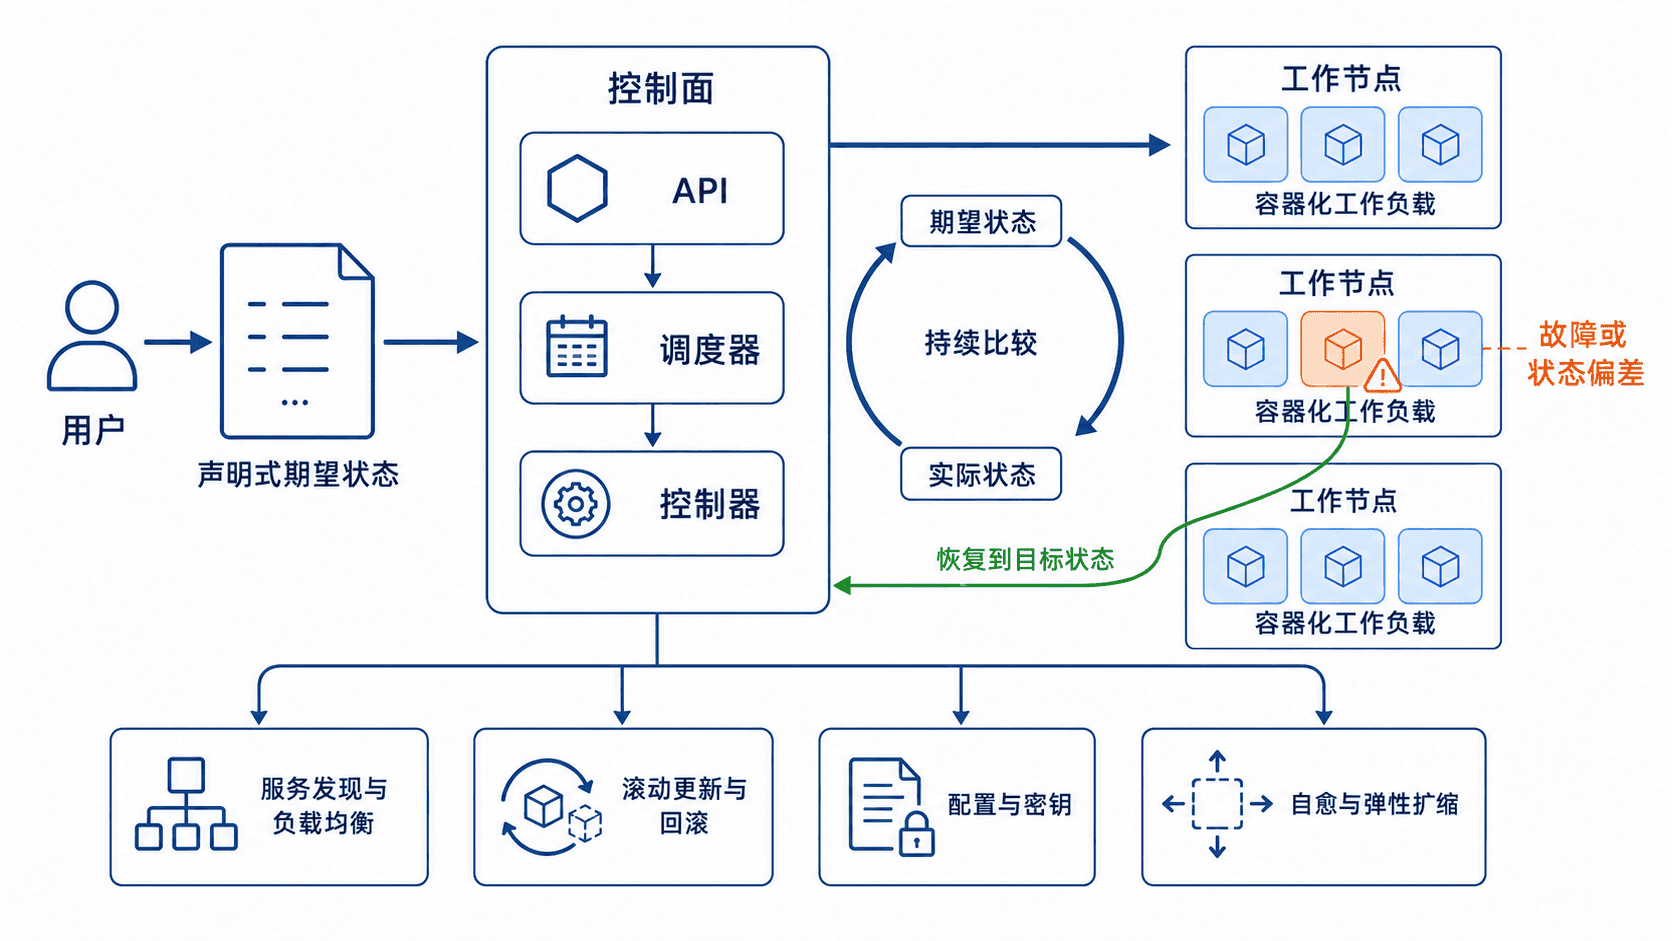
核心能力如何协同
| 能力 | 解决的问题 | 结果 |
|---|---|---|
| 调度 | 实例应运行在哪个节点 | 资源被合理分配 |
| 自愈 | 容器或节点发生故障 | 异常副本被替换 |
| 服务发现 | 实例地址不断变化 | 调用方使用稳定入口 |
| 滚动更新 | 发布可能中断服务 | 分批替换并支持回滚 |
| 弹性扩缩 | 负载随时间变化 | 副本数按策略调整 |
这些能力依赖同一套资源模型。调度器先放置实例,健康检查判断实例能否接收流量,Service 为变化中的实例提供稳定入口,控制器在副本不足或版本变化时继续调整。Kubernetes 的价值不只在单项功能,而在于用统一 API 和状态模型协调它们。
常见资源的基本关系
集群由控制面和工作节点组成;Pod 是运行容器的基本单元,通常不由用户长期手工维护;Deployment 负责维持无状态应用的副本数和版本;Service 为一组变化中的 Pod 提供稳定访问入口。
初学阶段不必记住全部资源名称,但要抓住共同规律:资源对象描述目标,控制器负责实现目标。后续无论学习配置、发布还是故障恢复,都可以回到“期望状态与实际状态是否一致”这一主线。
适合与不适合的场景
Kubernetes 适合多服务、多环境、频繁发布和高可用要求明显的系统。团队需要跨节点容错、统一服务发现、自动扩缩或标准化交付流程时,它能减少大量人工协调,并为权限、策略和监控提供统一入口。
单体应用、低流量内部工具或只运行在一台主机上的服务,通常使用虚拟机、托管平台或轻量容器方案更省成本。数据库等有状态系统虽然可以运行在 Kubernetes 上,但还需要成熟的存储、备份和故障演练能力。
采用前要评估什么
引入前应确认业务确实需要多节点、高可用或自动恢复,并且团队能够承担集群升级、安全补丁、网络与可观测性维护。若平台经验不足,优先选择托管 Kubernetes,通常比自行维护控制面更稳妥。
评估时还要计算学习时间、平台工程、监控、备份和安全治理等长期成本。只有标准化与自动化收益明显超过这些投入时,Kubernetes 才是合适的基础设施选择。