
容器与云原生 / 系统课时
Prometheus 监控体系
Prometheus 监控体系
本课将拆解 Prometheus 在 Kubernetes 中的服务发现、目标筛选、周期抓取、时序存储与查询流程,并通过一个最小配置和 API 查询验证监控链路。
学习目标
- 说明 Prometheus 从发现目标到保存样本的完整数据路径。
- 读懂 Kubernetes 服务发现与
relabel_configs的职责分工。 - 使用 PromQL 和 HTTP API 验证目标是否被正常抓取。
从目标发现到时序存储
Prometheus 采用以拉取为主的采集模型。它先通过 Kubernetes API 发现候选对象,再把元数据转换为标签,经过重标记规则筛选出真正目标,随后按抓取周期访问目标的 /metrics,最后将样本写入本地时序数据库。
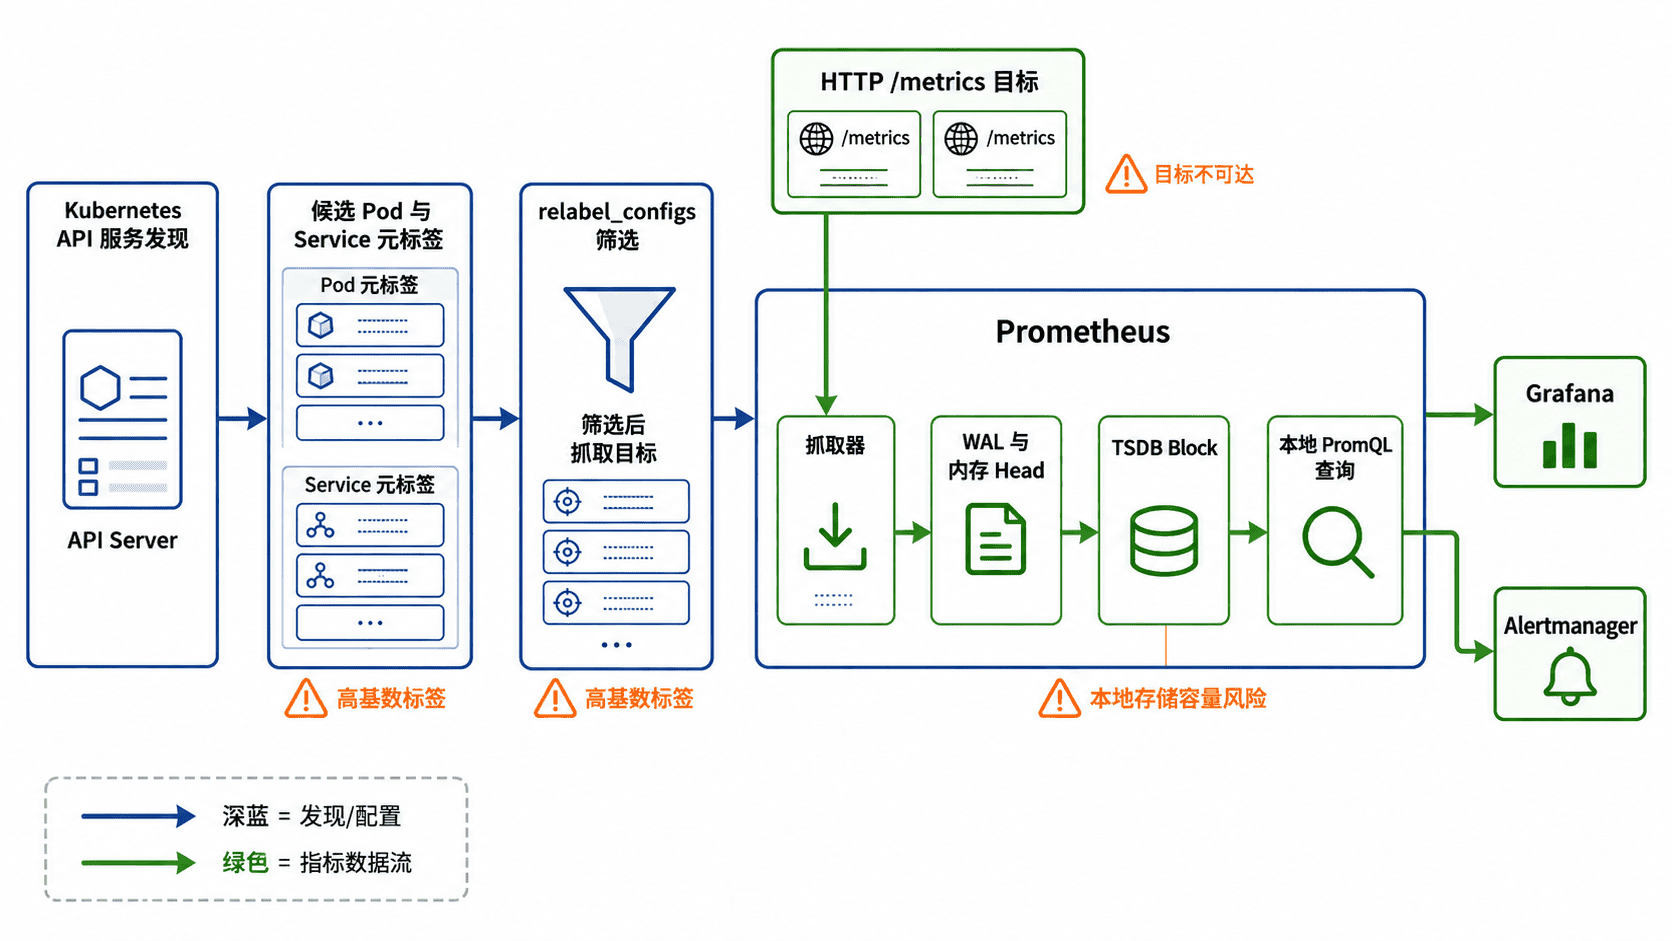
服务发现只回答“可能抓取谁”,不会自动保证目标暴露了有效指标。kubernetes_sd_configs 会持续监听 Kubernetes API,并为 Pod、Service、EndpointSlice、Node 等对象生成 __meta_kubernetes_* 元标签;relabel_configs 再利用这些标签保留、丢弃或改写候选目标。
下面是一个片段示例,需要放入 Prometheus 配置的 scrape_configs,并保证 Prometheus 使用的 ServiceAccount 具备读取 Pod 的 RBAC 权限。
scrape_configs:
  - job_name: kubernetes-pods
    kubernetes_sd_configs:
      - role: pod
    relabel_configs:
      - source_labels:
          - __meta_kubernetes_pod_annotation_prometheus_io_scrape
        action: keep
        regex: "true"
      - source_labels:
          - __meta_kubernetes_pod_ip
          - __meta_kubernetes_pod_annotation_prometheus_io_port
        action: replace
        separator: ":"
        target_label: __address__
        regex: "(.+);(.+)"
        replacement: "$1:$2"
      - source_labels:
          - __meta_kubernetes_pod_annotation_prometheus_io_path
        action: replace
        target_label: __metrics_path__
        regex: "(.+)"
生效后,只有带 prometheus.io/scrape: "true" 注解的 Pod 会被保留,抓取地址由 Pod IP 与注解端口拼接,路径可由注解覆盖。使用 Prometheus Operator 时,通常更适合通过 ServiceMonitor 或 PodMonitor 声明目标,而不是直接维护整份原生配置。
每到一个抓取周期,Prometheus 会向目标发送 HTTP 请求,并为样本附加时间戳和标签集合。新样本先进入 WAL 和内存 Head,随后压缩为磁盘 Block。标签集合唯一确定一条时间序列,因此把用户 ID、订单 ID 或完整 URL 放进标签会迅速制造高基数。
单机 Prometheus 的保留时间或容量限制决定本地可查询窗口;需要跨集群或长期保存时,应使用 remote_write 对接远端时序存储。两个 Prometheus 副本默认各自保存数据,不会自动合并或去重。
查询并验证采集结果
假设集群中已部署 kube-prometheus-stack,且 Prometheus Service 名称为 prometheus-kube-prometheus-prometheus。以下命令建立本地端口转发,并通过 HTTP API 查询内置指标 up。
kubectl -n monitoring port-forward svc/prometheus-kube-prometheus-prometheus 9090:9090 >/tmp/prometheus-port-forward.log 2>&1 &
sleep 2
curl -sG 'http://127.0.0.1:9090/api/v1/query' \
  --data-urlencode 'query=up'
预期输出
{"status":"success","data":{"resultType":"vector","result":[{"metric":{"job":"<JOB>","instance":"<INSTANCE>"},"value":[<UNIX_TIME>,"1"]}]}}Service 名称与结果条数会因安装方式不同而变化。<UNIX_TIME> 是实际查询时间戳。value 中的 "1" 表示该目标最近一次抓取成功,"0" 表示目标已被发现但抓取失败;若 result 为空,应检查目标是否进入发现列表、是否被重标记规则丢弃,以及指标端口和路径是否正确。
设计边界与排错顺序
Prometheus 与 Metrics Server 解决的问题不同:前者面向历史时序、PromQL、告警和仪表盘,后者主要提供 Kubernetes 资源指标 API。Horizontal Pod Autoscaler 可以使用资源指标,也可以通过适配器接入 Prometheus 自定义指标,但不能把两套组件简单视为替代关系。
排查监控缺口时应按“发现目标、重标记、网络连接、HTTP 响应、格式解析、写入存储”的顺序定位。只看到 Pod 运行并不能证明采集正常,up、目标状态和查询结果才是完整验收依据。