
容器与云原生 / 系统课时
Cluster Autoscaler
Cluster Autoscaler
本课解决工作负载已经无法调度、但集群节点数量仍固定的问题。你将掌握 Cluster Autoscaler 的扩缩容触发条件、节点组决策流程,以及在云环境中验证和排查节点扩容的方法。
学习目标
- 区分 Pod 扩缩容与节点扩缩容的职责
- 解释 Pending Pod 触发节点组扩容的完整链路
- 根据调度事件和 Autoscaler 日志定位未扩容原因
触发条件与流程
Cluster Autoscaler,简称 CA,调整的是节点组数量,而不是 Pod 副本数或单个节点规格。它通常与云厂商的实例组、虚拟机规模集或托管节点池集成,因此节点组必须允许修改期望容量,并配置最小与最大节点数。
扩容的直接信号不是节点 CPU 使用率升高,而是存在因资源或调度约束无法放置的 Pod。CA 会模拟把这些 Pod 放到各候选节点组的新节点上,只对“扩容后确实能够调度”的节点组增加容量。新节点注册并 Ready 后,Scheduler 才会重新绑定 Pending Pod。
缩容时,CA 会寻找利用率较低且可安全移除的节点,再模拟迁移其上的普通 Pod。PodDisruptionBudget、不可迁移的本地存储、关键系统 Pod、节点组最小值和调度约束都可能阻止删除。
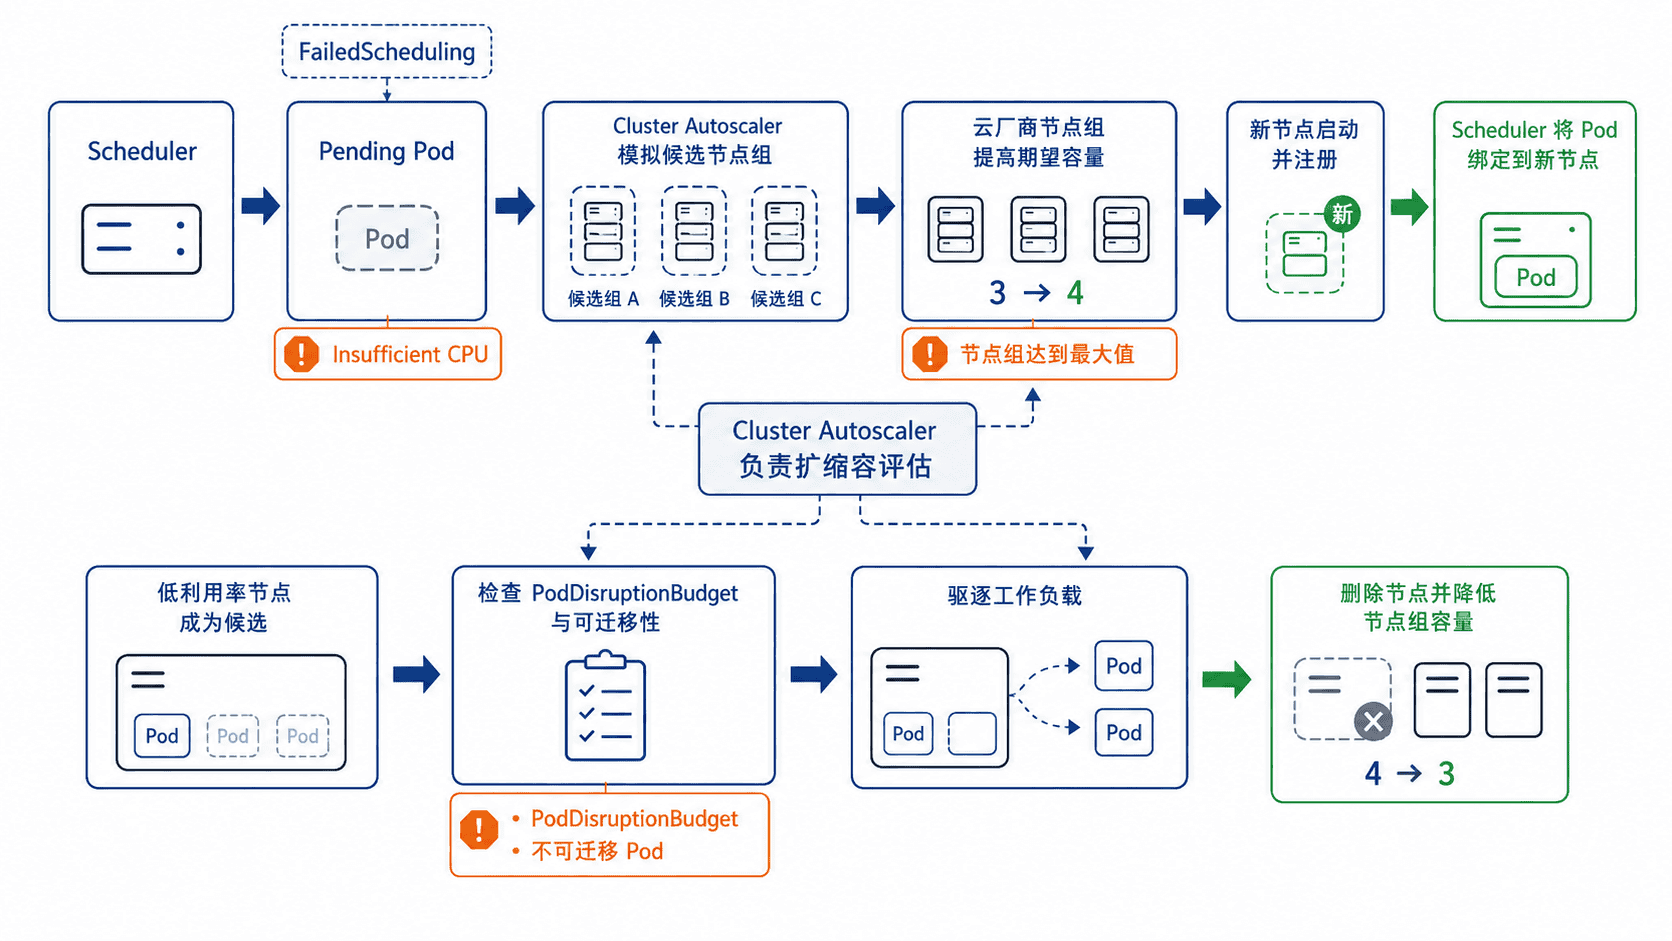
CA 适合具备标准节点组 API 的云环境或已实现对应 Provider Adapter 的平台。纯裸金属集群若没有可调用的机器供给系统,仅安装 CA 不会自动增加物理节点。
构造扩容测试
下面的 Deployment 创建 20 个 Pod,每个 Pod 请求 500m CPU。它用于制造可观察的调度压力;若现有集群仍有足够容量,可继续增加 replicas,但单个 Pod 的请求必须小于新节点的可分配资源,否则 CA 会判定扩容也无法解决问题。
apiVersion: apps/v1
kind: Deployment
metadata:
  name: ca-demo
spec:
  # 多副本制造总量压力,而不是让单个 Pod 大到无法放入新节点
  replicas: 20
  selector:
    matchLabels:
      app: ca-demo
  template:
    metadata:
      labels:
        app: ca-demo
    spec:
      containers:
        - name: pause
          image: registry.k8s.io/pause:3.10
          resources:
            # 单个 Pod 必须能放入节点组可能创建的新节点
            requests:
              cpu: 500m
              memory: 64Mi
将内容保存为 ca-demo.yaml 后执行:
# 创建压力负载,并同时观察 Pending Pod 与新增节点
kubectl apply -f ca-demo.yaml
kubectl get pods -l app=ca-demo
kubectl get nodes
当现有节点容量不足、节点组未达到最大值且 CA 已正确接入云平台时,预期结果类似:
deployment.apps/ca-demo created
NAME                       READY   STATUS    RESTARTS   AGE
ca-demo-<ID>               0/1     Pending   0          <AGE>
ca-demo-<ID>               1/1     Running   0          <AGE>
NAME                       STATUS   ROLES    AGE     VERSION
<OLD_NODE>                 Ready    <ROLE>   <AGE>   <VERSION>
<NEW_NODE> Ready <ROLE> <AGE> <VERSION><ID>、<AGE>、<ROLE> 和 <VERSION> 为动态值。新节点通常需要数分钟才能启动;在此期间 Pending Pod 数量会逐步减少。
缩容边界与排查
先从 Pending Pod 的调度事件判断问题是否真的能通过增加节点解决:
# 先确认调度原因,再检查 CA 进程与最近日志
kubectl describe pod <PENDING_POD> | sed -n '/Events:/,$p'
kubectl -n kube-system get pods | grep -i cluster-autoscaler
kubectl -n kube-system logs <CLUSTER_AUTOSCALER_POD> --since=10m
资源不足且 CA 正常运行时,预期输出应至少包含调度失败事件、Autoscaler Pod 状态和对应日志:
Warning  FailedScheduling  <TIME>  default-scheduler  0/<N> nodes are available: <N> Insufficient cpu.
cluster-autoscaler-<ID>     1/1     Running   0   <AGE>
<CLUSTER_AUTOSCALER_LOGS>
实际日志文本会因版本和云厂商实现不同而变化,应重点查找三类结论:Pod 在新节点上仍无法放置、节点组已达到最大值、云 API 调用或权限失败。若事件显示亲和性、污点、PVC 拓扑或端口冲突,单纯增加节点也可能无效。
缩容验证不能只看低利用率。还要检查目标节点上的 Pod 是否受 PDB 保护、是否使用不可迁移的本地数据、是否缺少其他可调度节点,以及节点组是否已经到达最小值。生产环境应为节点供给耗时、突发容量和关键工作负载保留安全余量。