
容器与云原生 / 系统课时
为什么需要容器编排
为什么需要容器编排
单个容器容易启动,但当应用扩展到多个服务、多个副本和多台主机后,部署位置、容量变化、故障替换与服务访问会互相影响。本课将说明容器编排为何出现,以及它怎样把一次性操作转变为持续维持系统期望状态的能力。
学习目标
- 识别容器规模扩大后的部署与运维难题。
- 理解期望状态和自动纠偏的基本机制。
- 判断简单脚本与编排平台的适用边界。
容器规模扩大后发生了什么
在开发机上运行一个容器,只需确定镜像、端口和环境变量。进入生产环境后,同一服务可能需要多个副本,并分布到不同主机上。此时团队必须决定副本放在哪里、如何被访问、升级时怎样不中断,以及某个实例失败后由谁补上。
实例地址和主机资源会持续变化。前端依赖后端,后端又依赖缓存或数据库;新副本启动后还要自动加入流量入口。人工维护主机、端口和进程清单,在规模增大后很快会出现遗漏与配置漂移。
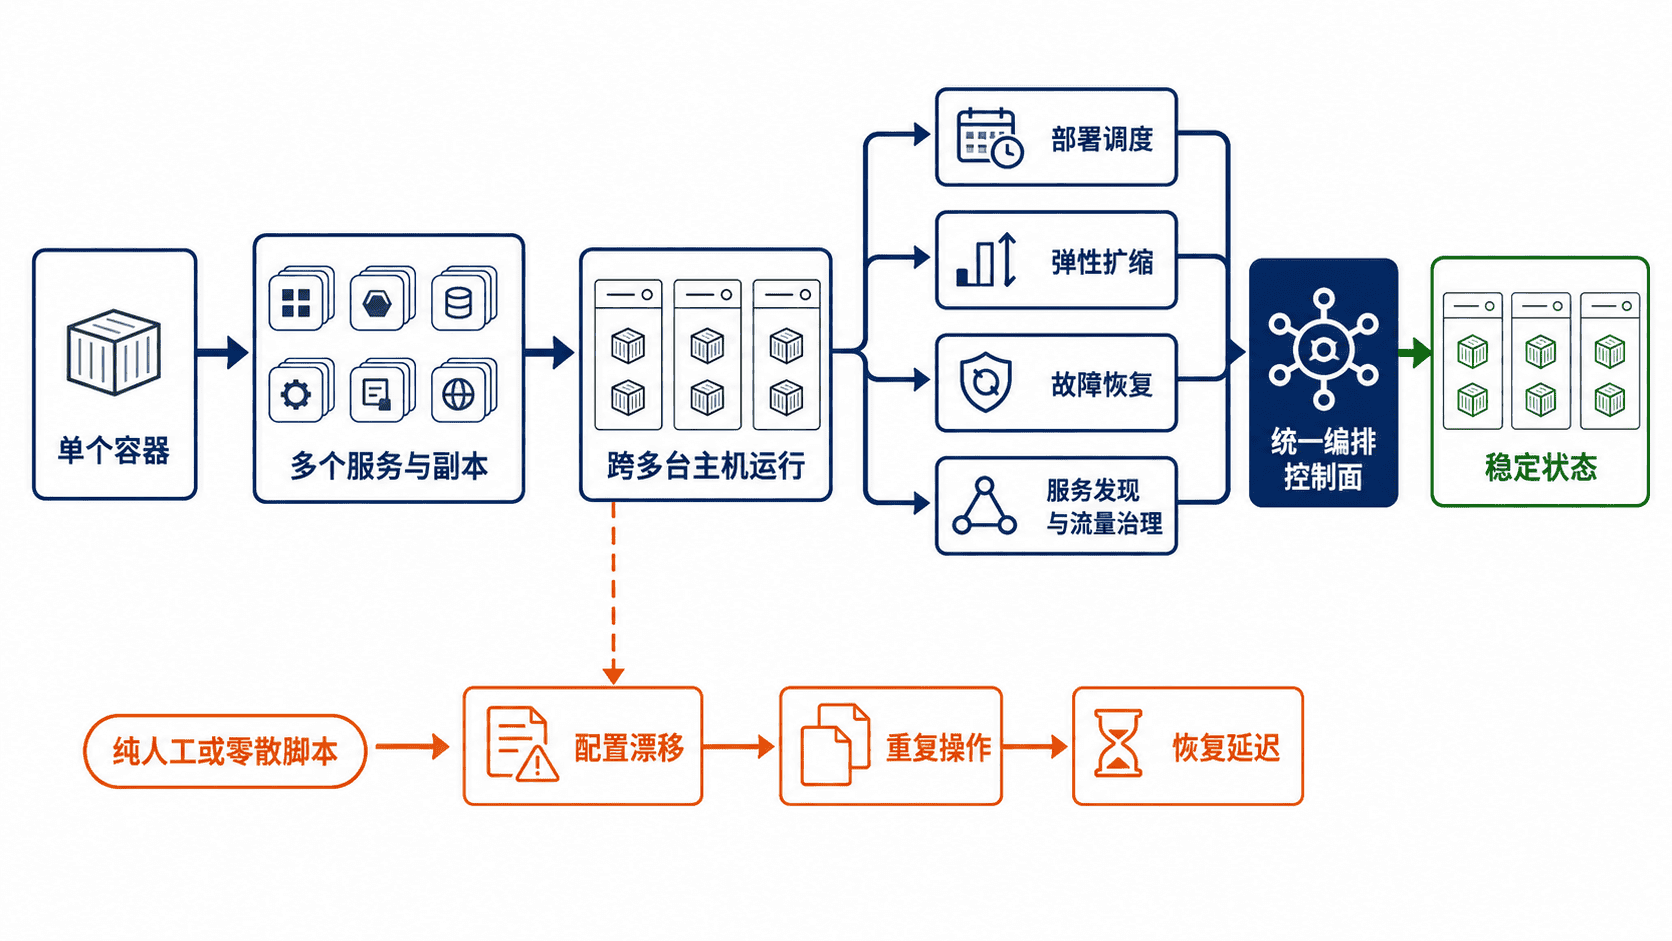
编排要解决的四类问题
- 部署与调度:根据 CPU、内存和约束条件,把实例放到合适主机,避免节点过载。
- 弹性扩缩:流量变化时调整副本数,并让新增实例自动加入服务入口。
- 故障恢复:检测容器或主机异常,移除故障实例并重新创建缺失副本。
- 服务治理:通过稳定名称、健康检查和流量转发,屏蔽实例地址变化。
这些问题彼此关联。扩容后需要重新分配流量,节点故障后需要重新调度,滚动升级时又要同时保证副本数量和服务可用性,因此不能只靠孤立工具分别处理。
为什么脚本不能替代持续控制
脚本适合执行确定的一次性任务,例如按顺序启动三个容器。但生产环境随时会变化:节点可能离线、镜像可能更新、负载也会波动。脚本通常只负责“执行一次”,不会长期观察实际状态并自动补偿偏差。
编排平台采用期望状态模型。团队声明某服务应运行多少副本、使用哪个镜像、开放哪些入口;控制系统持续比较期望状态与实际状态,发现缺少副本或实例异常时立即纠偏。这种控制循环让部署过程可重复、可审查,也更容易自动化。
什么时候值得引入编排平台
只有少量服务、单台主机且允许短暂停机时,容器运行工具加简单脚本通常更直接。完整编排平台还会带来网络、权限、监控、升级和集群维护成本,不应因为“使用容器”就立即引入。
当系统出现多主机部署、频繁发布、自动恢复、统一服务发现或弹性容量需求时,编排平台才开始产生明显收益。判断重点不是容器数量,而是人工流程是否已经无法稳定维持目标状态。
按自己的节奏,确认真正理解。