
容器与云原生 / 系统课时
Pod 生命周期与状态
Pod 生命周期与状态
Pod 的状态不能只看 STATUS 一列。本课建立“Pod 阶段、条件、容器状态”三层观察模型,解释重启策略与 CrashLoopBackOff 的关系,并通过一个会失败两次的容器验证状态和重启次数。
学习目标
- 区分 Pod phase、conditions 与容器 state。
- 理解
restartPolicy和重启退避的作用范围。 - 能用
kubectl定位 Pod 未就绪或反复重启的原因。
用三层状态观察 Pod
Pod 的 status.phase 只给出粗粒度阶段,包括 Pending、Running、Succeeded、Failed 和 Unknown。它适合判断大方向,但不能解释镜像拉取失败、探针未通过或容器刚刚退出等具体原因。
更精确的信息来自 status.conditions 与 containerStatuses。常见条件有 PodScheduled、Initialized、ContainersReady 和 Ready;每个容器则处于 Waiting、Running 或 Terminated,并附带原因、退出码、开始时间和重启次数。
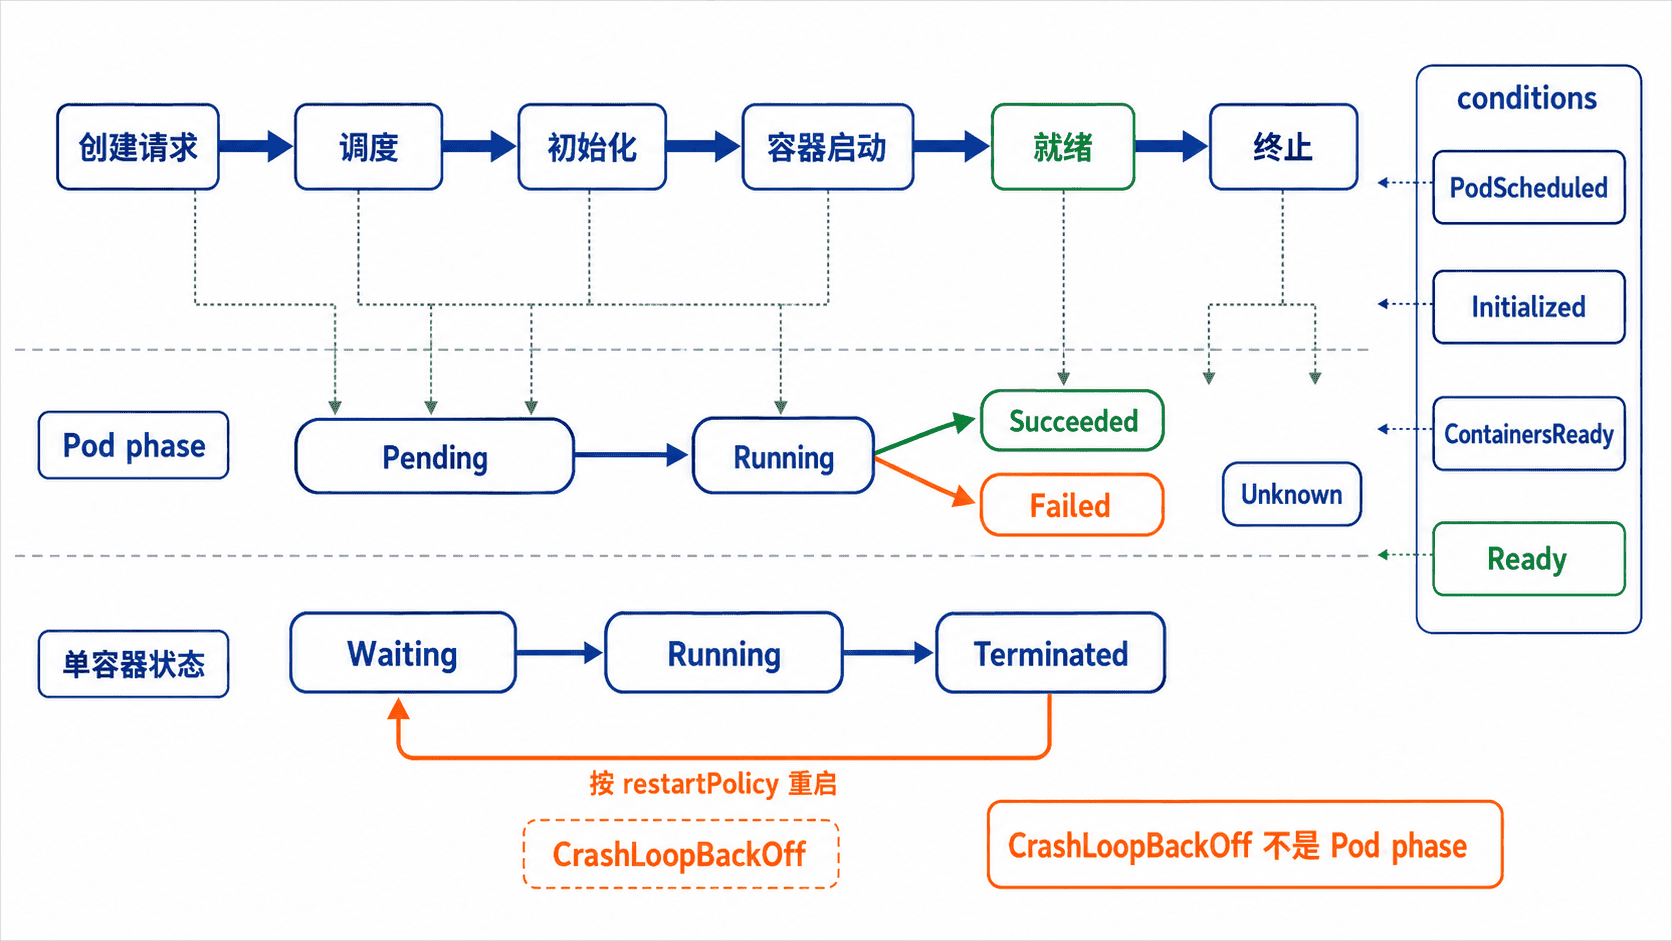
从创建到终止
Pod 对象写入 API Server 后,若尚未完成调度、镜像下载或初始化,通常处于 Pending。至少一个主容器正在运行、启动中或按策略重启时,Pod 可能显示为 Running;这并不等于业务已经就绪,仍需检查 Ready 条件和就绪探针。
所有容器正常退出且不会再重启时,phase 进入 Succeeded;至少一个容器异常退出且不会重启时,进入 Failed。Unknown 表示控制面暂时无法取得节点上的 Pod 状态,常见于节点通信异常,而不是一种正常业务阶段。
重启策略与退避
restartPolicy 只能设置为 Always、OnFailure 或 Never,并且作用于 Pod 内的普通容器。Always 会在容器退出后重启,OnFailure 只在退出码非零时重启,Never 不执行重启。控制器是否创建新 Pod,则属于更上层的行为。
容器连续失败时,kubelet 会逐步延长重启间隔。CrashLoopBackOff 是 kubectl 根据容器等待原因展示的状态,表示容器正处于失败重启与退避循环;Pod phase 此时通常仍是 Running,因此排查时必须继续查看退出码、事件和前一次日志。
创建可观察的重启示例
下面的容器把尝试次数写入 emptyDir。前两次启动主动以退出码 1 失败,第三次启动后保持运行。因为卷在容器重启之间保留,计数能够连续增加。
apiVersion: v1
kind: Pod
metadata:
  name: restart-demo
spec:
  restartPolicy: OnFailure
  volumes:
    - name: state
      emptyDir: {}
  containers:
    - name: worker
      image: busybox:1.36
      command:
        - sh
        - -c
        - |
          count=$(cat /state/count 2>/dev/null || echo 0)
          count=$((count + 1))
          echo "$count" > /state/count
          echo "attempt=$count"
          if [ "$count" -lt 3 ]; then
            exit 1
          fi
          echo "completed"
          sleep 3600
      volumeMounts:
        - name: state
          mountPath: /state
保存为 restart-demo.yaml 后执行:
kubectl apply -f restart-demo.yaml
kubectl wait --for=condition=Ready pod/restart-demo --timeout=120s
kubectl get pod restart-demo -o jsonpath='{.status.phase}{"\n"}{.status.containerStatuses[0].restartCount}{"\n"}'
kubectl logs restart-demo
预期输出:
pod/restart-demo created
pod/restart-demo condition met
Running
2
attempt=3
completed
镜像下载和退避等待时间会因环境而不同,但最终重启次数应为 2。此时 Pod phase 为 Running,说明 phase 只能描述整体阶段,真正的失败历史仍要从 restartCount、lastState 与日志中读取。
按固定顺序排查异常状态
先运行 kubectl get pod <NAME> -o wide 确认节点、Pod IP、READY 和重启次数,再用 kubectl describe pod <NAME> 查看 conditions、容器原因及 Events。若容器重启过,使用 kubectl logs <NAME> -c <CONTAINER> --previous 读取上一次实例的日志。
ImagePullBackOff 应优先检查镜像名、仓库权限和节点网络;Pending 且未调度时检查资源、亲和性、污点和 PVC;Running 但 Ready=False 时检查就绪探针与依赖服务。修复后应同时验证 Ready 条件、重启次数是否停止增长,以及业务请求是否成功。