
容器与云原生 / 系统课时
告警规则设计
告警规则设计
本课将把监控指标转化为可行动的告警。完成后,你会按节点、Pod、资源容量和应用可用性设计基础规则,理解 for、severity 与告警状态,并能在 PrometheusRule 部署后验证规则是否生效。
学习目标
- 按影响范围选择告警对象、阈值和持续时间
- 使用 PrometheusRule 编写 Kubernetes 基础告警
- 识别规则未生效、无数据和告警抖动等常见问题
先定义可行动的告警
有效告警必须同时说明异常对象、用户影响和首个处理动作。只因为某个指标“看起来很高”就告警,通常会产生噪声;应优先覆盖服务不可用、节点失联、Pod 持续崩溃和容量即将耗尽等可操作事件。
| 类别 | 触发条件 | 建议级别 | 首个动作 |
|---|---|---|---|
| 节点 | 持续处于 NotReady | critical | 检查 kubelet、网络和节点状态 |
| Pod | 持续 CrashLoopBackOff | warning | 查看容器日志与退出原因 |
| 容量 | 文件系统可用率低于 15% | warning | 清理数据或扩容磁盘 |
| 应用 | Prometheus 抓取目标持续不可达 | critical | 检查实例、Service 与探针 |
阈值应结合业务基线调整。critical 表示需要立即响应,warning 表示风险正在累积;严重级别不能只由数值大小决定,还要考虑影响范围和恢复窗口。
告警状态与通知链路
Prometheus 每个评估周期都会执行规则。表达式首次为真时,告警进入 Pending;持续达到 for 指定时间后进入 Firing;条件恢复后进入 Resolved。Alertmanager 再执行分组、抑制、静默和路由,最终把通知发送到接收渠道。
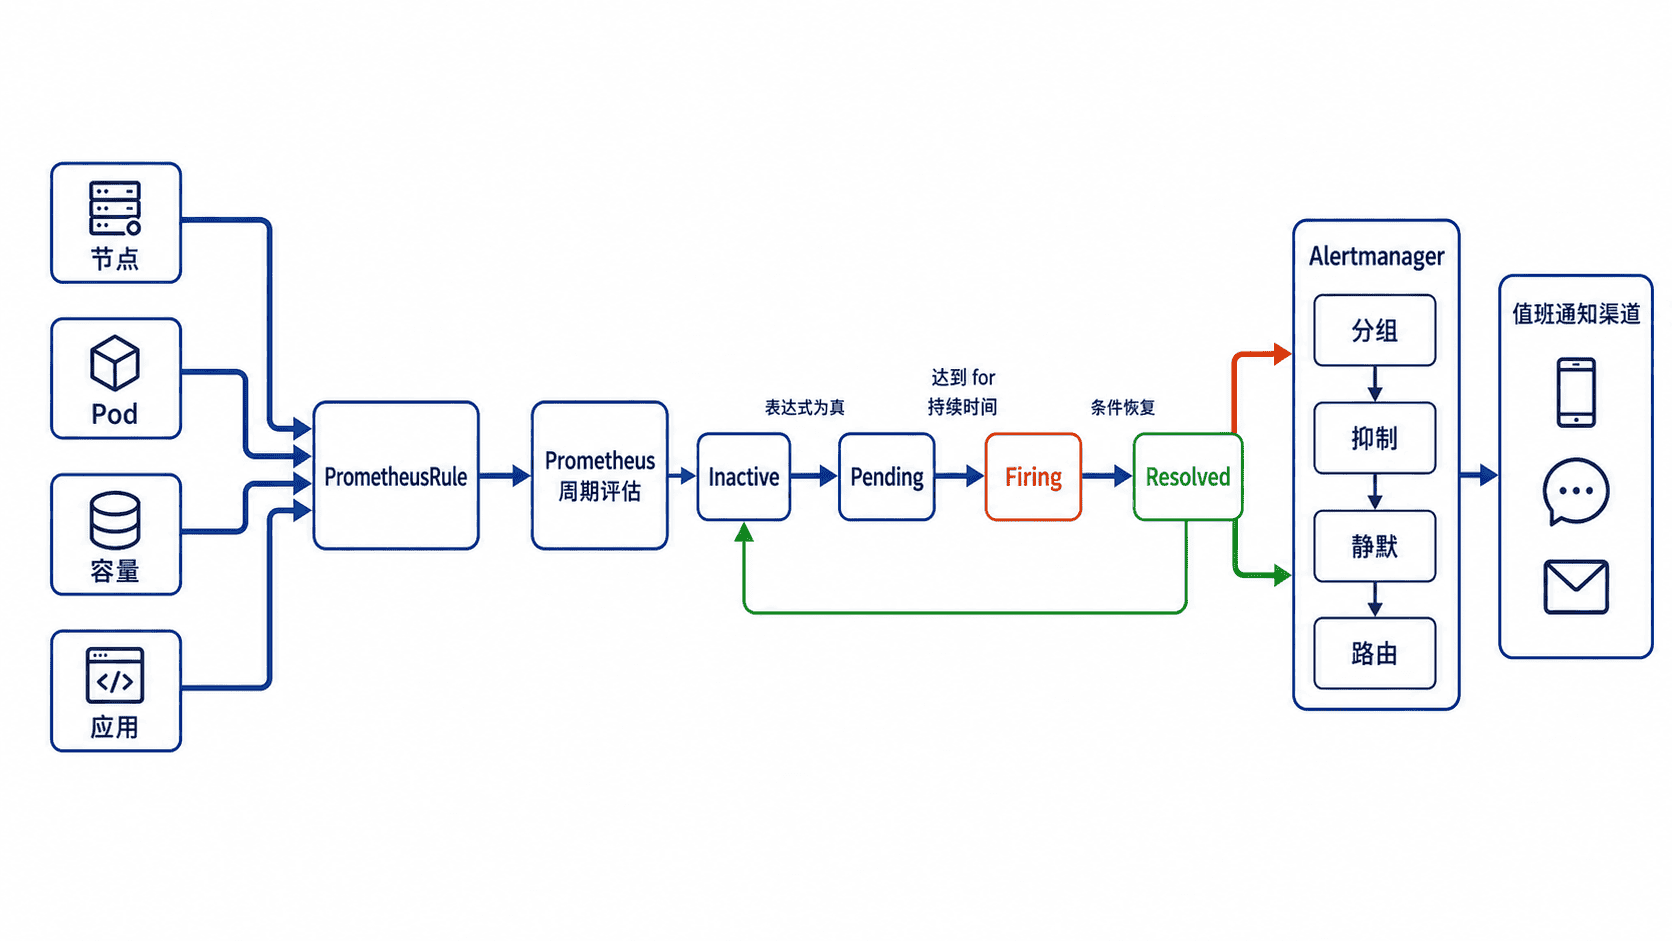
for 用于过滤瞬时波动,但不能替代合理阈值。过短会导致抖动,过长会延迟响应;节点失联通常可以等待数分钟确认,面向用户的关键接口不可用则应使用更短窗口。
编写基础 PrometheusRule
下面规则假设集群已安装 Prometheus Operator、node-exporter 和 kube-state-metrics。release 标签必须匹配 Prometheus 的 ruleSelector;应用可用性规则中的 job="demo-api" 也要替换为真实抓取任务。
apiVersion: monitoring.coreos.com/v1
kind: PrometheusRule
metadata:
  name: kubernetes-baseline
  namespace: monitoring
  labels:
    release: kube-prometheus-stack
spec:
  groups:
    - name: kubernetes-baseline.rules
      rules:
        - alert: NodeNotReady
          expr: kube_node_status_condition{condition="Ready",status="true"} == 0
          for: 10m
          labels:
            severity: critical
          annotations:
            summary: "节点 {{ $labels.node }} 未就绪"
            description: "节点持续 10 分钟未处于 Ready 状态。"

        - alert: PodCrashLooping
          expr: max_over_time(kube_pod_container_status_waiting_reason{reason="CrashLoopBackOff"}[5m]) >= 1
          for: 10m
          labels:
            severity: warning
          annotations:
            summary: "Pod {{ $labels.namespace }}/{{ $labels.pod }} 持续崩溃"
            description: "容器 {{ $labels.container }} 持续处于 CrashLoopBackOff。"

        - alert: NodeFilesystemSpaceLow
          expr: |
            (
              node_filesystem_avail_bytes{fstype!~"tmpfs|overlay"}
              /
              node_filesystem_size_bytes{fstype!~"tmpfs|overlay"}
            ) < 0.15
            and on (instance, device, mountpoint)
            node_filesystem_readonly == 0
          for: 15m
          labels:
            severity: warning
          annotations:
            summary: "节点 {{ $labels.instance }} 文件系统空间不足"
            description: "挂载点 {{ $labels.mountpoint }} 可用空间持续低于 15%。"

        - alert: ApplicationTargetDown
          expr: up{job="demo-api"} == 0
          for: 5m
          labels:
            severity: critical
          annotations:
            summary: "应用监控目标 {{ $labels.instance }} 不可达"
            description: "Prometheus 连续 5 分钟无法抓取 demo-api 目标。"
规则中的 for 会让短暂异常停留在 Pending,而不是立即通知。注解应描述事实与影响,标签用于路由;不要把大段排障步骤塞进通知正文,可增加 runbook_url 指向维护手册。
部署并验证规则
把配置保存为 alert-rules.yaml,先让 API Server 做服务端校验,再正式创建资源并检查对象是否存在。
kubectl apply --dry-run=server -f alert-rules.yaml
kubectl apply -f alert-rules.yaml
kubectl -n monitoring get prometheusrule kubernetes-baseline
预期输出
prometheusrule.monitoring.coreos.com/kubernetes-baseline created (server dry run)
prometheusrule.monitoring.coreos.com/kubernetes-baseline created
NAME                  AGE
kubernetes-baseline   <AGE>
资源已存在时,第二行可能显示 configured 或 unchanged。随后应在 Prometheus 的 Rules 页面确认四条规则已加载;若表达式当前为真,可观察它从 Pending 转为 Firing,实际等待时间由各规则的 for 决定。
降低噪声并处理失败
规则完全不出现时,优先检查 Prometheus 的 ruleSelector 与 metadata.labels 是否匹配。规则存在但显示 No data 时,应在 Prometheus 中单独执行 expr,确认指标名、标签和值域与当前采集组件一致。
频繁在 Firing 与 Resolved 之间切换,通常表示阈值过紧、窗口过短或指标本身波动大。可以增加 for、使用较长的 rate 窗口,或把告警改为面向用户影响的聚合指标。大量重复通知则应在 Alertmanager 中按 alertname、cluster、namespace 分组,并用抑制规则避免故障根因和派生症状同时轰炸值班人员。