
容器与云原生 / 系统课时
Grafana 可视化
Grafana 可视化
本课将把 Prometheus 中的 Kubernetes 指标整理成可读的 Grafana 监控视图。完成后,你能连接数据源,建立节点、Pod、容量与应用四类基础面板,并用变量和统一时间范围快速定位异常。
学习目标
- 理解 Prometheus、Grafana 与 Kubernetes 指标源之间的关系
- 配置 Prometheus 数据源并编写基础 PromQL 查询
- 设计可筛选、可验证的集群与工作负载仪表盘
从指标到监控视图
Grafana 不负责长期保存 Kubernetes 指标,它通过数据源查询 Prometheus,再把时间序列转换为折线图、仪表盘、状态值或表格。面板是否可信,取决于指标来源、PromQL 聚合维度、时间范围和单位设置是否一致。
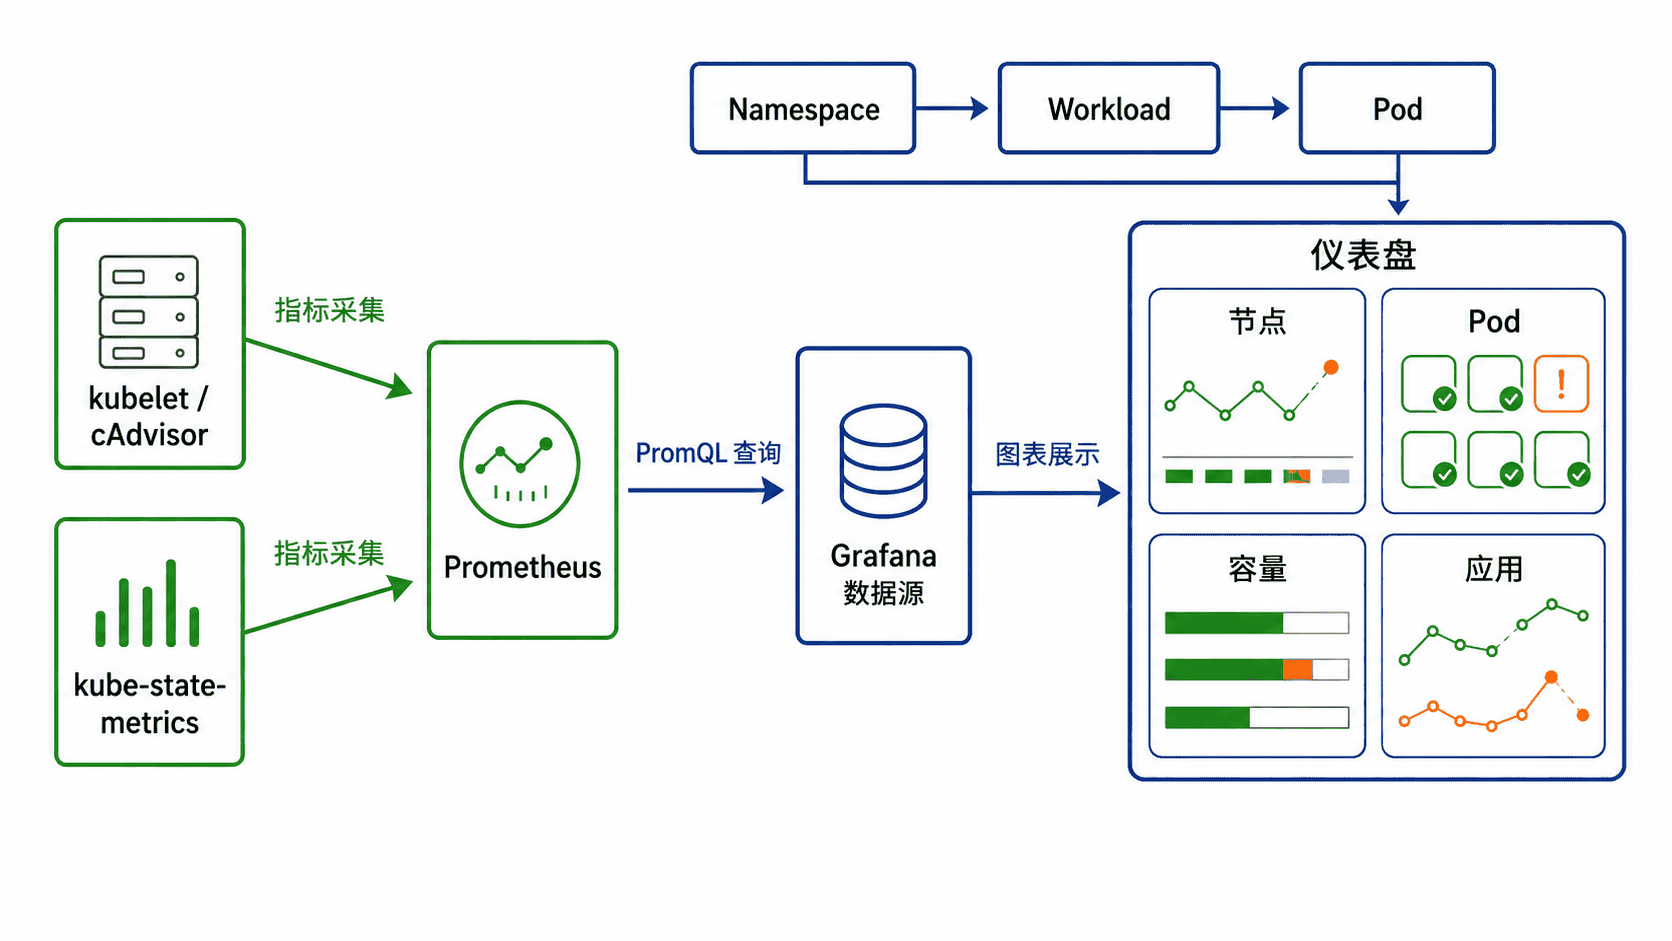
节点 CPU、容器内存等运行指标通常来自 node-exporter 和 kubelet/cAdvisor;Deployment 副本数、Pod 状态等对象指标通常来自 kube-state-metrics。设计面板前,应先确认 Prometheus 中确实存在对应指标。
配置 Prometheus 数据源
Grafana 可以通过 provisioning 文件自动创建数据源。下面配置把集群内 Prometheus Service 设置为默认数据源;实际 Service 名称或命名空间不同时,需要同步修改 url。
apiVersion: 1
datasources:
  - name: Prometheus
    uid: prometheus
    type: prometheus
    access: proxy
    url: http://prometheus-operated.monitoring.svc:9090
    isDefault: true
    editable: false
该文件通常挂载到 /etc/grafana/provisioning/datasources/。Grafana 重启后会按 uid=prometheus 创建数据源;可在 Explore 中执行 up,若返回目标时间序列,说明 Grafana 到 Prometheus 的查询链路正常。
设计四类基础面板
基础仪表盘应先回答“哪里异常、影响多大、对象是谁”,再补充细节。建议从节点、Pod、容量和应用可用性四个视角开始。
| 视角 | 核心问题 | 推荐查询 | 展示形式 |
|---|---|---|---|
| 节点 | CPU 是否持续偏高 | 100 - avg by(instance)(rate(node_cpu_seconds_total{mode="idle"}[5m])) * 100 |
时间序列 |
| Pod | 哪些 Pod 消耗 CPU 最多 | sum by(namespace,pod)(rate(container_cpu_usage_seconds_total{container!="",image!=""}[5m])) |
排序表格 |
| 容量 | 命名空间申请了多少内存 | sum by(namespace)(kube_pod_container_resource_requests{resource="memory",unit="byte"}) |
条形图 |
| 应用 | 监控目标是否可达 | avg by(job)(up) |
状态值 |
下面查询按节点计算 CPU 使用率。rate(...[5m]) 平滑短时抖动,avg by(instance) 汇总同一节点的 CPU 核心,最后把空闲率转换为使用率。
100 - (
  avg by (instance) (
    rate(node_cpu_seconds_total{mode="idle"}[5m])
  ) * 100
)
预期结果
每个 instance 返回一条 0~100 的时间序列;实际节点名称、数值和序列数量随集群变化。面板单位应设置为百分比,并把告警阈值附近的区间标为警示区域。不要把瞬时值和长期趋势混在同一面板,也不要在未聚合 container、pod 等标签时直接展示大量原始序列。
建立可复用筛选变量
变量让同一套面板适用于多个命名空间和工作负载。常见做法是先用 label_values(kube_pod_info, namespace) 生成 $namespace,再用 label_values(kube_pod_info{namespace="$namespace"}, pod) 生成依赖它的 $pod。
面板查询中使用 namespace=~"$namespace" 和 pod=~"$pod",可同时支持单选与多选。变量应提供“全部”选项,但要避免默认查询整个大集群造成高基数和慢查询;生产环境通常先限定命名空间,再展开到工作负载或 Pod。
验证图表是否可信
先把 Grafana 时间范围设为最近 30 分钟,再选择一个资源消耗明显的命名空间。可用 Metrics Server 的结果做相对排名对照,确认高消耗 Pod 在两处大致一致。
kubectl top pods -A --sort-by=cpu预期输出
NAMESPACE   NAME            CPU(cores)   MEMORY(bytes)
<NS>        <POD>           <CPU>m       <MEMORY>Mi
kubectl top 与 Prometheus 的采样周期、聚合窗口可能不同,因此数值不必完全相等。若排名差异很大,应检查查询标签、时间窗口、容器过滤条件和 Grafana 单位,而不是直接调整面板颜色掩盖问题。