
容器与云原生 / 系统课时
HorizontalPodAutoscaler
HorizontalPodAutoscaler
HorizontalPodAutoscaler(HPA)把指标采集、目标比较和副本调整连成闭环,使 Deployment 或 StatefulSet 能在设定范围内自动扩缩容。本课将配置 CPU 与内存指标、限制伸缩速度,并验证 HPA 是否正常工作。
学习目标
- 理解 HPA 从指标到副本数决策的完整链路
- 使用
autoscaling/v2配置多指标和伸缩行为 - 识别指标未知、扩容后 Pending 和副本数冲突等常见问题
HPA 的反馈闭环
HPA 控制器周期性读取资源指标、自定义指标或外部指标,再通过目标工作负载的 scale 子资源更新副本数。对单个指标,可用下面的直觉公式理解推荐值:
CPU 使用率型目标以容器实际 CPU 用量相对于 requests.cpu 的比例计算;缺少 CPU request 时,HPA 无法为相关 Pod 得到可靠的利用率。配置多个指标时,控制器分别计算建议副本数,并采用其中较大的结果,避免某个高压力指标被平均掉。
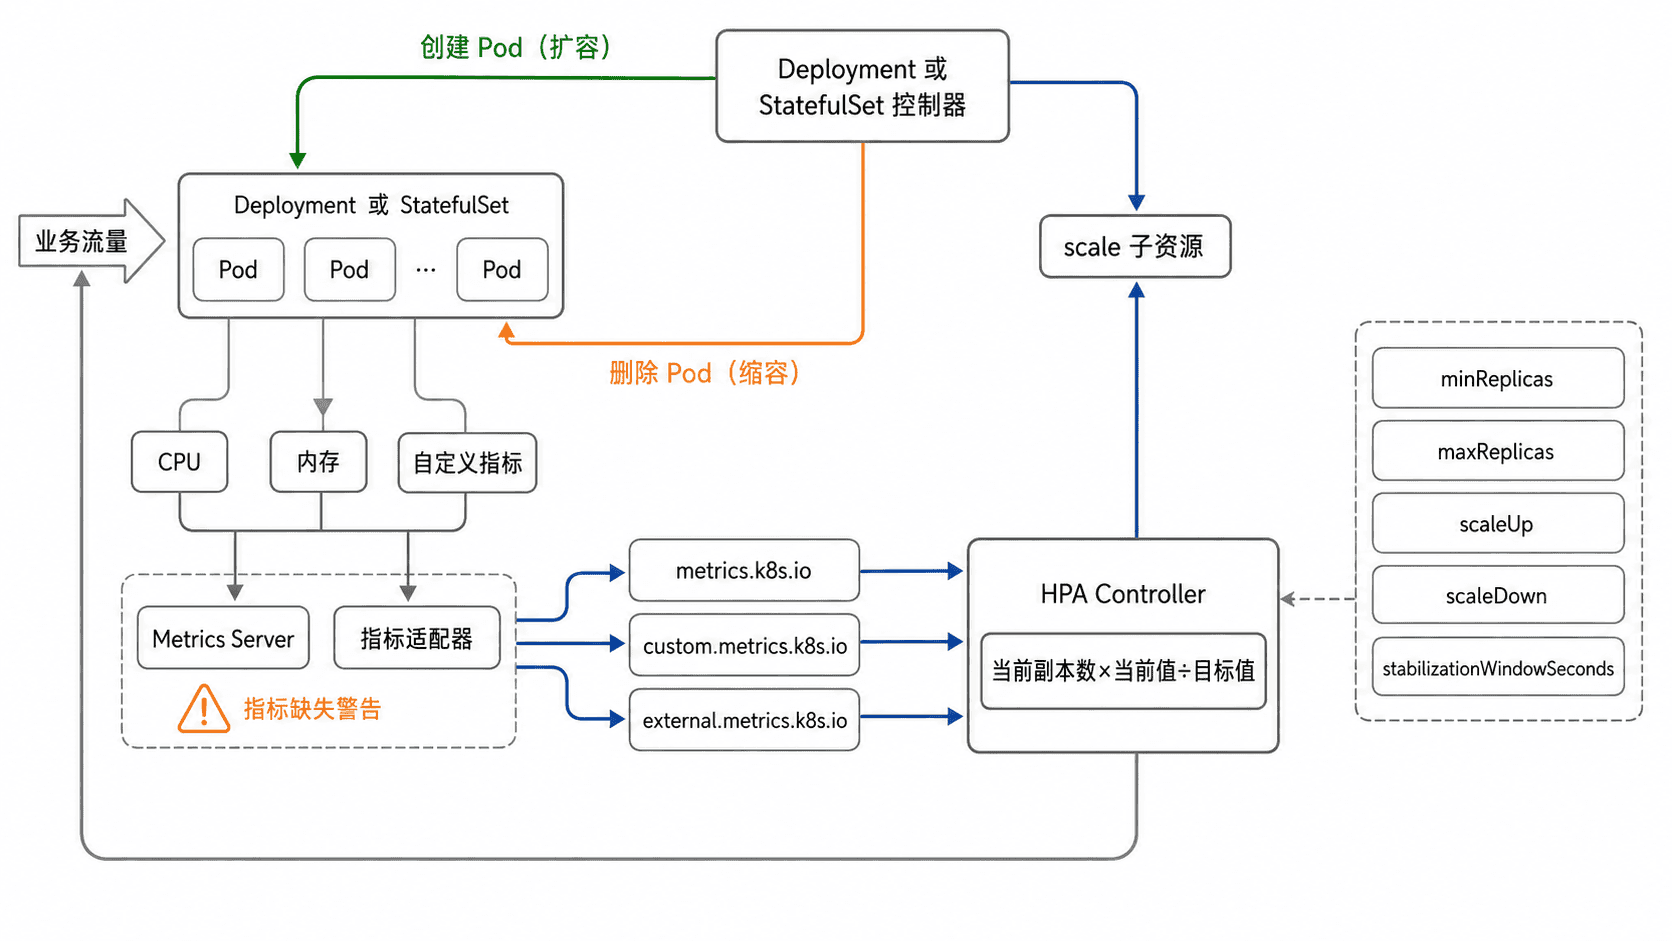
HPA 只调整 Pod 数量,不会自动增加节点。扩容后新 Pod 若因集群容量不足而 Pending,还需要节点自动扩缩容或人工增加容量。
检查指标前置条件
CPU、内存资源指标通常由 Metrics Server 提供。先确认聚合 API 可用,并能读取目标命名空间中的 Pod 指标:
kubectl get apiservice v1beta1.metrics.k8s.io
kubectl top pods -n demo
预期输出:
NAME                     SERVICE                      AVAILABLE   AGE
v1beta1.metrics.k8s.io   kube-system/metrics-server   True        <TIME>

NAME                       CPU(cores)   MEMORY(bytes)
web-<ID> <CPU>m <MEMORY>Mi<TIME>、<ID>、<CPU> 和 <MEMORY> 会随集群与负载变化。若 APIService 不可用或 kubectl top 报错,应先修复 Metrics Server、证书或网络问题。
目标 Deployment 的容器还应声明资源请求。下面是依赖现有 Deployment 的片段示例:
resources:
  requests:
    cpu: 100m
    memory: 128Mi
  limits:
    cpu: 500m
    memory: 512Mi
requests.cpu 是 CPU 利用率目标的计算基准;内存可以使用利用率或绝对平均值。应用完整 Deployment 清单后,可再次执行 kubectl top pods -n demo 验证指标是否出现。
创建多指标 HPA
下面的 HPA 将 demo/web 保持在 2~10 个副本之间:CPU 平均利用率目标为 60%,单 Pod 平均内存目标为 300Mi。扩容允许每分钟翻倍或增加 4 个 Pod,取更大的变化;缩容设置 300 秒稳定窗口,降低短时抖动造成的频繁回收。
apiVersion: autoscaling/v2
kind: HorizontalPodAutoscaler
metadata:
  name: web
  namespace: demo
spec:
  scaleTargetRef:
    apiVersion: apps/v1
    kind: Deployment
    name: web
  minReplicas: 2
  maxReplicas: 10
  metrics:
    - type: Resource
      resource:
        name: cpu
        target:
          type: Utilization
          averageUtilization: 60
    - type: Resource
      resource:
        name: memory
        target:
          type: AverageValue
          averageValue: 300Mi
  behavior:
    scaleUp:
      stabilizationWindowSeconds: 0
      selectPolicy: Max
      policies:
        - type: Percent
          value: 100
          periodSeconds: 60
        - type: Pods
          value: 4
          periodSeconds: 60
    scaleDown:
      stabilizationWindowSeconds: 300
      selectPolicy: Max
      policies:
        - type: Percent
          value: 25
          periodSeconds: 60
将清单保存为 hpa-web.yaml 并应用:
kubectl apply -f hpa-web.yaml预期输出:
horizontalpodautoscaler.autoscaling/web created重复应用时可能显示 configured 或 unchanged,这不影响对象继续工作。
验证伸缩结果
先读取 HPA 和当前 Pod。指标刚接入时可能短暂显示 <unknown>,正常情况下随后会出现当前值与目标值:
kubectl get hpa/web -n demo
kubectl get pods -n demo -l app=web
预期输出:
NAME   REFERENCE         TARGETS                         MINPODS   MAXPODS   REPLICAS   AGE
web    Deployment/web    <CPU>%/60%, <MEMORY>/300Mi      2         10        <N>        <TIME>

NAME                       READY   STATUS    RESTARTS   AGE
web-<ID> 1/1 Running 0 <TIME><CPU>、<MEMORY>、<N>、<ID> 和 <TIME> 都是动态值。向应用施加可控测试流量后,持续观察 REPLICAS 与 Pod 数量;CPU 或内存目标超过阈值时副本数应上升,负载回落并经过稳定窗口后才逐步下降。
HPA 支持的常见指标来源如下:
| 指标类型 | 典型用途 | 前置条件 |
|---|---|---|
| Resource | CPU、内存 | Metrics Server 与容器 requests |
| Pods | 每个 Pod 的请求率、队列长度 | Custom Metrics Adapter |
| Object | Ingress、Service 等对象指标 | Custom Metrics Adapter |
| External | 云队列、托管监控指标 | External Metrics Adapter |
常见失败与配置边界
TARGETS 长期为 <unknown> 时,先检查 Metrics API,再确认目标 Pod 是否有资源请求。HPA 事件出现无法获取指标时,不要盲目提高 maxReplicas,因为控制器没有可靠输入。
HPA 已增加期望副本但 Pod 为 Pending,根因通常在节点资源、调度约束或存储,而不在 HPA 算法。HPA 只负责提出副本目标,调度器仍需找到可用节点。
由 HPA 管理的工作负载不应同时被人工、GitOps 或其他控制器反复写入固定 spec.replicas,否则会产生来回覆盖。长期清单应把 HPA 作为副本数的主要控制者,并通过 minReplicas、maxReplicas 与 behavior 表达安全边界。