
容器与云原生 / 系统课时
Pod 启动故障排查
Pod 启动故障排查
本课建立一条可重复执行的 Pod 启动排查路径:先按状态分流,再依次检查事件、容器日志和工作负载配置。完成后,你能区分镜像、配置、资源与应用自身故障,并通过一次可复现实验把 ImagePullBackOff 修复到正常运行。
学习目标
- 根据
Pending、ImagePullBackOff、CrashLoopBackOff和未就绪状态选择排查入口。 - 使用
get、describe、events、logs与logs --previous收集关键证据。 - 按根因修改配置,并用滚动状态、就绪条件和事件确认修复有效。
先按 Pod 状态分流
不要一看到 Pod 异常就直接删除或重启。Pending 通常说明调度、PVC 或配额尚未满足;ImagePullBackOff 发生在容器启动前,应查镜像名、仓库和凭据;CrashLoopBackOff 表示进程已启动但反复退出,应查退出码和上一次日志;Running 但未 Ready 则重点检查探针和依赖服务。
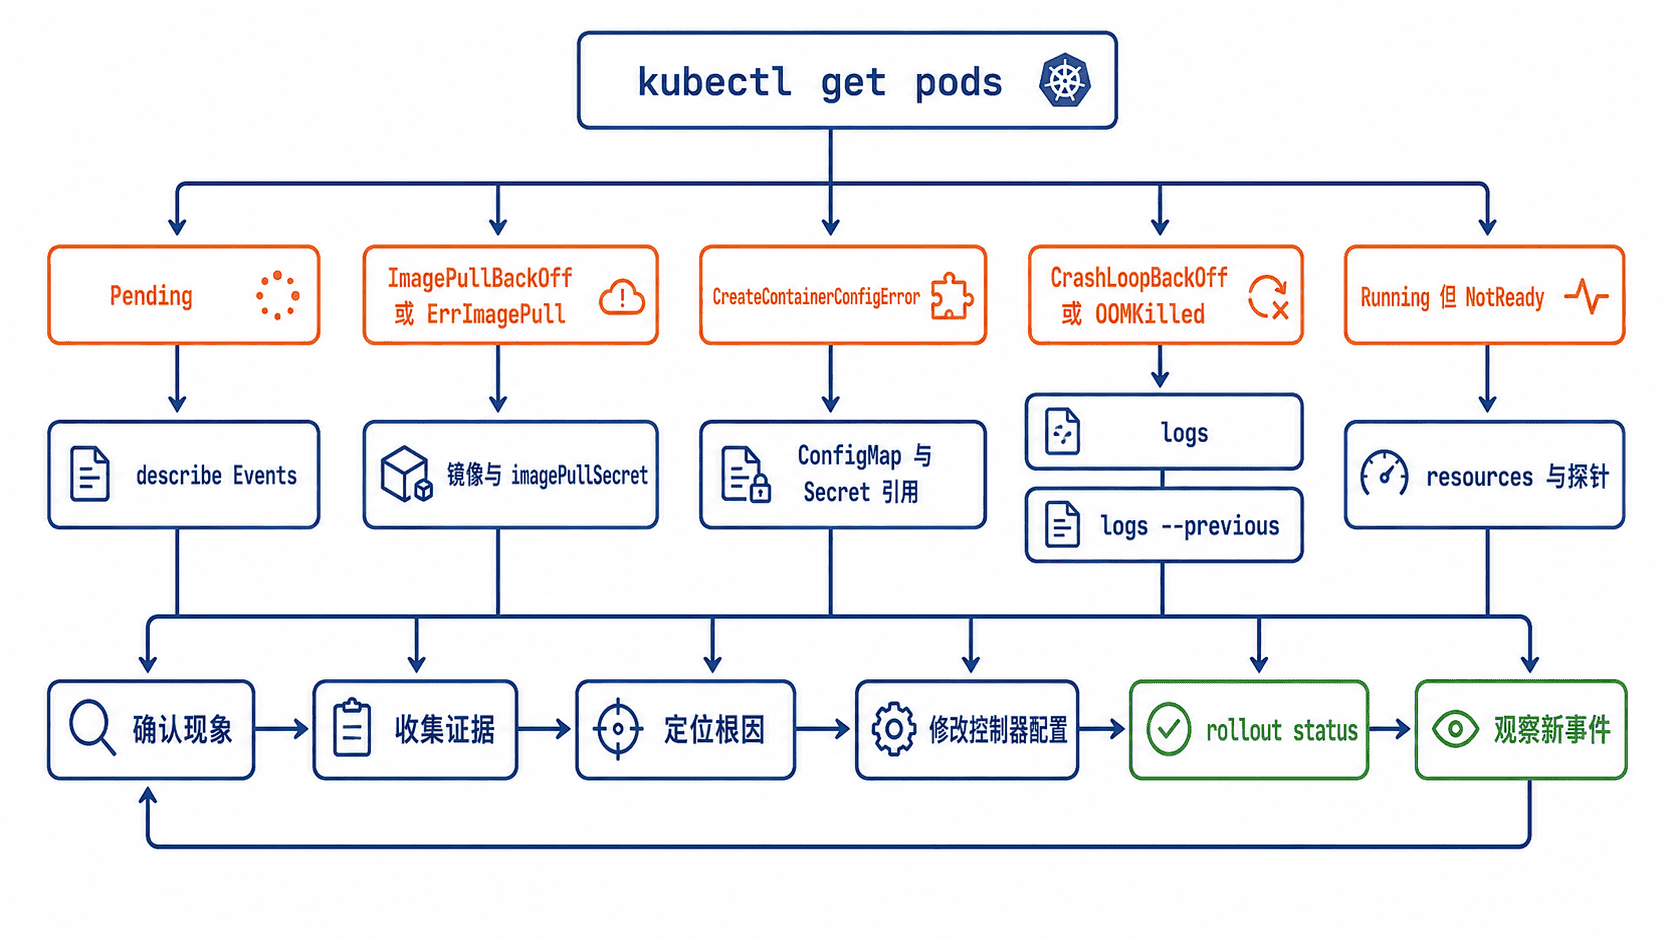
固定定位顺序:状态、事件、日志、配置
第一轮只收集证据,不修改资源。describe 的 Events 区域能解释调度、挂载、拉取和探针失败;当前日志用于查看正在运行的容器,--previous 用于读取上一次已经退出的容器实例,多容器 Pod 必须通过 -c 指定容器名。
kubectl get pod <POD> -n <NAMESPACE> -o wide
kubectl describe pod <POD> -n <NAMESPACE>
kubectl get events -n <NAMESPACE> --field-selector involvedObject.name=<POD> --sort-by=.metadata.creationTimestamp
kubectl logs <POD> -n <NAMESPACE> -c <CONTAINER> --tail=200
kubectl logs <POD> -n <NAMESPACE> -c <CONTAINER> --previous --tail=200
典型证据形态
STATUS: CrashLoopBackOff
Last State: Terminated
Reason: Error
Exit Code: 1
Events: Back-off restarting failed container
Previous Logs: <APPLICATION_ERROR>实际字段会因故障类型而不同。若容器从未成功创建,kubectl logs 可能返回没有可用日志,此时应以 describe 中的事件为主,而不是继续尝试重启。
四类高频根因与修复方向
| 现象 | 关键证据 | 常见根因 | 修复方向 |
|---|---|---|---|
ErrImagePull、ImagePullBackOff |
unauthorized、manifest unknown、超时 |
镜像标签错误、私有仓库凭据缺失、节点无法访问仓库 | 修正镜像摘要或标签,检查 imagePullSecrets、DNS、代理和仓库证书 |
CreateContainerConfigError |
找不到 Secret、ConfigMap 或键 | 资源未创建、命名空间不一致、键名写错 | 创建依赖资源,修正 envFrom、secretKeyRef、卷挂载引用 |
Pending |
FailedScheduling、PVC Pending |
CPU 或内存不足、污点不容忍、亲和性冲突、无可用存储 | 调整 requests、调度约束、容忍度或 StorageClass,必要时扩容节点 |
CrashLoopBackOff、OOMKilled |
非零退出码、上一次日志、内存终止原因 | 启动参数错误、依赖不可达、迁移失败、内存上限过低 | 修正应用配置和依赖,设置合理资源,必要时增加 startupProbe |
删除 Pod 只会让控制器创建一份相同配置的新 Pod,不能消除根因。应修改 Deployment、StatefulSet、Job 或其引用资源,再观察新副本是否恢复。
演练:修复 ImagePullBackOff
下面创建一个故意使用不存在镜像标签的 Deployment。将清单保存为 startup-demo.yaml,实验不会依赖业务镜像。
apiVersion: apps/v1
kind: Deployment
metadata:
  name: startup-demo
  namespace: troubleshoot-demo
spec:
  replicas: 1
  progressDeadlineSeconds: 60
  selector:
    matchLabels:
      app: startup-demo
  template:
    metadata:
      labels:
        app: startup-demo
    spec:
      containers:
        - name: web
          image: nginx:not-a-real-tag
          ports:
            - name: http
              containerPort: 80
创建命名空间并应用清单:
kubectl create namespace troubleshoot-demo --dry-run=client -o yaml | kubectl apply -f -
kubectl apply -f startup-demo.yaml
kubectl -n troubleshoot-demo rollout status deployment/startup-demo --timeout=30s
预期输出
namespace/troubleshoot-demo <CREATED_OR_CONFIGURED>
deployment.apps/startup-demo created
error: timed out waiting for the condition
取出 Pod 名称并查看事件。<ID> 和仓库返回文本是动态值,实际内容可能不同。
POD=$(kubectl -n troubleshoot-demo get pod -l app=startup-demo -o jsonpath='{.items[0].metadata.name}')

kubectl -n troubleshoot-demo get pod "$POD"
kubectl -n troubleshoot-demo describe pod "$POD" | sed -n '/Events:/,$p'
预期结果
NAME                    READY   STATUS             RESTARTS   AGE
startup-demo-<ID>       0/1     ImagePullBackOff   0          <AGE>

Failed to pull image "nginx:not-a-real-tag": <REGISTRY_ERROR>
Back-off pulling image "nginx:not-a-real-tag"
事件已经证明根因是镜像标签不存在,因此直接修改 Deployment,而不是删除 Pod。控制器会用新模板滚动创建副本。
kubectl -n troubleshoot-demo set image deployment/startup-demo web=nginx:1.27-alpine

kubectl -n troubleshoot-demo rollout status deployment/startup-demo --timeout=180s

kubectl -n troubleshoot-demo get pods -l app=startup-demo
预期输出
deployment.apps/startup-demo image updated
deployment "startup-demo" successfully rolled out
NAME                    READY   STATUS    RESTARTS   AGE
startup-demo-<ID>       1/1     Running   0          <AGE>
修复后的验收
修复不是看到一次 Running 就结束。应确认期望副本全部 Available、Ready 条件稳定、事件中不再产生新的 Warning,并检查应用端口或健康接口。对于崩溃类故障,还要确认新容器日志不再出现原始错误,且 --previous 不再对应新的失败实例。
kubectl -n <NAMESPACE> rollout status deployment/<DEPLOYMENT> --timeout=180s

kubectl -n <NAMESPACE> get pods -l app=<APP> -o custom-columns='NAME:.metadata.name,READY:.status.containerStatuses[*].ready,RESTARTS:.status.containerStatuses[*].restartCount,PHASE:.status.phase'

kubectl get events -n <NAMESPACE> --sort-by=.metadata.creationTimestamp
预期结果
deployment "<DEPLOYMENT>" successfully rolled out
NAME       READY   RESTARTS   PHASE
<POD>      true    0          Running
<NO_NEW_WARNING_EVENTS_FOR_THIS_WORKLOAD>
若重启次数持续增长或新的 Warning 继续出现,说明根因尚未消除,应回到事件和上一次日志重新定位,而不是扩大重启范围。