
大模型应用开发 / 系统课时
排查调用失败
排查调用失败
大模型调用失败时,先不要直接增加重试次数。本节建立一条从 HTTP 状态、请求参数到网络与服务端的定位路径,帮助你区分鉴权、参数、限流、超时、连接中断和服务不可用,并在修复后完成可重复验证。
学习目标
- 根据状态码和异常位置快速缩小故障范围
- 判断哪些失败可以重试,哪些必须先修改请求
- 使用最小请求验证鉴权、网络和服务恢复情况
先判断失败发生在哪一层
一次模型调用可以粗分为请求构造、建立连接、服务端处理和响应读取四段。拿到明确 HTTP 响应时,优先分析状态码和响应体;连 HTTP 状态都没有时,则先检查 DNS、TLS、代理、连接超时和连接重置。
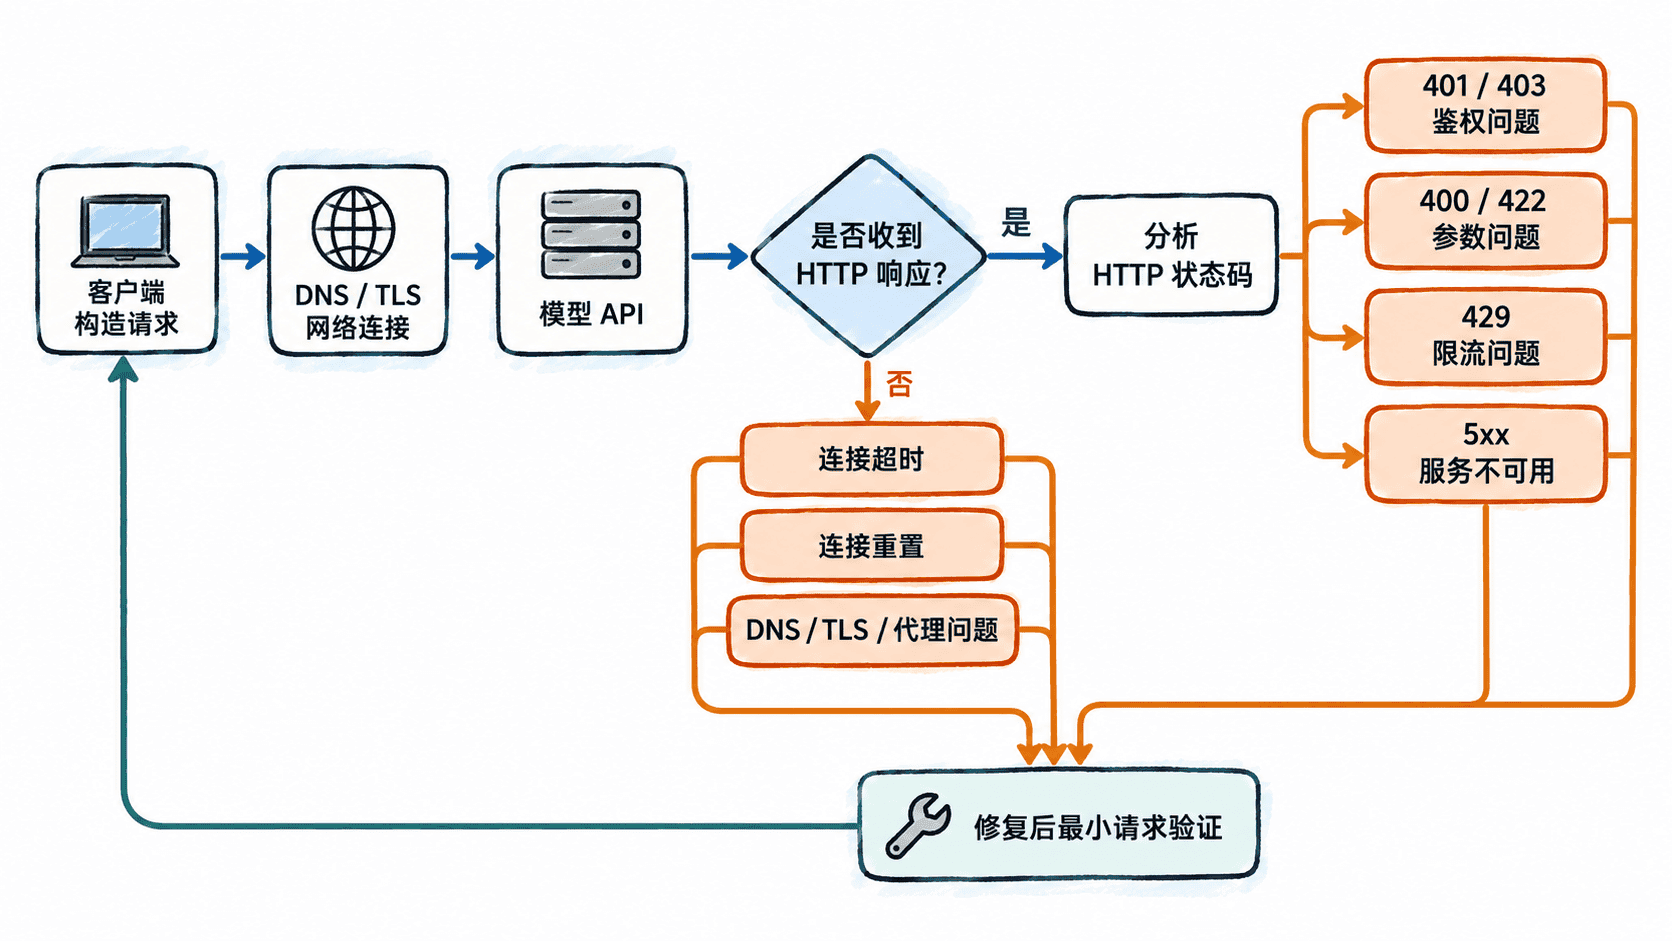
最常见的判断可以压缩为以下几类:
| 现象 | 优先检查 | 通常处理 |
|---|---|---|
401、403 |
API Key、权限、项目或组织范围 | 修正凭据,不盲目重试 |
400、422 |
JSON、模型名、参数类型与范围 | 修改请求后重新发送 |
429 |
请求频率、并发、配额 | 退避重试并限制并发 |
| 请求超时 | 客户端超时、模型耗时、上下文大小 | 调整超时并缩小请求验证 |
| 连接中断 | 网络、代理、连接复用、流式读取 | 建立新连接后有限重试 |
500~599 |
服务端暂时异常 | 退避重试或切换降级路径 |
用最小请求复现问题
业务代码往往混入检索、工具调用、流式输出和重试逻辑。排障时应先绕开这些附加层,只保留同一网络环境、同一凭据和一个最小请求。下面脚本使用 Python 标准库发送 JSON,并把 HTTP 错误与网络异常分开打印。
import json
import os
import urllib.error
import urllib.request

endpoint = os.environ["LLM_ENDPOINT"]
api_key = os.environ["LLM_API_KEY"]
payload = json.loads(os.environ.get("LLM_REQUEST_JSON", '{"input":"ping"}'))

data = json.dumps(payload).encode("utf-8")
request = urllib.request.Request(
    endpoint,
    data=data,
    headers={
        "Authorization": f"Bearer {api_key}",
        "Content-Type": "application/json",
    },
    method="POST",
)

try:
    with urllib.request.urlopen(request, timeout=30) as response:
        print(f"status={response.status}")
        print(f"body={response.read().decode('utf-8')}")
except urllib.error.HTTPError as exc:
    print(f"status={exc.code}")
    print(f"body={exc.read().decode('utf-8', errors='replace')}")
except urllib.error.URLError as exc:
    print(f"network_error={exc.reason}")
except TimeoutError:
    print("network_error=timeout")
保存为 diagnose_llm.py 后,传入实际服务地址、凭据和该服务支持的最小请求体:
LLM_ENDPOINT='<BASE_URL>/<PATH>' \
LLM_API_KEY='<VALUE>' \
LLM_REQUEST_JSON='{"input":"ping"}' \
python diagnose_llm.py
预期输出是在服务正常且请求格式正确时得到成功状态;响应体结构由实际模型服务决定:
status=200
body=<VALUE>
如果这里仍返回 401、400 或 429,问题就在应用业务逻辑之外,应直接根据状态码处理。若最小请求成功,而完整应用失败,再逐层恢复流式输出、结构化参数、工具调用和业务中间件,直到定位到引入故障的那一层。
为可恢复错误设置重试边界
重试应限定在具有恢复可能的错误上。连接瞬断、429 和部分 5xx 可以采用指数退避,并增加随机抖动,避免大量实例同时再次请求;参数错误和权限错误则应立即失败并记录原因。
重试还必须设置总时间预算。例如单次调用最多允许 20 秒时,不应配置五次各 20 秒的尝试,否则上游看到的实际延迟可能超过一分钟。流式响应已经输出部分内容后连接中断,也不能简单从头重放,否则用户可能收到重复文本或重复工具操作。
修复后完成闭环验证
修复不能以“错误日志消失”作为结束。先重新运行最小请求,确认状态和响应正常;再恢复真实模型、主要参数和正常上下文;最后在应用入口验证超时、限流和降级逻辑都按预期工作。
同时保留一次故障样本中的时间、调用阶段、HTTP 状态、异常类型、模型名和本地关联 ID。API Key、完整用户输入和敏感响应不要直接写入普通日志。这样下一次出现同类问题时,可以先按证据归类,而不是从重启服务或无限重试开始。