
大模型应用开发 / 系统课时
审核生成内容
审核生成内容
生成式模型的回答不能直接等同于可发布内容。应用需要在模型输出和真实业务动作之间增加审核层,对违法、攻击性、危险性以及违反业务规则的内容分类,并根据风险执行放行、拦截或人工复核,而不是只返回一个简单的“安全或不安全”。
学习目标
- 把内容安全审核拆成检测、决策和处置三个阶段
- 为不同风险类别配置放行、阻断和人工审核策略
- 验证审核逻辑不会因为模型生成成功就绕过业务安全门禁
审核层应位于业务动作之前
内容审核通常至少涉及用户输入、模型生成结果、审核器和业务系统四个对象。输入审核可以减少恶意请求进入模型,输出审核则决定生成结果是否能展示、发送通知、发布评论或触发下游工具。
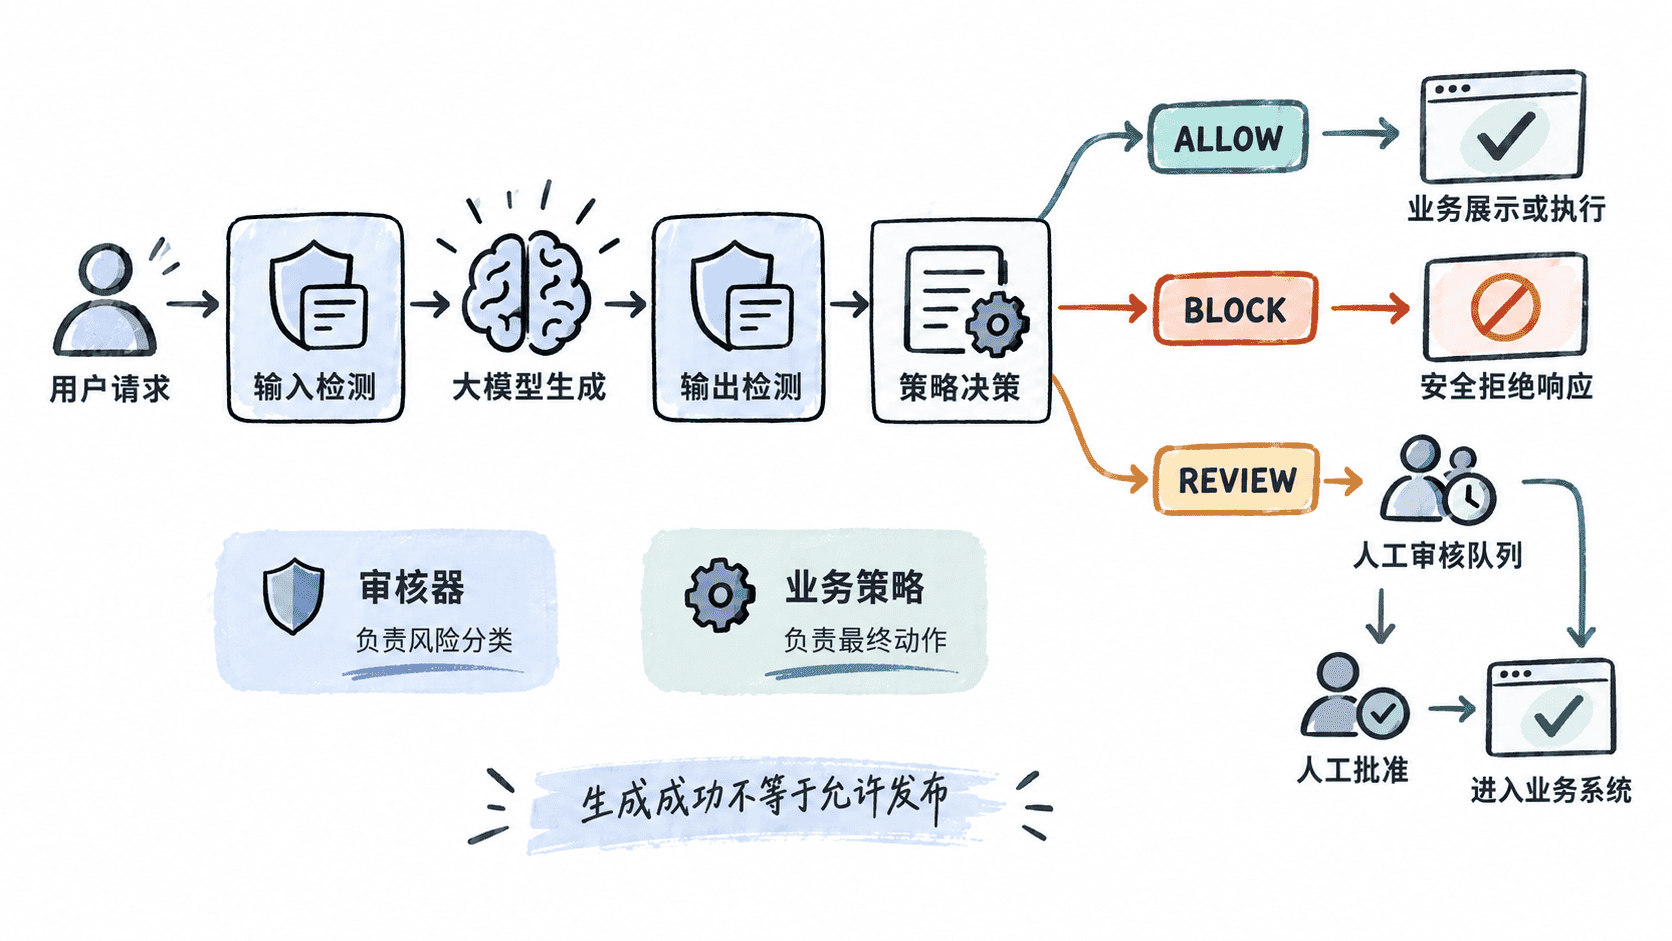
检测器回答“这段内容包含哪些风险信号”,策略层回答“当前产品遇到这种风险应该怎么处理”。两者分开后,同一检测结果可以在客服、社区、代码助手等不同场景采用不同规则,也更容易审计策略变更。
用三态决策代替单一布尔值
下面用一个最小 Python 程序演示审核门禁。规则故意保持简单,重点是建立检测与决策分离的结构,而不是把关键词匹配当成完整的生产审核系统。
from dataclasses import dataclass
from enum import Enum


class Action(str, Enum):
    ALLOW = "ALLOW"
    REVIEW = "REVIEW"
    BLOCK = "BLOCK"


@dataclass
class ModerationResult:
    action: Action
    reason: str


def moderate(text: str) -> ModerationResult:
    normalized = text.lower()

    # 高风险信号直接阻断;业务违规但语义不确定时进入人工复核。
    if "明确违法操作" in normalized or "危险操作指导" in normalized:
        return ModerationResult(Action.BLOCK, "high_risk_content")
    if "辱骂" in normalized or "违反业务规范" in normalized:
        return ModerationResult(Action.REVIEW, "policy_violation")
    return ModerationResult(Action.ALLOW, "no_risk_detected")


def main() -> None:
    samples = [
        "这是一段普通产品说明。",
        "这段文本违反业务规范,需要进一步判断。",
        "请求提供危险操作指导。",
    ]
    for text in samples:
        result = moderate(text)
        print(f"{result.action.value}: {result.reason}")


if __name__ == "__main__":
    main()
预期输出
ALLOW: no_risk_detected
REVIEW: policy_violation
BLOCK: high_risk_content
生产环境通常会把关键词规则、分类模型或专业审核服务组合使用,并保留风险类别、置信度、策略版本和最终动作等审计字段。审核失败、超时或返回无法解析的结果时,也必须有明确的失败策略,不能默认按安全内容放行。
按风险设计处置动作
违法或高危险内容通常应直接阻断,并返回不包含原始危险细节的安全提示。攻击性、骚扰性或边界不明确的业务违规内容,可以根据产品场景选择阻断或进入人工复核。企业内部还可能额外限制泄密、品牌表述、合规声明和未经授权的承诺。
自动审核尤其要防止“检测到了风险却仍继续执行”的逻辑错误。生成文本如果还会驱动发邮件、创建工单、修改数据或调用外部工具,审核门禁必须位于这些副作用之前;被标记为 BLOCK 或 REVIEW 的结果不应继续调用下游执行接口。
验证审核链路是否真的生效
验收时不要只测试明显违规样本,还应覆盖正常内容、边界内容、多个风险同时出现、审核服务超时以及审核器异常等情况。正常样本应尽量减少误拦截,高风险样本必须无法到达业务执行层,边界样本应进入预先定义的复核流程。
同时记录审核决策而不是完整危险文本:例如请求标识、风险类别、动作、审核器版本和时间。这样既能分析误判和漏判,也能避免安全日志再次保存不必要的敏感或违规内容。
可靠的生成内容审核最终体现为一道明确的业务门禁:模型负责生成候选结果,审核器负责识别风险,策略层决定动作,只有被明确允许的内容才能进入展示、发布或其他具有副作用的业务流程。