
大模型应用开发 / 系统课时
管理多模态文件
管理多模态文件
图片、音频、视频和文档一旦进入大模型应用,就需要同时处理格式、大小、存储、权限、有效期和敏感信息。本节用一套文件生命周期策略,把“能上传”提升为“可控、可追踪、可清理”。
学习目标
- 为多模态文件定义格式、大小与访问控制规则
- 设计上传、存储、授权、过期和删除的生命周期
- 在送入模型前完成敏感信息检查与最小化处理
先建立文件入口规则
文件上传的第一道门禁应放在进入业务存储之前。至少检查 MIME 类型、扩展名、文件大小和实际内容特征,不能只相信客户端传来的文件名或 Content-Type。
例如,产品只允许图片、PDF 和短音频时,可以先把策略写成配置。下面是配置示例,不直接执行。
uploadPolicy:
  maxBytes: 20971520
  allowedMimeTypes:
    - image/jpeg
    - image/png
    - application/pdf
    - audio/mpeg
  rejectDoubleExtensions: true
  quarantineUnknownFiles: true
这份策略把单文件上限设为 20 MiB,并拒绝不在白名单内的 MIME 类型。生效后要用允许和禁止的样例文件分别验证:合法文件进入后续流程,超限或未知类型文件在持久化前被拒绝或隔离。
把文件当作有生命周期的资源
上传成功并不等于永久保存。更合理的状态通常包括临时接收、校验通过、可访问、即将过期和已删除,且每次状态变化都应由明确条件触发。
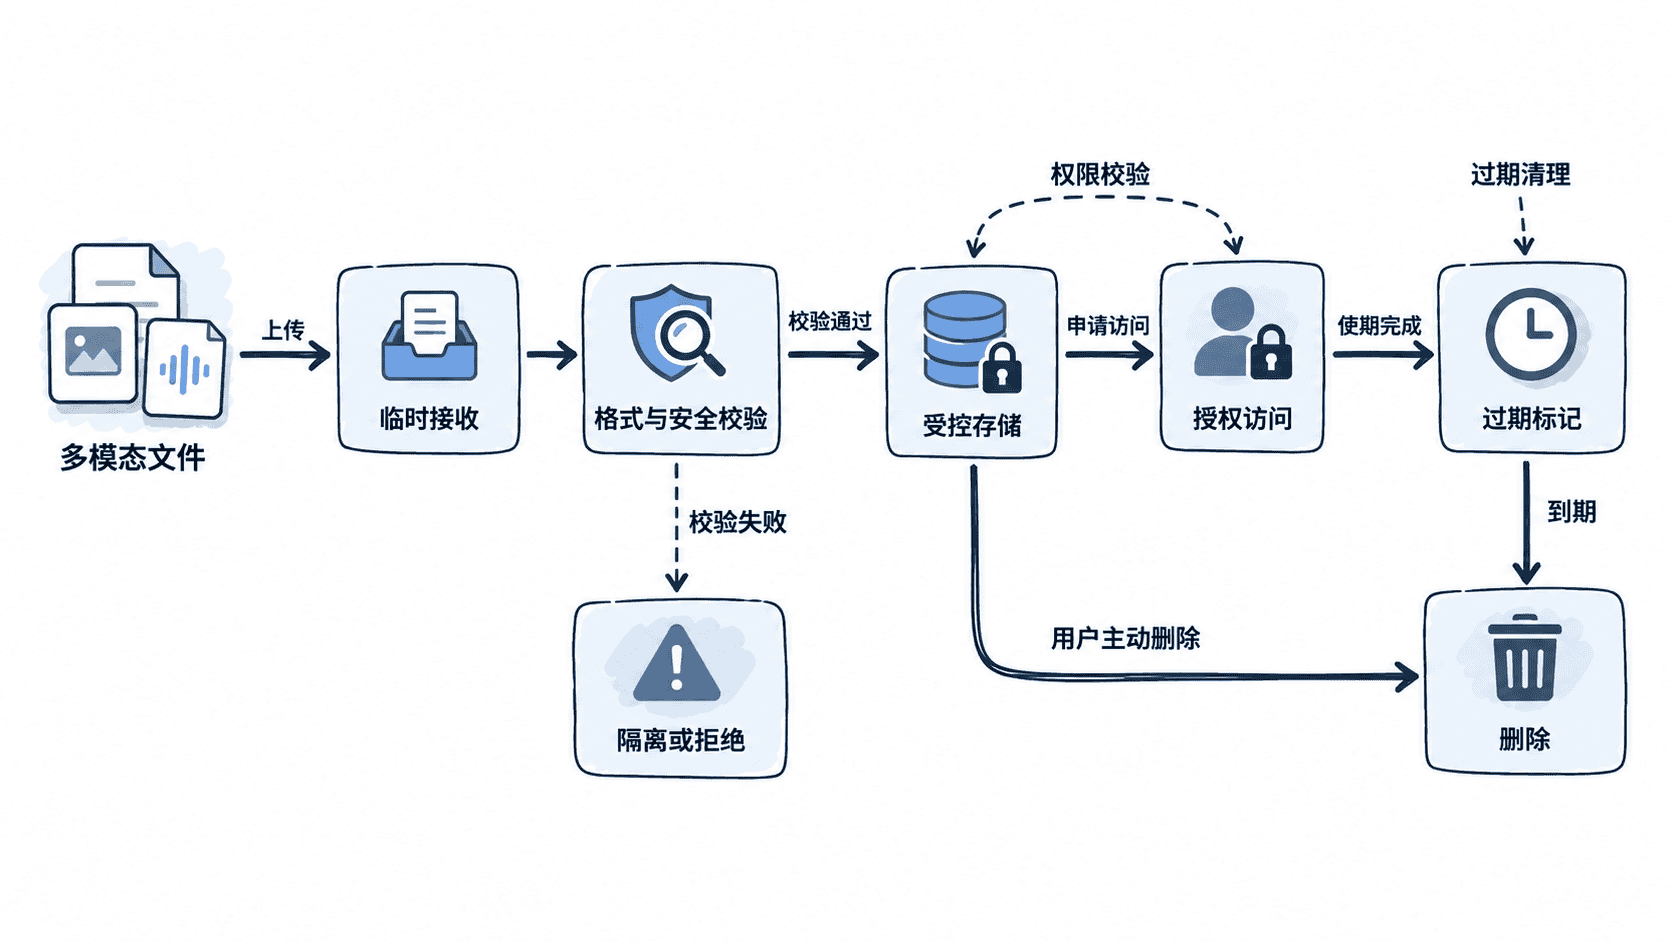
文件元数据至少要记录资源 ID、归属用户或租户、存储位置、MIME 类型、大小、创建时间、过期时间和当前状态。模型请求只引用资源 ID,不把底层对象存储路径直接暴露给前端。
控制存储与访问权限
原始文件应存入私有存储空间,访问时通过后端授权或短时签名地址放行。不要把对象设置为公开可读,也不要把长期有效的下载地址写进聊天记录。
权限判断通常同时看三件事:当前调用者是谁、文件属于谁、当前操作是否被允许。即使用户知道另一个文件的资源 ID,也必须因为归属不匹配而被拒绝。
下面的 Python 示例演示最小的访问判定逻辑,可直接运行。
from dataclasses import dataclass

@dataclass
class FileRecord:
    owner_id: str
    status: str

def can_read(user_id: str, file: FileRecord) -> bool:
    return file.owner_id == user_id and file.status == "READY"

record = FileRecord(owner_id="user-1001", status="READY")
print(can_read("user-1001", record))
print(can_read("user-2002", record))
预期输出:
True
False真实系统还应叠加租户边界、角色权限和有效期判断,但核心原则不变:先授权,再发放实际文件访问能力。
设置有效期与清理策略
临时对话文件不应无限期保留。可以按业务把文件分为短期会话附件、长期知识库文件和审计保留文件,并分别设置 TTL。到期后先标记不可访问,再由后台任务删除对象与索引,避免“数据库记录删了但对象仍存在”。
删除时还要考虑派生数据。图片缩略图、音频转写、文档切块、向量索引和缓存都可能继续保留原内容,因此资源删除应该触发一组级联清理动作,而不是只删除原文件。
在送入模型前处理敏感信息
多模态文件可能包含身份证件、合同、地址、账号、内部截图等敏感内容。送入模型前应先判断是否真的需要完整原件;如果只需要文本中的少量字段,就优先裁剪、打码或抽取最小必要信息。
对于需要保留原件的场景,应把敏感检测、访问审计和外发策略放在模型调用之前。日志也不要记录原文件正文、长期下载地址或未脱敏的识别结果。
一套可维护的多模态文件管理方案,应该让每个文件都能回答四个问题:谁上传的、谁能访问、什么时候失效、删除时还要清掉什么。只有这些边界清楚,文件才能安全地参与模型推理和后续处理。