
大模型应用开发 / 系统课时
校验与修复结果
校验与修复结果
模型返回了 JSON,并不等于应用已经拿到可信数据。本节用一个可运行的 Python 示例,把输出处理拆成解析、字段校验和有限修复三步,最终得到可进入业务逻辑的结构化结果,同时明确哪些错误必须拒绝继续处理。
学习目标
- 区分语法解析失败、字段缺失、类型错误和非法值。
- 为可安全纠正的问题设计有限修复规则。
- 在修复后再次校验,避免“修好了格式却破坏语义”。
把模型输出当作不可信输入
模型输出首先是外部输入。即使提示词要求固定 JSON,也可能出现缺字段、数字被写成字符串、枚举值越界,甚至整段内容无法解析。
推荐的处理顺序是:先解析语法,再校验结构与取值,最后只修复确定性很高的问题。修复后必须重新走完整校验,不能因为“代码已经改过一次”就默认结果可信。
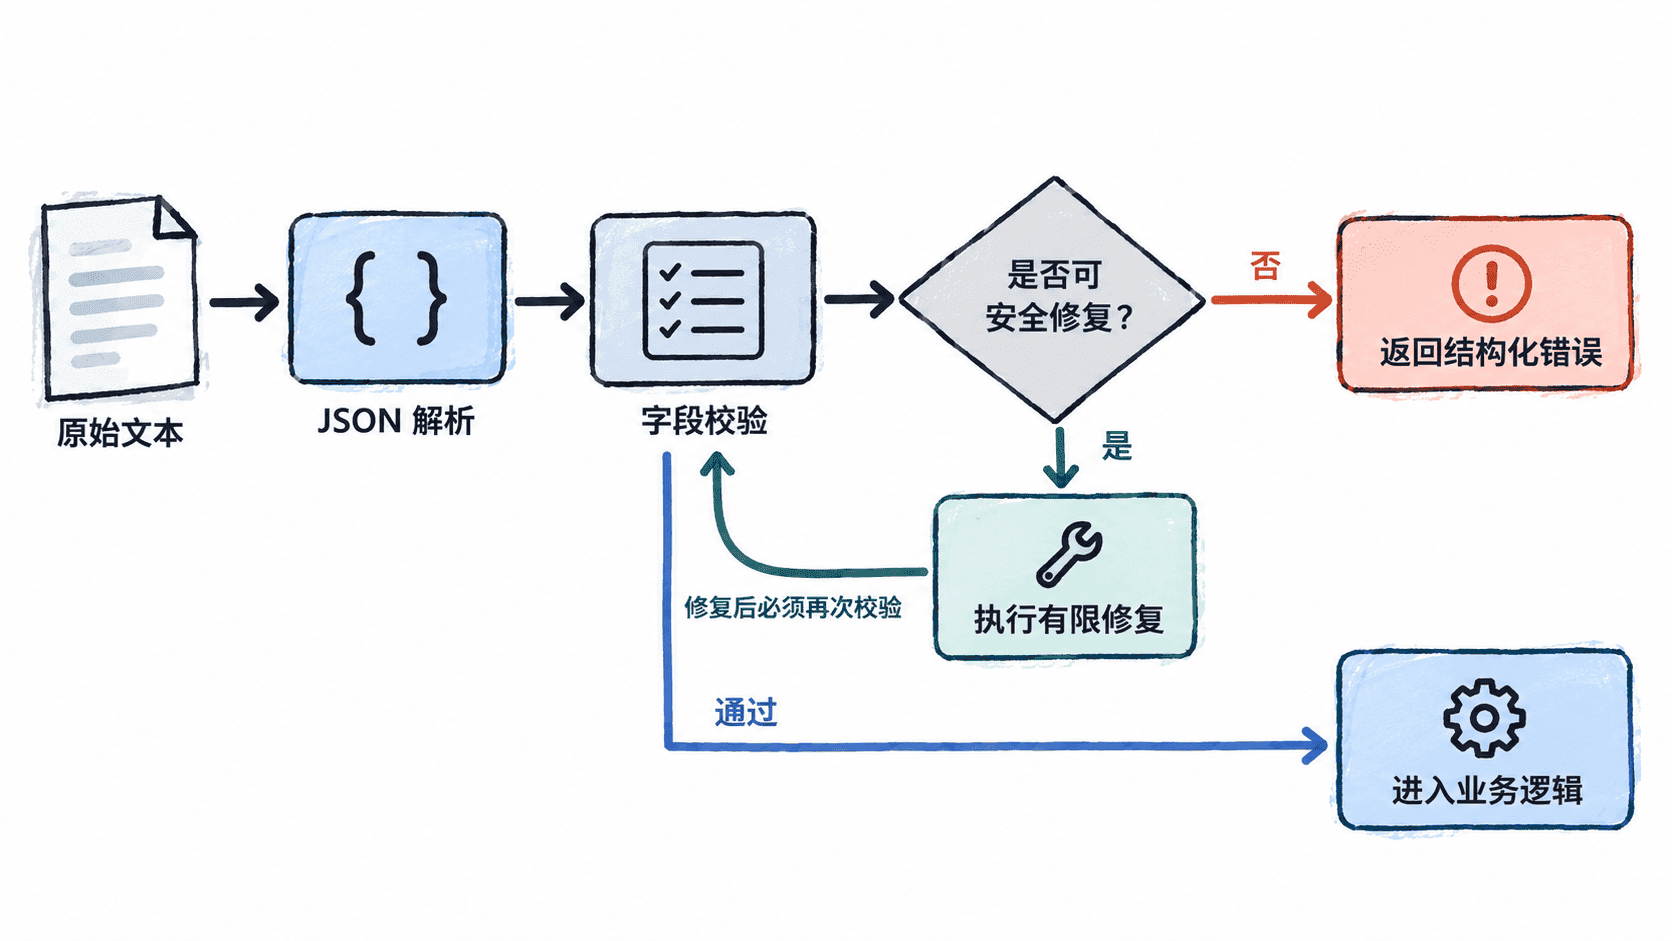
先定义允许进入业务的契约
假设应用需要模型返回用户资料:name 必须是非空字符串,age 必须是 0~120 的整数,status 只能是 active 或 inactive。其中只有一种修复被允许:把纯数字字符串年龄转换为整数。
下面的程序可直接运行,只依赖 Python 标准库。
python
import json

ALLOWED_STATUS = {"active", "inactive"}

def validate(data):
    errors = []
    if not isinstance(data.get("name"), str) or not data["name"].strip():
        errors.append("name 必须是非空字符串")
    if not isinstance(data.get("age"), int) or not 0 <= data["age"] <= 120:
        errors.append("age 必须是 0~120 的整数")
    if data.get("status") not in ALLOWED_STATUS:
        errors.append("status 必须是 active 或 inactive")
    return errors

def parse_validate_repair(raw):
    try:
        data = json.loads(raw)
    except json.JSONDecodeError as exc:
        return {"ok": False, "errors": [f"JSON 解析失败: {exc.msg}"]}

    # 只修复确定性高、不会改变业务含义的类型问题。
    if isinstance(data.get("age"), str) and data["age"].isdigit():
        data["age"] = int(data["age"])

    errors = validate(data)  # 修复后重新校验全部约束。
    return {"ok": not errors, "data": data, "errors": errors}

raw = '{"name":"Lin","age":"27","status":"active"}'
print(parse_validate_repair(raw))
预期输出
text
{'ok': True, 'data': {'name': 'Lin', 'age': 27, 'status': 'active'}, 'errors': []}哪些问题可以修,哪些不能猜
可以自动修复的问题,应同时满足两个条件:转换规则确定,并且不会引入新的业务含义。例如 "27" 转成 27 通常是安全的;而缺少 status 时自动补成 active,其实是在替模型做业务决策,不应静默处理。
遇到缺失必填字段、未知枚举、互相矛盾的字段或无法判断原意的值,更稳妥的做法是返回结构化错误,让上层决定重新请求模型、要求模型纠正,或交给人工处理。
让错误也成为稳定接口
生产代码不要只返回 True 或抛出一串不可解析的异常文本。至少应保留错误类别、字段和原因,便于重试策略、日志统计和监控聚合。若使用 JSON Schema、Pydantic、Zod 等库,也应把第三方校验错误转换成应用自己的稳定错误格式。
校验与修复的边界可以概括为:能确定地纠正表示形式,就修;需要猜业务含义,就拒绝并交给上层决策。
按自己的节奏,确认真正理解。