
大模型应用开发 / 系统课时
执行模型评测
执行模型评测
模型评测的关键不是“让另一个模型打个分”,而是把样本、评分标准、候选答案和偏差控制固定成可重复流程。完成本节后,你可以执行一次可审计的评审模型评测,并判断结果是否值得信任。
学习目标
- 把生成结果整理成适合评审模型处理的评测单元
- 用明确评分锚点约束评审模型,并输出可聚合的结构化结果
- 识别位置偏差、长度偏好和评审模型自偏好等常见误差
把评测对象固定下来
一次评测应至少固定四类输入:原始任务、必要参考信息、候选输出和评分标准。不要把线上随机样本直接丢给评审模型后只保留最终分数,否则一旦评分异常,很难回溯到底是样本、提示词还是评审模型出了问题。
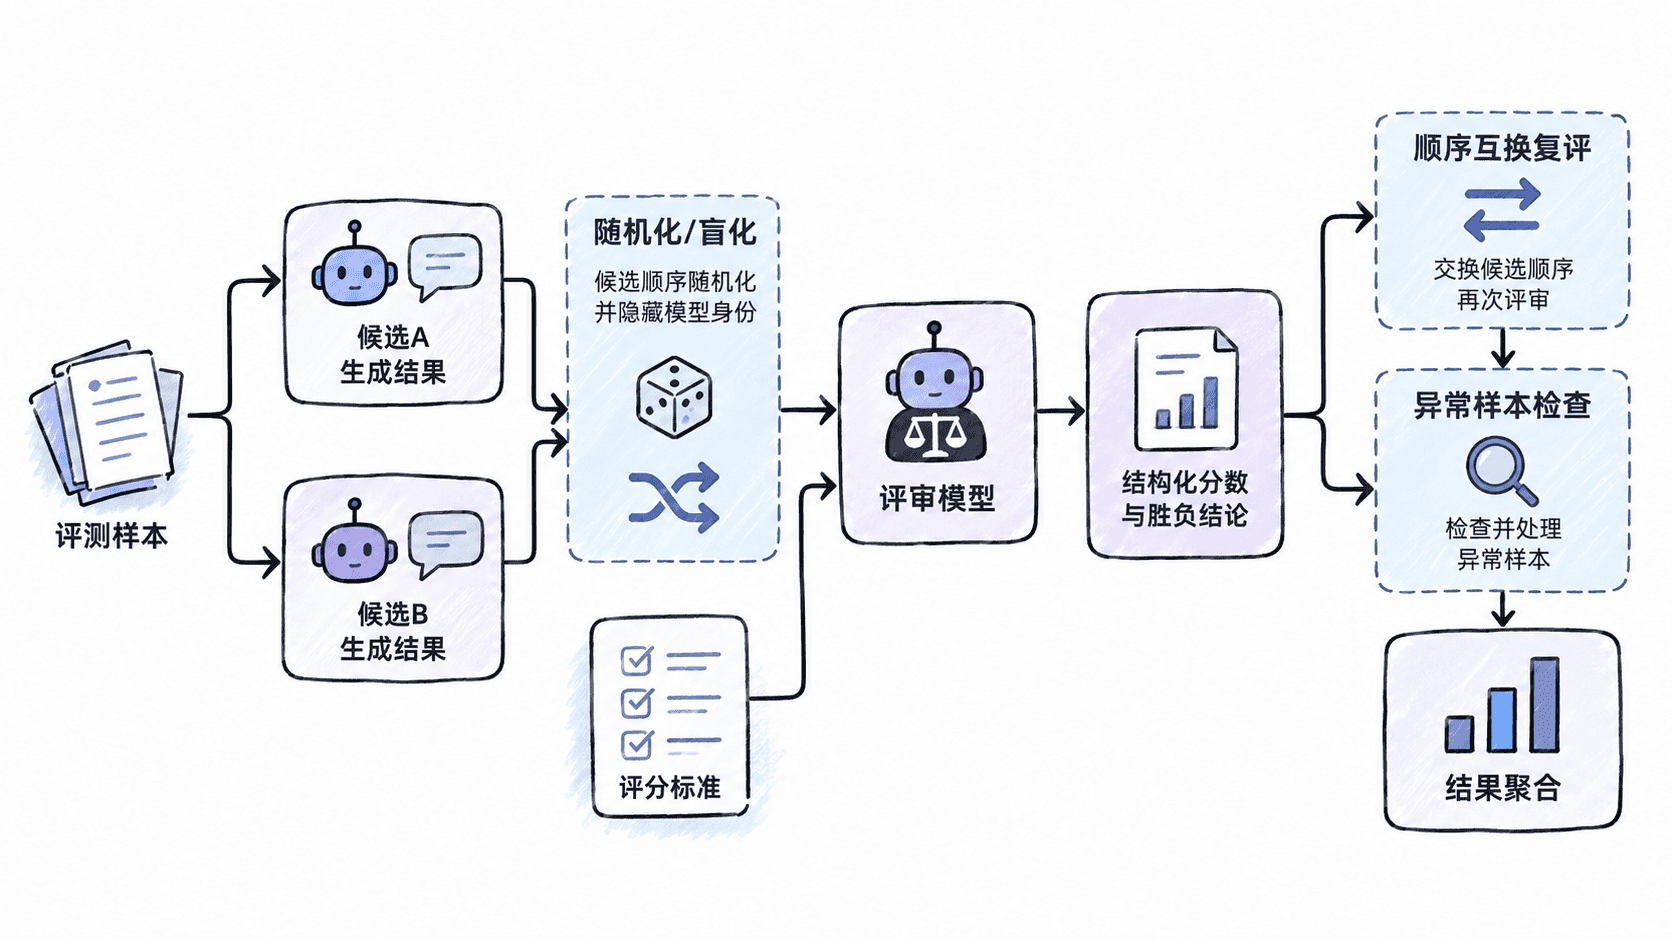
比较两个版本时,优先使用成对比较:同一条输入同时给出候选 A 和候选 B,让评审模型判断谁更符合标准。只评一个答案时,则使用逐项评分。无论哪种方式,都应记录评测集版本、候选版本和评审模型版本。
设计可执行的评分标准
评分标准要回答“什么样才算 1 分、3 分、5 分”,而不是只写“准确性”“质量”这类抽象词。建议只保留与业务决策直接相关的维度,例如任务完成度、事实正确性、约束遵循和表达质量;维度过多会让评审模型把注意力分散在次要差异上。
下面是一份成对比较的评审提示词模板。它不依赖具体模型 SDK,调用层只需把任务、参考信息和两个候选答案填入对应位置。
你是评测员。请只依据给定任务、参考信息和评分标准比较候选 A 与候选 B。

评分标准:
1. 任务完成度:是否完整解决用户要求。
2. 正确性:是否包含与参考信息冲突的事实。
3. 约束遵循:是否违反格式、范围或安全约束。
4. 表达质量:是否清晰、直接、无明显冗余。

规则:
- 不因为答案更长就自动给高分。
- 不推测候选来自哪个模型。
- 证据不足时允许判定 TIE。
- 只输出 JSON,不要添加额外文字。

输出字段:
winner: A | B | TIE
score_a: 1-5
score_b: 1-5
reason: 不超过 80 字的关键依据
预期结果
{"winner":"B","score_a":3,"score_b":5,"reason":"B 完整满足格式约束,且未遗漏参考信息中的限制条件"}实际评分会随样本和评审模型而变化,但字段结构应保持一致,便于后续解析和统计。
执行评测并聚合结果
执行时先随机决定哪个版本放在 A、哪个放在 B,再批量调用评审模型并保存原始返回。对于重要对比,建议再把 A/B 顺序互换复评;如果同一样本在换序后结论反转,说明位置偏差已经影响判断,这类样本不应直接计入最终胜率。
聚合时不要只看平均分。成对比较至少同时观察胜、负、平三个比例,并单独列出解析失败、理由为空、换序不一致等异常样本。这样可以区分“模型确实更好”和“评测流程不稳定”这两类完全不同的问题。
识别常见评测偏差
位置偏差会让评审模型偏向先出现或后出现的候选,最直接的检查方法是交换 A/B 后复评。长度偏好会把“写得多”误当成“更完整”,因此评分标准要明确“无关扩写不加分”。如果评审模型与候选模型同源,还可能出现自偏好,应通过隐藏模型身份、混用不同评审模型或加入人工基准样本来校准。
另一个常见问题是评分标准泄漏:候选答案刻意迎合“评审语言”,却没有真正改善业务效果。处理方法是让评分标准描述可观察行为,并定期抽查高分样本是否真的让用户任务更成功,而不是只看措辞是否像标准答案。
什么时候不能只信评审模型
涉及高风险事实、强业务语境、品牌语气或细微主观偏好时,评审模型适合做大规模筛查,却不应成为唯一裁决者。更稳妥的做法是用它快速发现明显优劣和异常样本,再把边界案例交给人工评审。评测流程真正可用的标准,不是分数看起来精确,而是换模型、换顺序、抽样复核后结论仍基本一致。