
大模型应用开发 / 系统课时
选择流程模式
选择流程模式
工作流编排的关键不是节点越多越强,而是让执行关系匹配任务结构。本篇用四种常见模式拆解选择方法,并给出可运行示例,帮助你判断何时顺序执行、条件分支、并行处理或循环迭代。
学习目标
- 根据任务依赖关系选择合适的流程模式
- 理解四种模式对延迟、成本和可控性的影响
- 能把一个混合任务拆成清晰的执行图
先看任务依赖
选择模式时先问三个问题:后一步是否必须等待前一步结果、是否存在互斥条件、同一批子任务之间是否互不依赖。只要这三点判断清楚,模式通常就不会选错。
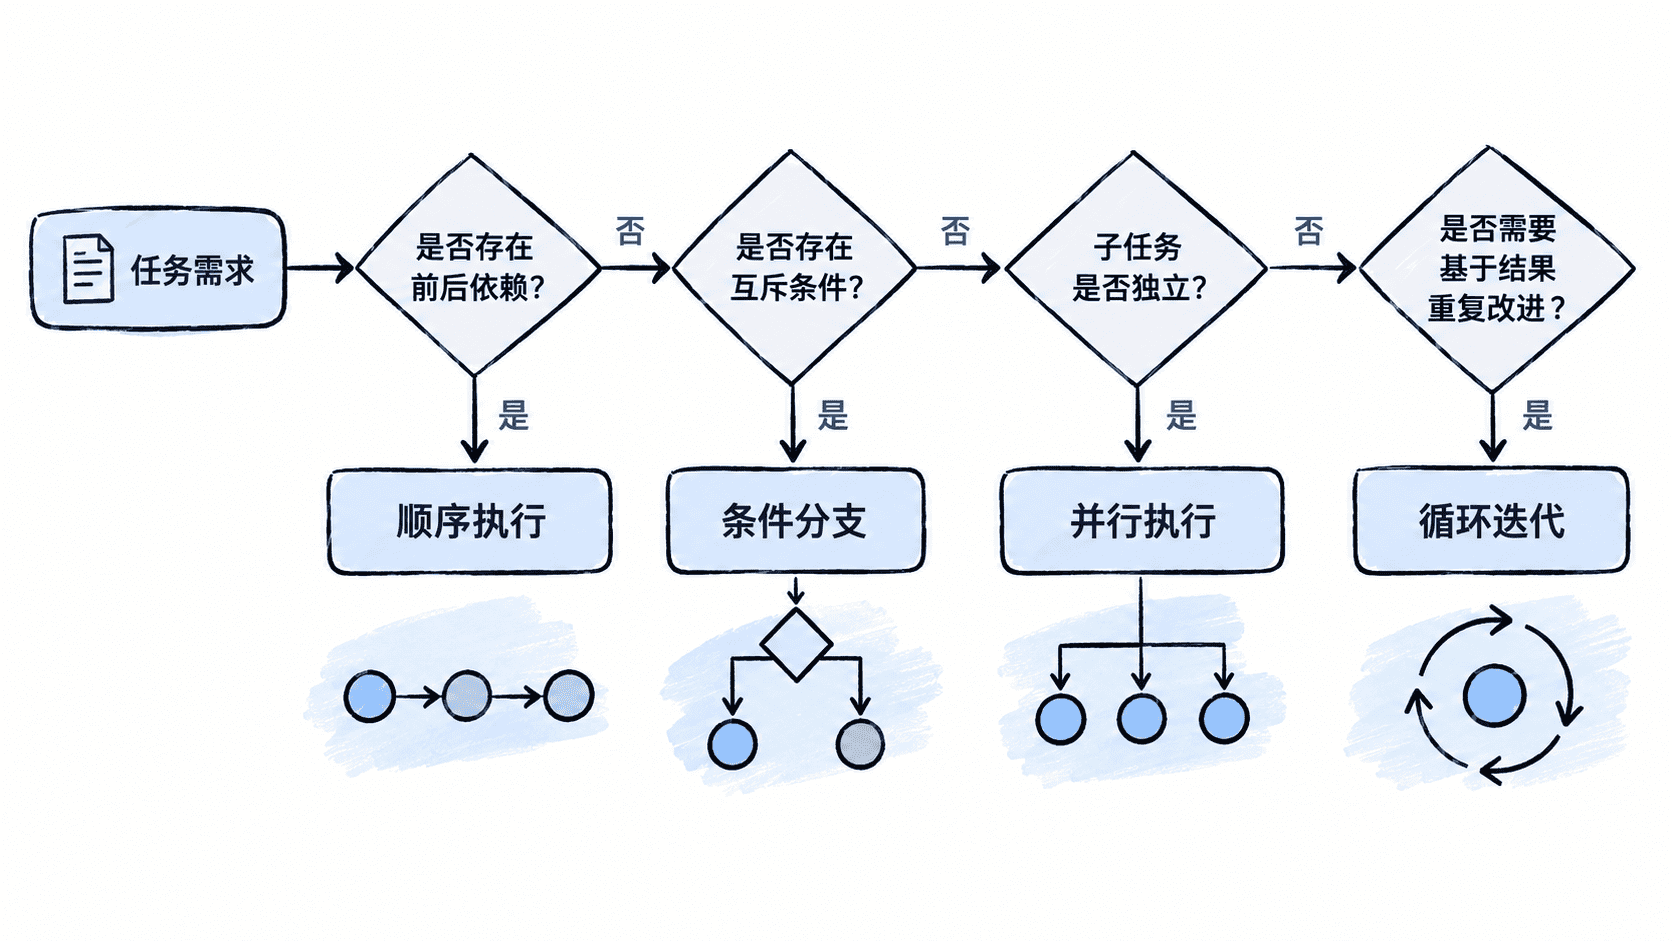
四种模式怎么选
顺序执行适合强依赖链,例如先抽取信息,再基于抽取结果生成结论。它最容易调试,但总延迟接近各节点耗时之和。
条件分支适合只有部分任务需要继续处理的场景,例如先判断问题类型,再进入知识库检索、工具调用或直接回答。重点是分支条件必须稳定、可测试,并提供兜底路径。
并行执行适合彼此独立的子任务,例如同时做事实检查、风格检查和风险检查。它能缩短总体等待时间,但会增加瞬时并发与资源消耗。
循环迭代适合结果需要反复改进的任务,例如生成草稿后进行评分,不达标就根据反馈重新生成。循环必须设置退出条件和最大次数,否则容易出现成本失控或无法结束。
用代码观察执行差异
下面的 Python 示例把四种模式放在一个最小程序里。每个函数都可以直接运行,重点观察调用顺序和结果组织方式。
python
from concurrent.futures import ThreadPoolExecutor

def step(name, value):
    return f"{name}:{value}"

def sequential(x):
    a = step("extract", x)
    return step("answer", a)

def branching(x):
    if "退款" in x:
        return step("refund_flow", x)
    return step("general_flow", x)

def parallel(x):
    with ThreadPoolExecutor(max_workers=2) as pool:
        futures = [
            pool.submit(step, "fact_check", x),
            pool.submit(step, "style_check", x),
        ]
        return [future.result() for future in futures]

def iterative(x, max_rounds=3):
    value = x
    for round_no in range(1, max_rounds + 1):
        value = step(f"revise_{round_no}", value)
        if round_no == 2:
            break
    return value

print(sequential("订单异常"))
print(branching("我要退款"))
print(parallel("产品说明"))
print(iterative("初稿"))
预期输出
text
answer:extract:订单异常
refund_flow:我要退款
['fact_check:产品说明', 'style_check:产品说明']
revise_2:revise_1:初稿
并行任务的完成先后在真实网络调用中可能不同,因此工程上不要依赖返回顺序表达业务含义,应为结果保留明确的任务名称或 ID。
混合流程更常见
生产工作流通常不是四选一,而是组合使用。例如先条件分支决定是否需要检索,再并行查询多个数据源,最后顺序聚合结果;如果质量评分不达标,再进入有限次数的循环改写。
判断一个模式是否合适,最终看的是依赖关系能否被准确表达、失败是否容易恢复,以及额外复杂度是否真的换来了可测量的收益。
按自己的节奏,确认真正理解。