
大模型应用开发 / 系统课时
生成文本向量
生成文本向量
完成文档切分后,需要把每个片段和用户查询映射到同一个向量空间,才能做相似度检索。本节用一个多语言向量模型完成编码、归一化与匹配,并说明模型选择、维度一致性和重建索引时最容易忽略的边界。
学习目标
- 能按语言、领域、输入长度和部署成本选择向量模型
- 能用同一套编码流程生成文档向量与查询向量
- 能验证向量维度、归一化方式和相似度计算是否一致
向量表示解决什么问题
文本向量是固定维度的数值数组。语义接近的文本会被模型映射到相近位置,因此检索阶段不必只依赖关键词完全匹配。查询“激活后的数字商品能否退款”时,即使文档写的是“数字商品激活后不可退款”,两者仍有机会得到较高相似度。
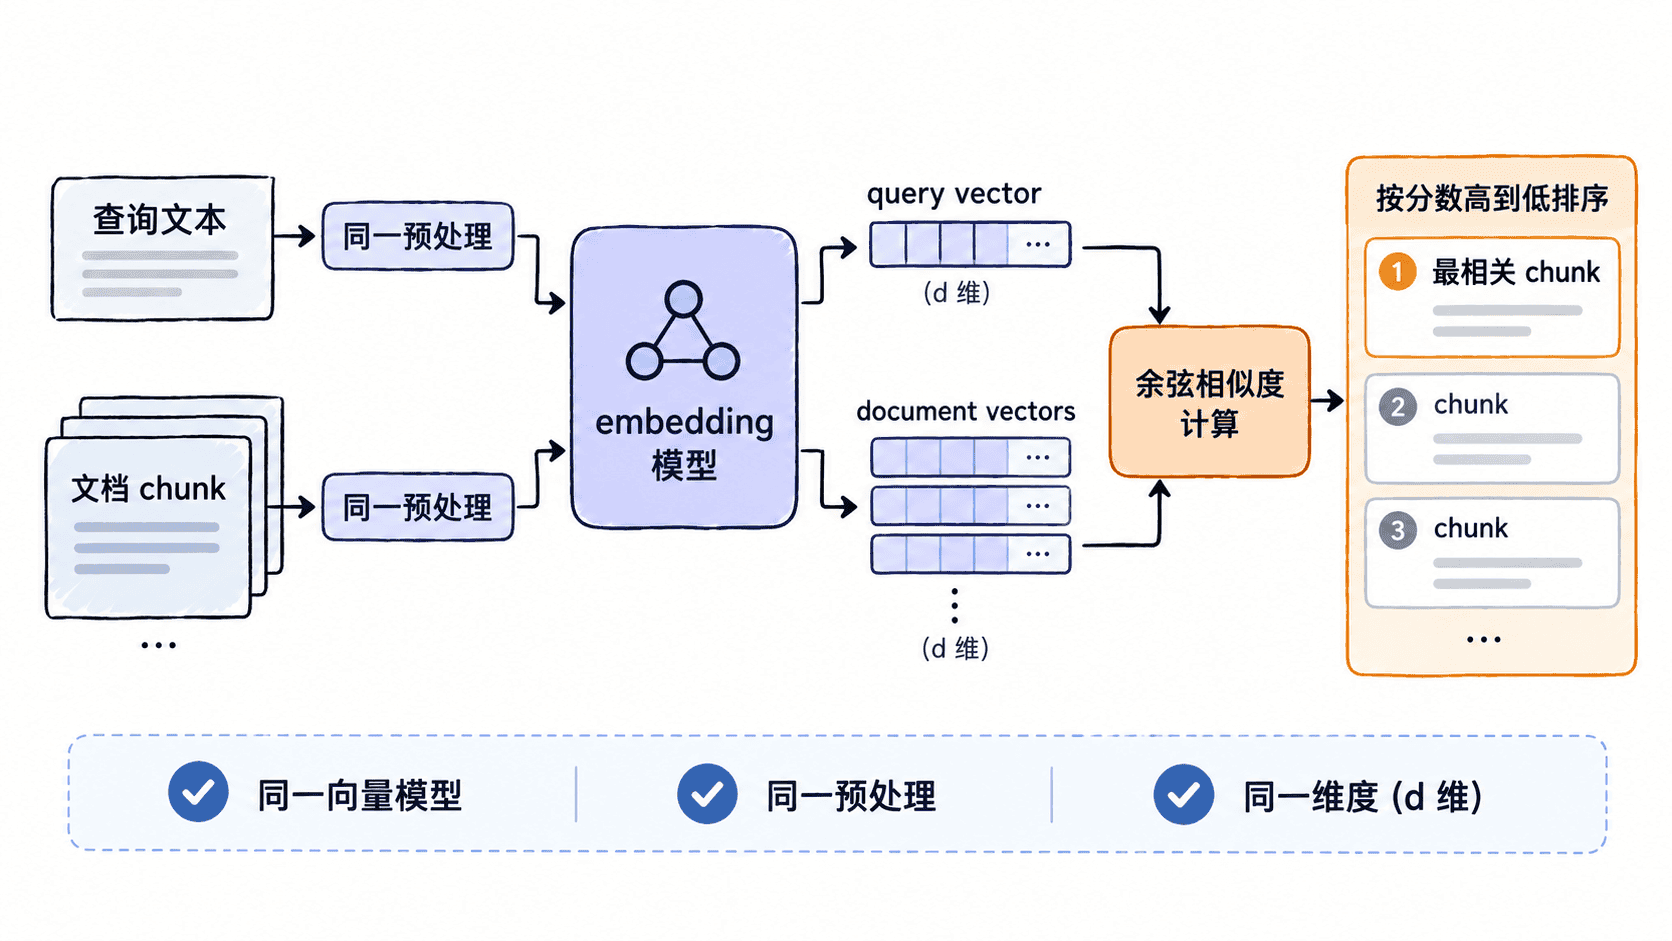
文档和查询必须进入兼容的同一向量空间。如果重建知识库时更换了模型、模型版本或特定的 query/passage 前缀规则,就不能继续把新查询向量与旧文档向量直接比较,通常需要重新编码并重建索引。
选择模型时看四个约束
模型选择先看语言覆盖和领域效果,再看最大输入长度、向量维度、延迟与部署成本。中文或多语言知识库应使用明确支持相应语言的模型;专业术语密集的场景则应通过自己的问答集验证,而不是只依据公开榜单。
向量维度会直接影响向量库索引配置和存储成本。维度不是越高越好,关键是检索质量能否满足任务。若模型文档要求查询和文档使用不同前缀或不同编码接口,也必须遵循该规则,否则向量虽然维度一致,检索质量仍可能明显下降。
生成并比较向量
下面示例使用 sentence-transformers 的多语言模型。运行前需要在 Python 环境中安装 sentence-transformers;首次加载模型时可能需要下载权重。示例把查询设置为与第一条文档完全相同,便于验证编码和相似度链路是否工作。
from sentence_transformers import SentenceTransformer

MODEL_NAME = "sentence-transformers/paraphrase-multilingual-MiniLM-L12-v2"
documents = [
    "数字商品激活后不可退款。",
    "普通商品可在订单完成后7天内申请退款。",
    "客服审核通过后,退款会原路退回。",
]
query = "数字商品激活后不可退款。"

model = SentenceTransformer(MODEL_NAME)
# 文档和查询使用同一模型,并统一做 L2 归一化。
doc_vectors = model.encode(documents, normalize_embeddings=True)
query_vector = model.encode(query, normalize_embeddings=True)
scores = doc_vectors @ query_vector
best_index = int(scores.argmax())

print(f"vector_dim={doc_vectors.shape[1]}")
print(f"best_index={best_index}")
print(f"score={scores[best_index]:.4f}")
print(f"best_text={documents[best_index]}")
预期输出
vector_dim=<VALUE>
best_index=0
score=1.0000
best_text=数字商品激活后不可退款。
<VALUE> 是模型实际输出的向量维度,应以当前模型加载结果为准。这里启用了归一化,因此向量点积可直接用于余弦相似度排序;若你的向量库选择欧氏距离或内积索引,需要让建库和查询两端采用一致的度量与归一化策略。
建库前验证一致性
正式写入向量库前,至少检查三件事:所有文档向量维度完全一致,查询向量与索引维度相同,同一条文本重复编码时不会因为预处理差异产生异常结果。还应保存模型名称、版本或权重标识以及归一化策略,作为索引元数据。
更换向量模型后,应把它视为一次索引迁移,而不是普通配置修改。先用固定评测集比较旧模型和新模型的召回质量,再批量重算文档向量并切换索引,才能避免查询向量已经升级、文档向量仍停留在旧空间的隐性故障。