
大模型应用开发 / 系统课时
执行向量检索
执行向量检索
向量检索的关键不是只算一次相似度,而是把文本向量、原文和可过滤元数据一起写入检索系统,再用查询向量限定候选范围并取得 Top-K 结果。本节用一个可运行的最小实现串起完整流程。
学习目标
- 设计向量、原文与元数据的基本存储结构
- 按元数据过滤候选记录并计算向量相似度
- 根据 Top-K 结果判断过滤条件和召回范围是否正确
向量检索需要保存什么
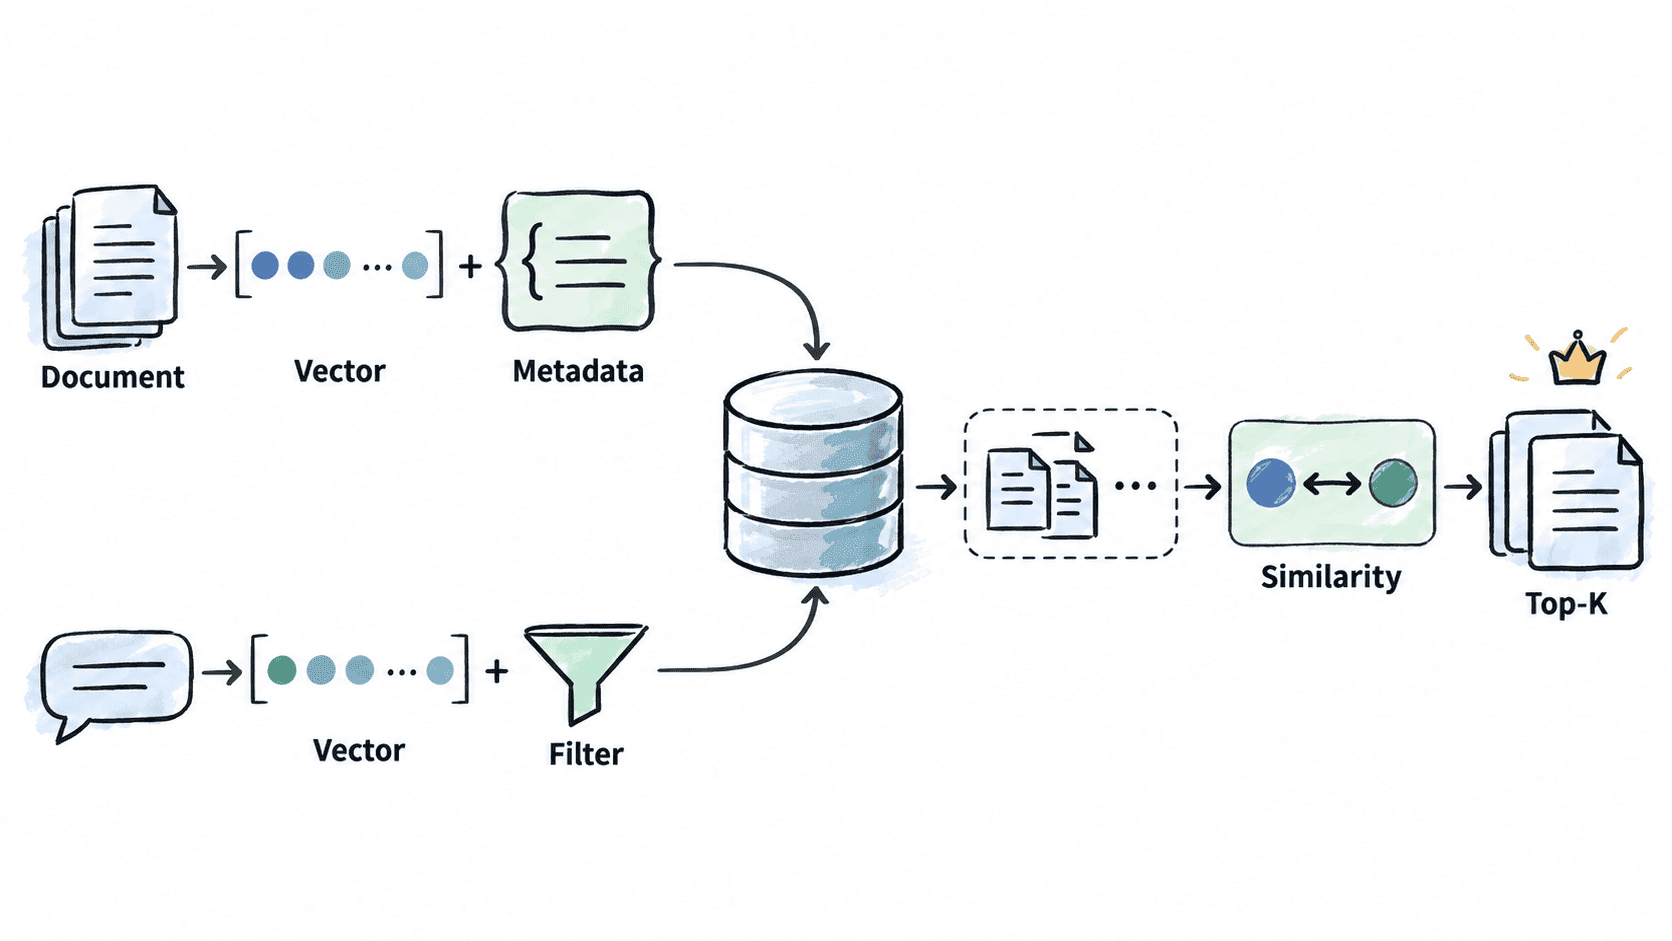
知识片段写入检索系统时,至少要保留唯一标识、原始文本、向量和元数据。向量用于语义匹配,原文最终会进入模型上下文,元数据则负责把检索限制在指定知识域,例如产品、租户、文档类型或版本。
一次查询通常经历“查询向量 → 元数据过滤 → 相似度计算 → Top-K 排序 → 返回原文”的链路。过滤发生得越早,需要参与向量计算的候选通常越少,也能避免语义相近但业务范围错误的内容混入结果。
完成一次可运行的向量检索
下面用 Python 标准库实现一个极小的内存向量库。它并不替代生产级向量数据库,但完整保留了写入、过滤、余弦相似度计算和 Top-K 排序这几个核心动作,因此适合验证检索逻辑。
from math import sqrt


def cosine_similarity(a, b):
    if len(a) != len(b):
        raise ValueError("vector dimensions must match")
    dot = sum(x * y for x, y in zip(a, b))
    norm_a = sqrt(sum(x * x for x in a))
    norm_b = sqrt(sum(x * x for x in b))
    return dot / (norm_a * norm_b) if norm_a and norm_b else 0.0


class SimpleVectorStore:
    def __init__(self):
        self.rows = []

    def upsert(self, doc_id, text, vector, metadata):
        # 同一条记录保存检索向量和后续构造上下文所需的信息。
        self.rows.append({
            "id": doc_id,
            "text": text,
            "vector": vector,
            "metadata": metadata,
        })

    def search(self, query_vector, filters=None, top_k=2):
        hits = []
        for row in self.rows:
            # 先执行精确元数据过滤,再计算向量相似度。
            if filters and any(
                row["metadata"].get(key) != value
                for key, value in filters.items()
            ):
                continue
            score = cosine_similarity(query_vector, row["vector"])
            hits.append((score, row))

        hits.sort(key=lambda item: item[0], reverse=True)
        return hits[:top_k]


store = SimpleVectorStore()
store.upsert("doc-1", "PostgreSQL 逻辑复制入门", [1.0, 0.0], {"category": "database"})
store.upsert("doc-2", "Python Web 接口设计", [0.0, 1.0], {"category": "backend"})
store.upsert("doc-3", "PostgreSQL 备份恢复清单", [1.0, 1.0], {"category": "database"})

results = store.search(
    query_vector=[1.0, 0.0],
    filters={"category": "database"},
    top_k=2,
)

for score, row in results:
    print(row["id"], f"{score:.4f}", row["text"])
预期输出
doc-1 1.0000 PostgreSQL 逻辑复制入门
doc-3 0.7071 PostgreSQL 备份恢复清单
结果中没有 doc-2,并不是因为它的相似度一定最低,而是因为 category=database 已经先将它排除。剩余候选再按余弦相似度降序排列,因此与查询向量方向完全一致的 doc-1 排在第一位。
在真实检索系统中验证结果
把示例替换成实际向量数据库或带向量索引的数据库后,仍应检查三个事实:写入向量维度是否与查询向量一致,过滤字段和值是否与存储的元数据一致,以及返回结果是否严格按照目标相似度指标和 Top-K 规则排序。
控制召回边界
Top-K 过小可能漏掉回答所需片段,过大则会引入噪声并消耗上下文窗口。元数据过滤也并非越多越好:如果标签缺失、版本标记错误或过滤条件过窄,正确文档会在计算相似度之前就被排除。
因此,调试向量检索时应同时观察“过滤前候选范围、过滤后候选范围、最终 Top-K”三个层次。只有能解释一条文档为什么进入或离开候选集,向量检索才真正具备可验证性。