
大模型应用开发 / 系统课时
管理流程状态
管理流程状态
只要工作流包含多个节点、重试或暂停恢复,就必须把状态当成显式数据管理。本篇用一个最小状态对象说明该保存什么、何时更新,以及怎样靠检查点让任务从中断位置继续执行。
学习目标
- 区分流程输入、节点输出、执行状态和中间结果
- 设计可恢复的状态结构与检查点
- 理解状态更新、失败重试和继续执行之间的关系
状态里要保存什么
一个可恢复的流程至少要记录四类信息:原始输入决定任务上下文,节点输出供后续节点使用,执行状态表示当前位置与成功失败,中间结果用于重试后复用已经完成的工作。
状态对象不应只存最终答案。若只保存最终结果,一旦第三个节点失败,系统无法判断前两个节点是否已经完成,也无法安全决定从头重跑还是从失败处继续。
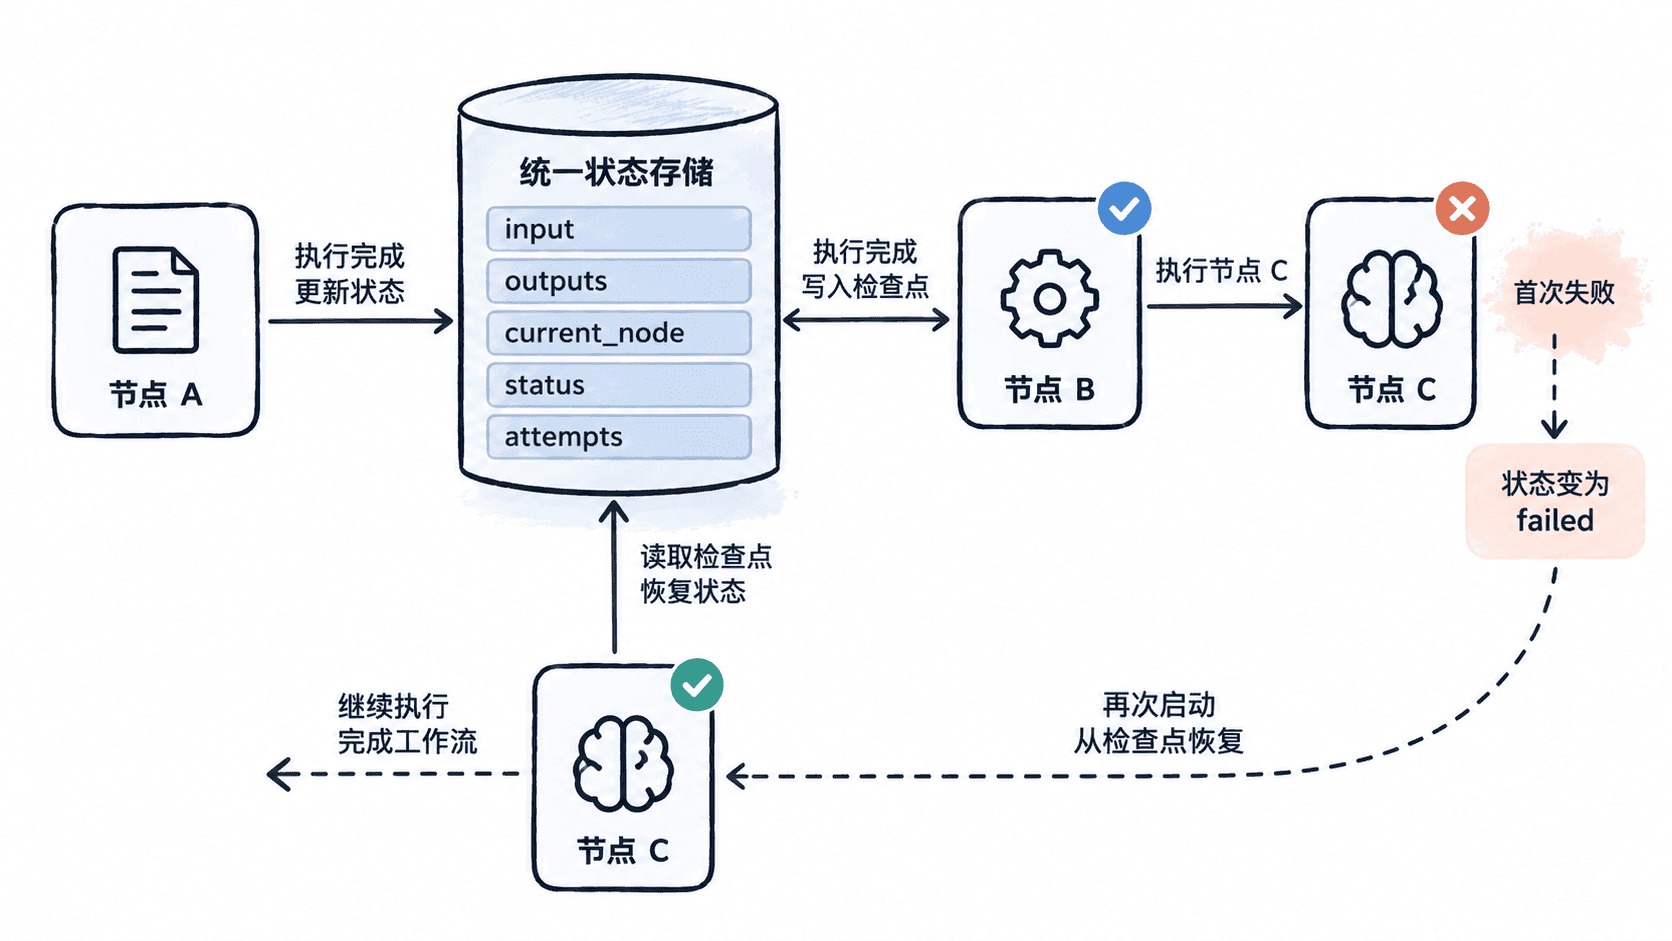
用显式状态驱动节点
下面示例使用字典保存节点输入、输出、当前位置和状态。模拟失败后再次调用 run(),流程会跳过已经成功的节点,从未完成位置继续。
python
def run(state):
    if "extract" not in state["outputs"]:
        state["current_node"] = "extract"
        state["outputs"]["extract"] = state["input"].upper()

    if "answer" not in state["outputs"]:
        state["current_node"] = "answer"
        if state["attempts"] == 0:
            state["attempts"] += 1
            state["status"] = "failed"
            return state
        state["outputs"]["answer"] = f"RESULT:{state['outputs']['extract']}"

    state["current_node"] = None
    state["status"] = "completed"
    return state

state = {
    "input": "order-42",
    "outputs": {},
    "current_node": None,
    "status": "running",
    "attempts": 0,
}

print(run(state))
print(run(state))
预期输出
text
{'input': 'order-42', 'outputs': {'extract': 'ORDER-42'}, 'current_node': 'answer', 'status': 'failed', 'attempts': 1}
{'input': 'order-42', 'outputs': {'extract': 'ORDER-42', 'answer': 'RESULT:ORDER-42'}, 'current_node': None, 'status': 'completed', 'attempts': 1}
这里第二次执行没有重复运行 extract,因为它的结果已经写入 outputs。这就是最小检查点机制:每完成一个有价值的节点,就把可复用结果持久化。
设计状态更新边界
状态更新最好发生在节点完成之后,并以原子方式写入。若先标记成功、后写输出,中间发生故障,恢复时就可能出现“状态显示成功,但结果不存在”的不一致。
对于外部副作用节点,例如发送邮件、扣款或创建订单,还要保存幂等键或外部操作 ID。仅记录“节点已执行”并不足以防止重试时重复产生副作用。
恢复时检查什么
恢复流程时先读取最后一个一致检查点,再判断当前节点是否已经完成、失败是否允许重试,以及之前产生的外部副作用能否安全复用。对于长流程,还应记录状态版本,避免代码升级后旧状态无法被新节点正确解释。
当状态模型足够清晰时,暂停、重试、人工确认和故障恢复都只是对同一份状态的不同操作,而不是每个场景各写一套特殊逻辑。
按自己的节奏,确认真正理解。