
大模型应用开发 / 系统课时
理解 RAG 流程
理解 RAG 流程
RAG 把“模型凭记忆回答”改造成“先从知识库找证据,再依据证据回答”。本节从一条用户问题出发,串起文档处理、向量化、检索、重排、上下文拼接与答案生成,建立能直接用于设计和排查知识库问答的流程视图。
学习目标
- 说清 RAG 从离线建库到在线问答的完整链路。
- 理解检索、重排和上下文拼接各自解决的问题。
- 能根据回答异常反推最可能出错的处理阶段。
两条链路组成一个 RAG 系统
RAG 通常分为离线建库和在线问答两条链路。离线阶段把原始文档变成可检索的知识片段;在线阶段接收问题,找到相关片段,再把这些证据交给大模型生成答案。两条链路通过同一个向量索引或混合检索索引连接起来。
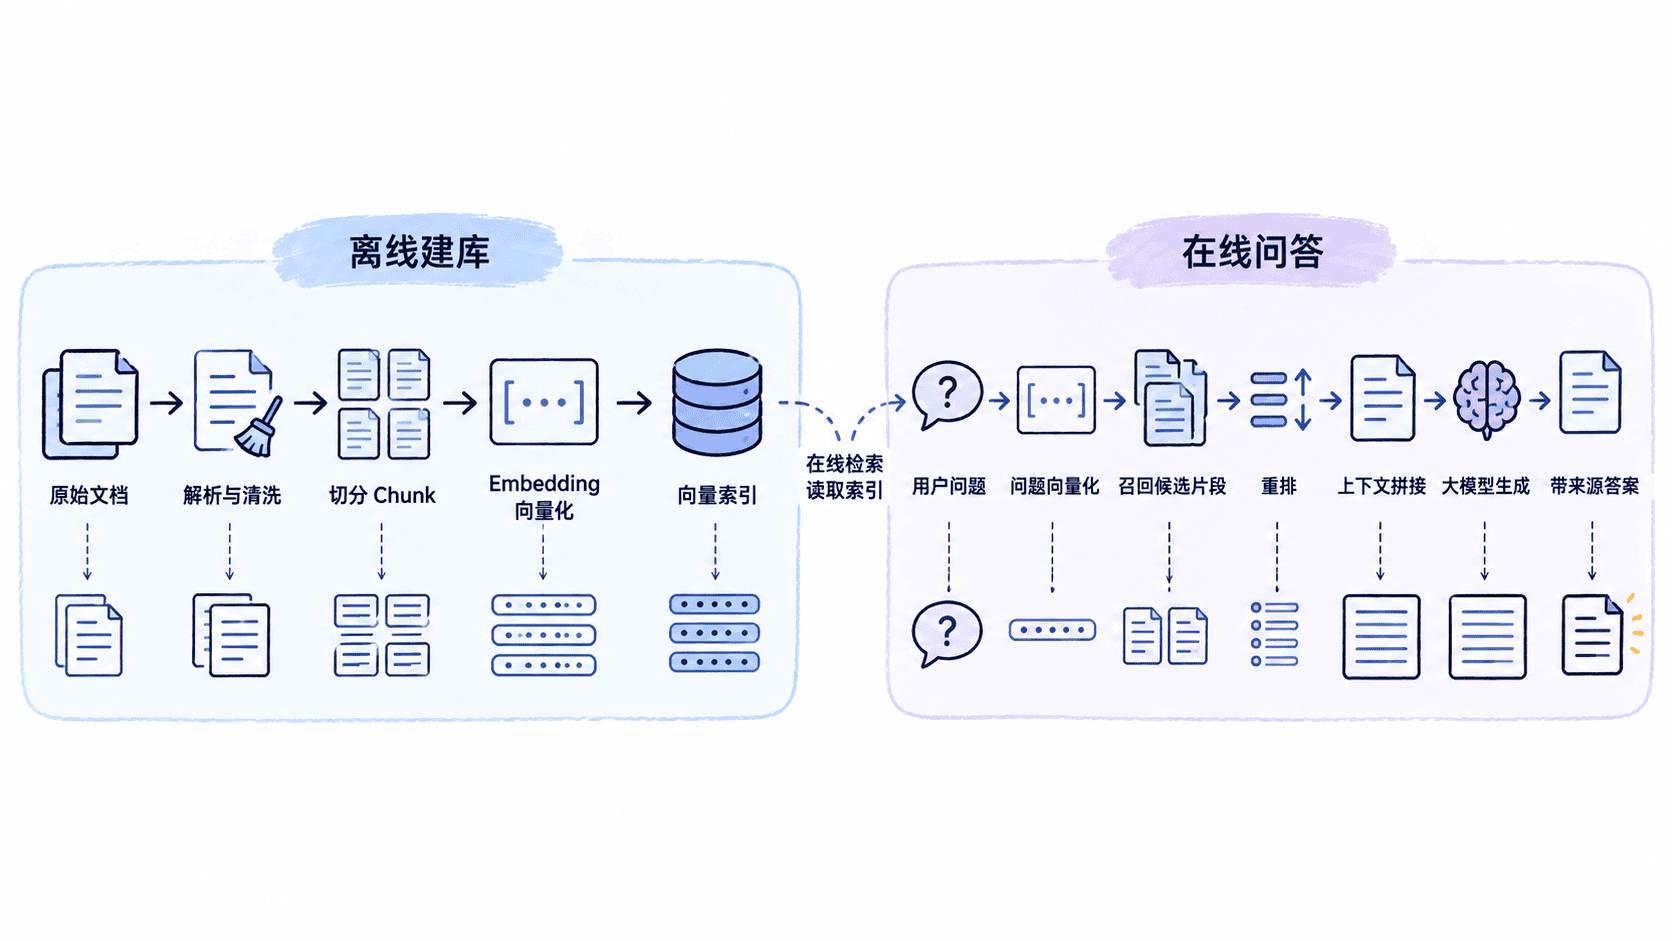
离线链路决定“知识能不能被找到”。文档解析要保留正文与来源信息,切分要让每个片段既包含完整语义又不过长,向量化负责把文本映射到可比较的表示空间,最终把向量和元数据写入索引。
在线链路决定“找到的知识能不能变成可靠答案”。问题先转成检索表示,系统召回一批候选片段;如果候选较多,再用重排模型按问题相关性重新排序;随后只选最有价值的片段拼成上下文,连同问题一起交给大模型。
检索和重排不是一回事
检索追求的是高召回率:宁可多找一些候选,也不要漏掉真正相关的片段。向量相似度、关键词 BM25 或二者混合都可以承担召回。候选数量通常大于最终送给模型的片段数量,因为第一阶段更关注“别漏”。
重排追求的是高精度:在已经召回的几十个候选里,进一步判断“哪个片段最能回答当前问题”。它可以使用 Cross-Encoder、专用 reranker 或轻量规则。没有重排时,语义相近但不能直接作答的片段更容易占用上下文窗口。
上下文拼接要控制证据质量
把排名靠前的片段全部塞进提示词并不一定更好。上下文过长会增加延迟和成本,也可能让模型被重复、冲突或低质量内容干扰。常见做法是按 token 预算选取前若干片段,并保留标题、页码、URL 或文档 ID 作为来源元数据。
一个可用的上下文至少应满足三点:内容与问题直接相关,关键事实尽量来自少量高质量片段,来源信息能追溯到原文。若不同片段存在冲突,应在提示词中要求模型指出冲突,而不是自行“平均”出一个答案。
从异常现象反推故障位置
当系统“答非所问”时,先检查检索结果,而不是立刻修改提示词。如果前几名候选就没有答案,问题多半出在解析、切分、Embedding、索引或查询表达;如果候选里有正确证据但排序靠后,应检查召回策略和重排。
如果正确证据已经进入最终上下文,模型仍遗漏、误解或编造事实,再检查上下文顺序、提示约束与生成模型。若答案正确但来源错误,则优先核对元数据在切分、入库和拼接过程中是否保持一一对应。
RAG 的核心不是给模型外挂一个向量数据库,而是建立“知识处理 → 召回 → 筛选 → 证据拼接 → 受约束生成”的可观测流程。只有每一阶段都能单独验证,知识库问答才具备可调试性。