
大模型应用开发 / 系统课时
搭建知识检索
搭建知识检索
本节完成一个可运行的最小知识检索链路:把 Markdown 文档解析为可检索分块,生成向量进行召回,再做轻量重排,并把来源信息整理成可供回答展示的引用。
学习目标
- 串起文档解析、分块、向量化、召回、重排和引用生成的完整链路。
- 理解召回分数与重排分工,并能调整
top_k和最终返回数量。 - 为每个检索结果保留稳定来源信息,避免回答有内容却无法追溯。
明确检索链路的数据流
知识检索不是“把整篇文档交给模型”。更稳妥的做法是先把文档拆成带来源元数据的小块,再把用户问题与这些分块映射到同一向量空间进行粗召回,最后用更关注问题相关性的规则或模型重排。
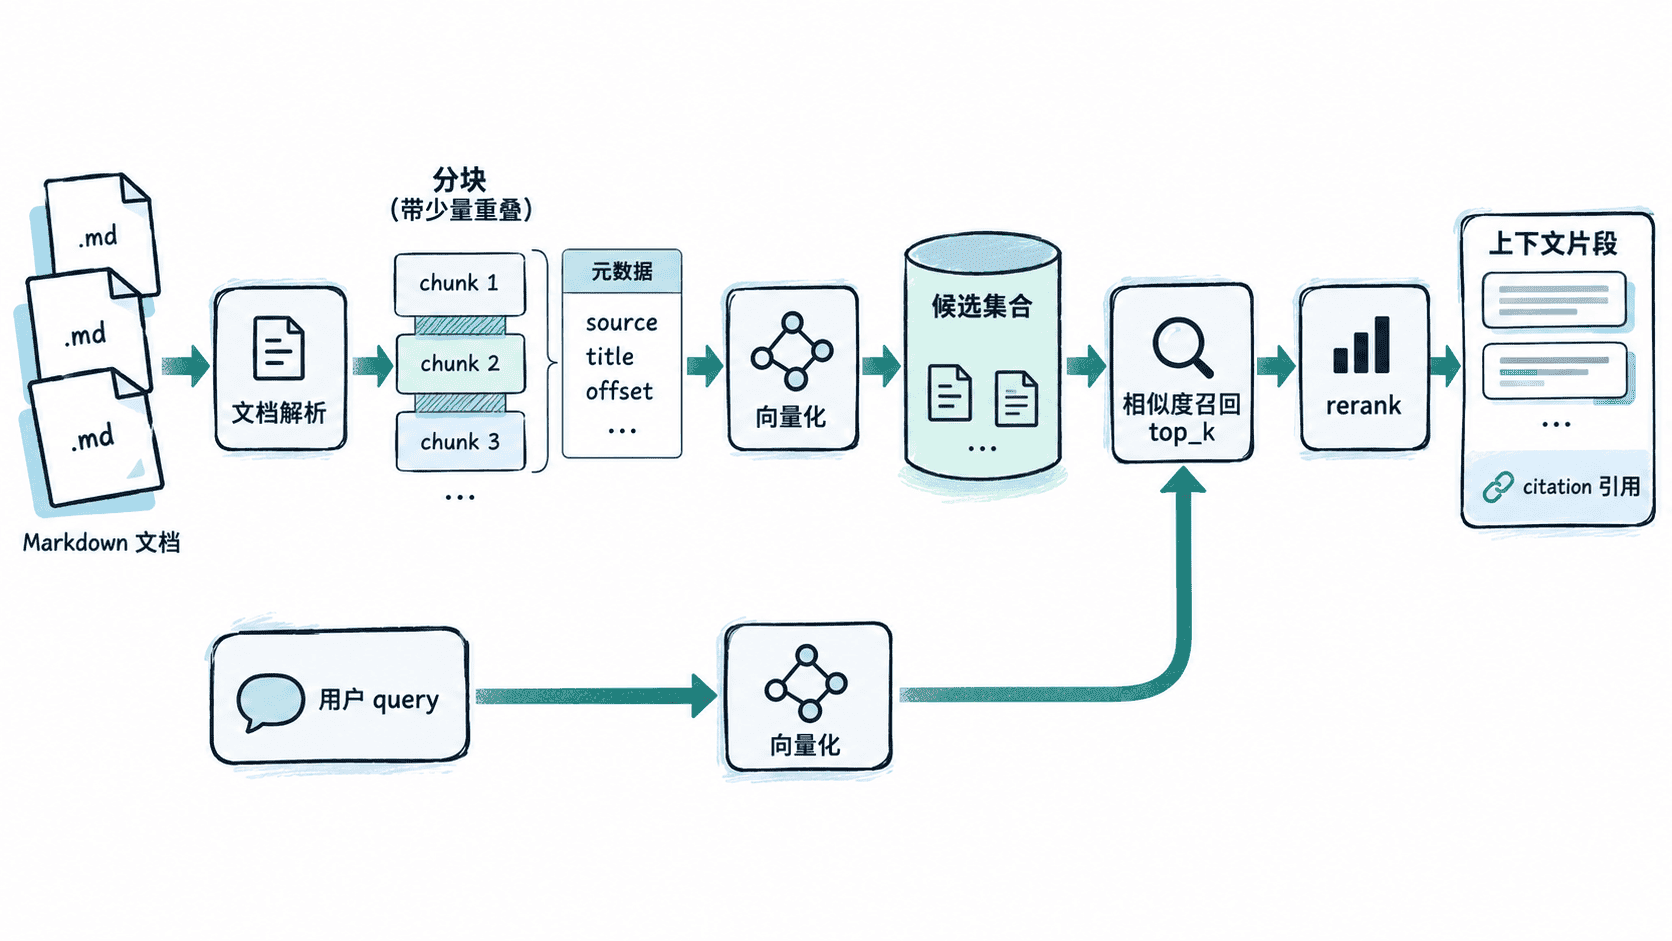
真正需要长期保存时,向量通常写入向量数据库;本节先用内存数据结构演示流程,以便把注意力放在检索逻辑和引用契约上。
实现最小检索流水线
下面的示例只依赖 Python 标准库。为了可直接运行,示例用字符二元组构造稀疏向量,并用余弦相似度模拟向量召回;生产环境可把 vectorize 替换为 embedding API,把候选存储替换为向量数据库。
from collections import Counter
from math import sqrt

DOCUMENTS = [
    {
        "source": "refund.md",
        "text": "# 退款规则\n用户申请退款后,系统先校验订单状态和支付渠道。符合条件时进入退款处理。",
    },
    {
        "source": "order.md",
        "text": "# 订单查询\n订单查询支持按订单号读取状态、金额和最近更新时间。",
    },
    {
        "source": "shipping.md",
        "text": "# 配送规则\n订单发货后可以查询物流状态和承运商信息。",
    },
]

def parse_markdown(doc):
    lines = doc["text"].splitlines()
    return {
        "source": doc["source"],
        "title": lines[0].removeprefix("# ").strip(),
        "content": "".join(lines[1:]).strip(),
    }

def split_chunk(section, max_chars=60, overlap=10):
    text = section["content"]
    chunks = []
    start = 0
    while start < len(text):
        end = min(start + max_chars, len(text))
        chunks.append({**section, "content": text[start:end], "offset": start})
        if end == len(text):
            break
        start = end - overlap
    return chunks

def bigrams(text):
    normalized = "".join(ch for ch in text.lower() if not ch.isspace())
    return [normalized[i:i + 2] for i in range(len(normalized) - 1)]

def vectorize(text):
    return Counter(bigrams(text))

def cosine(a, b):
    dot = sum(value * b.get(key, 0) for key, value in a.items())
    norm_a = sqrt(sum(value * value for value in a.values()))
    norm_b = sqrt(sum(value * value for value in b.values()))
    return dot / (norm_a * norm_b) if norm_a and norm_b else 0.0

def retrieve(query, chunks, top_k=3):
    query_vector = vectorize(query)
    ranked = []
    for chunk in chunks:
        text = chunk["title"] + chunk["content"]
        ranked.append((cosine(query_vector, vectorize(text)), chunk))
    ranked.sort(key=lambda item: item[0], reverse=True)
    return ranked[:top_k]

def rerank(query, candidates, top_n=2):
    # 重排阶段增加业务关键词命中权重,模拟更昂贵的相关性判断。
    keywords = ["订单", "状态", "退款", "查询"]
    rescored = []
    for dense_score, chunk in candidates:
        text = chunk["title"] + chunk["content"]
        matched = sum(1 for word in keywords if word in query and word in text)
        rescored.append((dense_score + 0.15 * matched, chunk))
    rescored.sort(key=lambda item: item[0], reverse=True)
    return [chunk for _, chunk in rescored[:top_n]]

def citation(chunk):
    return f'[{chunk["source"]}#{chunk["title"]}]'

sections = [parse_markdown(doc) for doc in DOCUMENTS]
chunks = [chunk for section in sections for chunk in split_chunk(section)]

query = "如何查询订单状态,以及退款前要检查什么?"
results = rerank(query, retrieve(query, chunks))

print("检索结果:")
for index, item in enumerate(results, 1):
    print(f'{index}. {item["title"]} | {item["source"]}')
print("引用:", " ".join(citation(item) for item in results))
预期输出
检索结果:
1. 订单查询 | order.md
2. 退款规则 | refund.md
引用: [order.md#订单查询] [refund.md#退款规则]
这里的分块很短,所以每篇文档只产生一个分块;当正文超过 max_chars 时,下一块会保留 overlap 个字符,减少答案跨边界时的信息损失。
区分召回、重排与引用
召回阶段追求“别漏掉”,因此 top_k 通常比最终上下文数量大;重排阶段追求“把真正相关的放前面”,可以使用交叉编码器、LLM 相关性评分或业务规则。两者使用同一套评分方式,往往会浪费重排层的价值。
引用元数据不能在最后临时猜测。至少应在分块阶段保留 source、标题或锚点,以及能定位原文的位置;如果文档来自网页、数据库或对象存储,还应保存稳定文档 ID 和版本信息。模型最终只负责引用已经检索到的来源,不负责创造来源。
验收检索质量
验收时不要只看“能不能搜到”。准备一组真实问题,至少记录目标文档是否进入召回集、重排后是否位于前列、最终引用是否能回到原文。若召回缺失,优先检查解析、分块和向量表示;若召回正确但排序差,再调整重排。
当这条链路稳定后,再把内存向量替换为正式 embedding 与向量数据库即可;只要分块和引用元数据契约保持不变,上层回答逻辑无需跟着存储实现一起重写。