
大模型应用开发 / 系统课时
缓存重复结果
缓存重复结果
重复请求如果每次都重新调用模型,会浪费延迟和费用。本节从精确缓存入手,再说明何时使用语义缓存,以及如何通过 TTL、版本号和数据变更让旧结果及时失效。
学习目标
- 能判断请求适合精确缓存还是语义缓存
- 能设计包含模型、提示词版本和业务参数的缓存键
- 能为缓存设置 TTL 与主动失效条件
先判断结果能不能复用
缓存适合输入稳定、输出允许复用、底层事实不会快速变化的请求,例如固定说明文案、知识库中低频变更的公共问答或确定性格式转换。若响应强依赖实时库存、权限、账户状态或刚写入的数据,就必须把这些变化因素纳入缓存键,或者直接绕过缓存。
精确缓存要求请求在规范化后完全一致,命中最安全;语义缓存允许“意思相近”的问题共享结果,命中率更高,但必须承担误复用风险。只有当业务允许近似等价、且可以通过元数据过滤和相似度阈值控制边界时,才适合语义缓存。
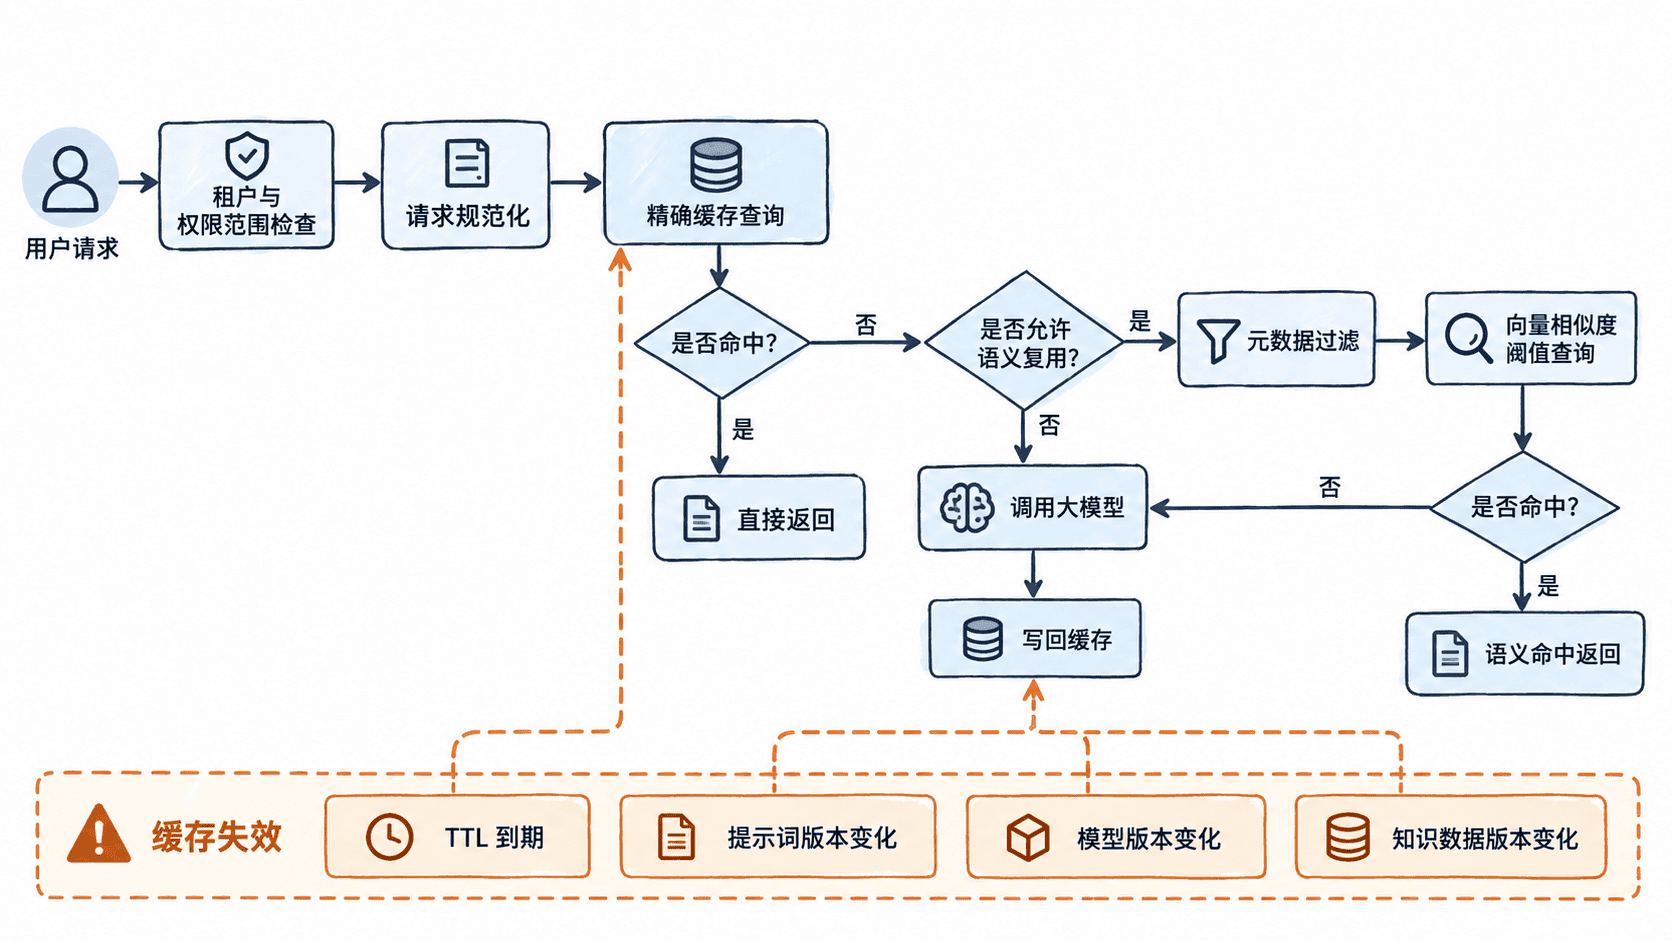
用版本化缓存键避免脏命中
缓存键不能只用用户问题文本。至少要包含会改变结果的模型标识、提示词版本、业务参数和访问范围。下面的精确缓存示例把这些因素序列化后计算 SHA-256,并用 TTL 控制过期时间。
import hashlib
import json
from dataclasses import dataclass

@dataclass
class Entry:
    value: str
    expires_at: int

class ExactCache:
    def __init__(self):
        self._data = {}

    @staticmethod
    def make_key(model, prompt_version, payload):
        # 排序并压缩 JSON,保证字段顺序不同但语义相同的请求得到同一精确键。
        normalized = json.dumps(
            payload,
            ensure_ascii=False,
            sort_keys=True,
            separators=(",", ":"),
        )
        raw = f"{model}|{prompt_version}|{normalized}".encode("utf-8")
        return hashlib.sha256(raw).hexdigest()

    def set(self, key, value, now, ttl_seconds):
        # TTL 从写入时刻计算,避免把永久缓存当成默认策略。
        self._data[key] = Entry(value=value, expires_at=now + ttl_seconds)

    def get(self, key, now):
        entry = self._data.get(key)
        # 过期项在读取时淘汰;生产系统也可交给缓存服务自动过期。
        if entry is None or now >= entry.expires_at:
            self._data.pop(key, None)
            return None
        return entry.value

cache = ExactCache()
payload = {"tenant": "demo", "question": "What is the refund policy?"}

key_v1 = cache.make_key("model-a", "prompt-v1", payload)
cache.set(key_v1, "Returns are accepted within 30 days.", now=100, ttl_seconds=30)

key_v2 = cache.make_key("model-a", "prompt-v2", payload)

print(f"hit@110={cache.get(key_v1, now=110)!r}")
print(f"prompt_v2={cache.get(key_v2, now=110)!r}")
print(f"expired@131={cache.get(key_v1, now=131)!r}")
预期输出
hit@110='Returns are accepted within 30 days.'
prompt_v2=None
expired@131=None
第一次读取命中;同一个问题换成 prompt-v2 后,因为版本进入了缓存键,不会错误复用旧结果;时间超过 TTL 后,原缓存也失效。实际系统还应把语言、工具权限、知识库版本或其他会改变答案的参数纳入键或失效条件。
语义缓存要先做安全边界
语义缓存通常先把请求转成向量,再搜索相似历史请求。真正决定能否复用的不是“向量距离足够近”这一条,而是范围过滤和相似度判断同时成立。至少先限定同租户、同权限域、同任务类型、同知识版本,再比较语义相似度。
例如“如何重置密码”和“管理员如何重置他人密码”词面很接近,但权限边界完全不同。此类请求即使向量很相似,也不应该共享缓存。对于高风险、强实时或强个性化回答,优先使用精确缓存,甚至完全禁用响应缓存。
把失效规则当成缓存设计的一部分
TTL 适合处理“多久以后结果可能变旧”;版本号适合处理提示词、模型、知识库或业务规则的发布;主动失效适合数据更新后立即清理相关键。三者通常组合使用,而不是只依赖一个很长的 TTL。
上线后应记录命中率、缓存后延迟、节省的模型调用量,以及因旧答案或误命中导致的质量问题。缓存的目标不是单纯追求高命中率,而是在可证明正确的复用边界内减少重复推理;一旦答案新鲜度或权限隔离无法保证,就应让请求回到模型重新计算。