
大模型应用开发 / 系统课时
配置超时与重试
配置超时与重试
大模型应用一次请求往往要串起检索、模型和工具调用。这里要解决的是:给每一层设置独立时间预算,只对可恢复错误做有限重试,并让整条链路在总截止时间内可预测地结束。
学习目标
- 为模型、检索和工具调用设置分层超时,并受总请求预算约束
- 使用指数退避和最大尝试次数处理短暂故障
- 区分可重试与不可重试错误,避免重试放大故障
先给每一层独立的时间预算
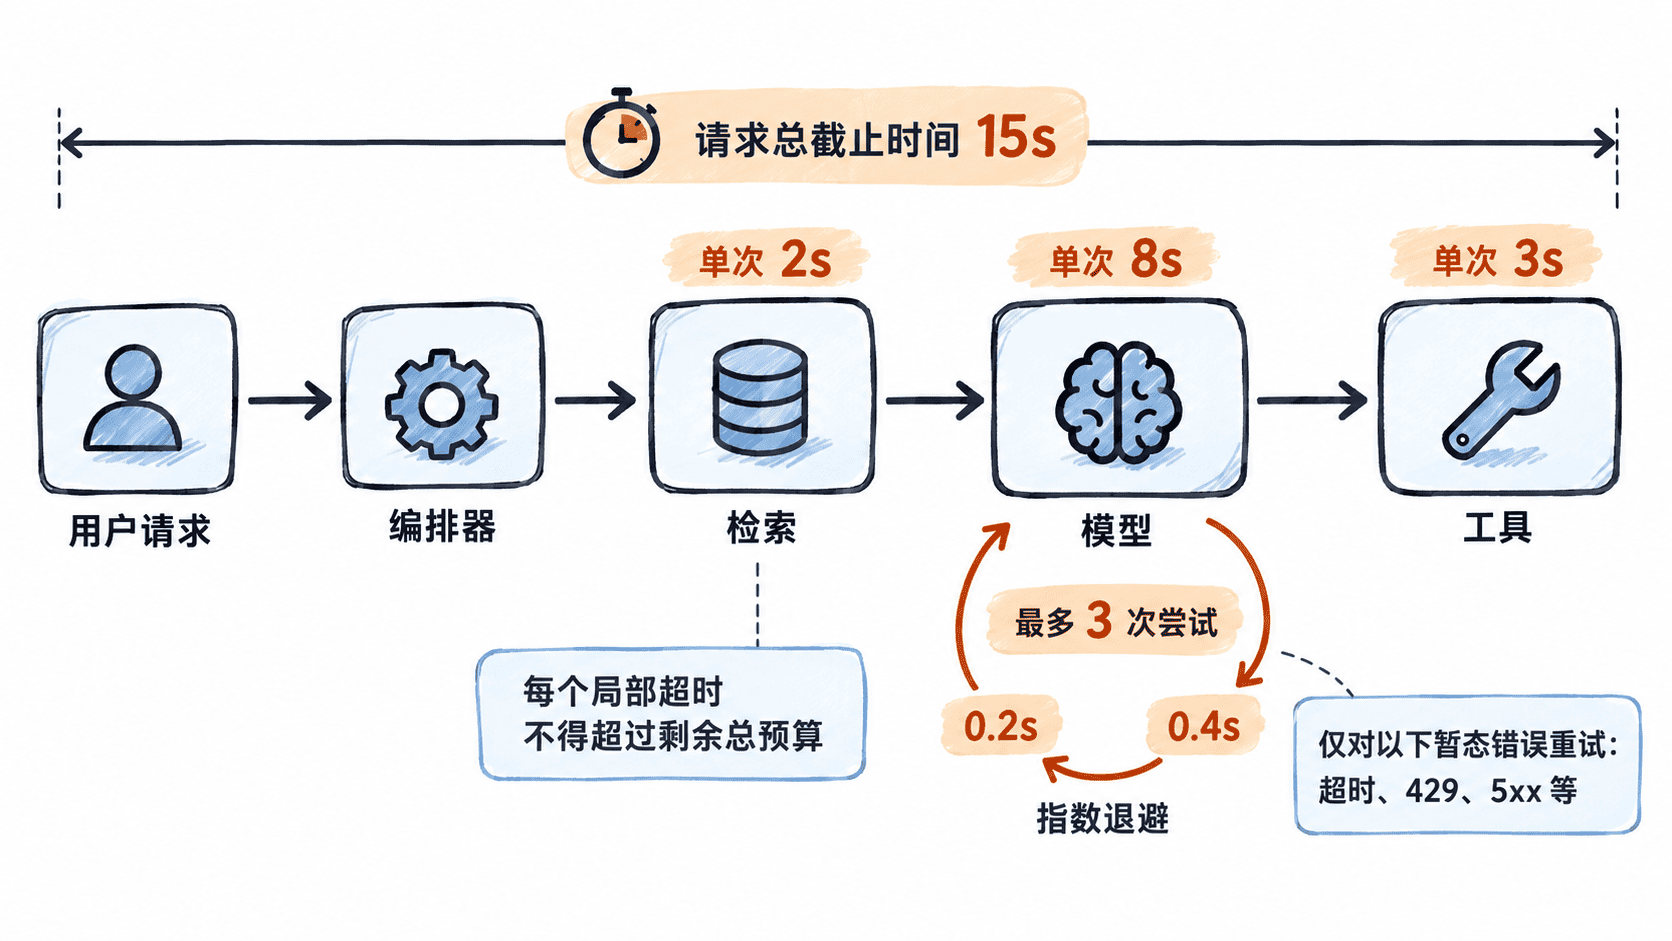
不要只设置一个“全局 30 秒”然后让所有下游共享。更稳妥的做法是先定义请求总预算,再让每次下游调用使用“不超过剩余预算”的局部超时。这样即使某个工具卡住,也不会把整个请求拖到网关超时。
例如,请求总预算可以是 15 秒,检索单次最多 2 秒、模型单次最多 8 秒、工具单次最多 3 秒。若前序步骤已经消耗 10 秒,后续模型调用就不能再完整占用 8 秒,而应服从剩余的 5 秒。
把重试限制在可恢复错误
超时、限流、临时网络错误和部分 5xx 通常可以重试;参数校验失败、认证失败、明确的业务拒绝则不应重试。对会产生副作用的工具调用,还要先确认幂等性,否则“重试一次”可能变成“下单两次”或“重复扣款”。
max_attempts=3 应理解为“最多调用三次”,而不是首次调用之外再重试三次。退避等待应逐次增加,并设置上限;生产环境通常还会加入少量随机抖动,避免大量请求在同一时刻再次冲击下游。
用可运行脚本验证
下面的 Python 示例同时展示总请求超时、局部超时、最大尝试次数和指数退避。模型第一次故意超时,第二次成功;检索不重试即可返回。
python
import asyncio
from collections.abc import Awaitable, Callable

async def call_with_retry(
    name: str,
    operation: Callable[[int], Awaitable[str]],
    timeout_s: float,
    max_attempts: int,
) -> str:
    for attempt in range(1, max_attempts + 1):
        try:
            result = await asyncio.wait_for(operation(attempt), timeout=timeout_s)
            print(f"{name}: ok on attempt {attempt}")
            return result
        except TimeoutError:
            print(f"{name}: timeout on attempt {attempt}")
            if attempt == max_attempts:
                raise
            # 指数退避:第 1 次失败等 0.02s,第 2 次失败等 0.04s。
            await asyncio.sleep(0.02 * (2 ** (attempt - 1)))
    raise RuntimeError("unreachable")

async def retrieval(_: int) -> str:
    await asyncio.sleep(0.01)
    return "context"

async def model(attempt: int) -> str:
    # 第一次超过 0.05s 局部超时,第二次在预算内完成。
    await asyncio.sleep(0.08 if attempt == 1 else 0.01)
    return "answer"

async def pipeline() -> str:
    context = await call_with_retry("retrieval", retrieval, 0.05, 1)
    answer = await call_with_retry("model", model, 0.05, 3)
    return f"{context} + {answer}"

async def main() -> None:
    result = await asyncio.wait_for(pipeline(), timeout=0.20)
    print(f"final: {result}")

asyncio.run(main())
预期输出
text
retrieval: ok on attempt 1
model: timeout on attempt 1
model: ok on attempt 2
final: context + answer
实际耗时会受运行环境影响,但调用次数和成功路径应一致。
生产配置要守住的边界
除了单次超时,还应监控总耗时、重试次数、最终失败率和各下游错误类型。出现持续 429 或 5xx 时,继续重试只会加重拥塞,此时应结合熔断、限流或降级策略,而不是无限提高 max_attempts。
分层超时解决“最多等多久”,有限重试解决“短暂失败要不要再试”,总截止时间则保证整条请求链路不会因局部策略失控。
按自己的节奏,确认真正理解。