
大模型应用开发 / 系统课时
恢复失败任务
恢复失败任务
工作流失败后,真正需要解决的不是“再跑一次”,而是判断哪些步骤可以重试、哪些副作用必须补偿、应从哪里继续,以及无法自动恢复的任务如何进入失败队列等待人工处理。本课给出一套可落地的恢复顺序与最小实现。
学习目标
- 区分重试、补偿、断点续跑和失败队列各自解决的问题
- 为工作流保存可恢复的检查点,并避免重复执行已完成步骤
- 按失败类型选择自动恢复或人工介入路径
先按失败性质选择恢复动作
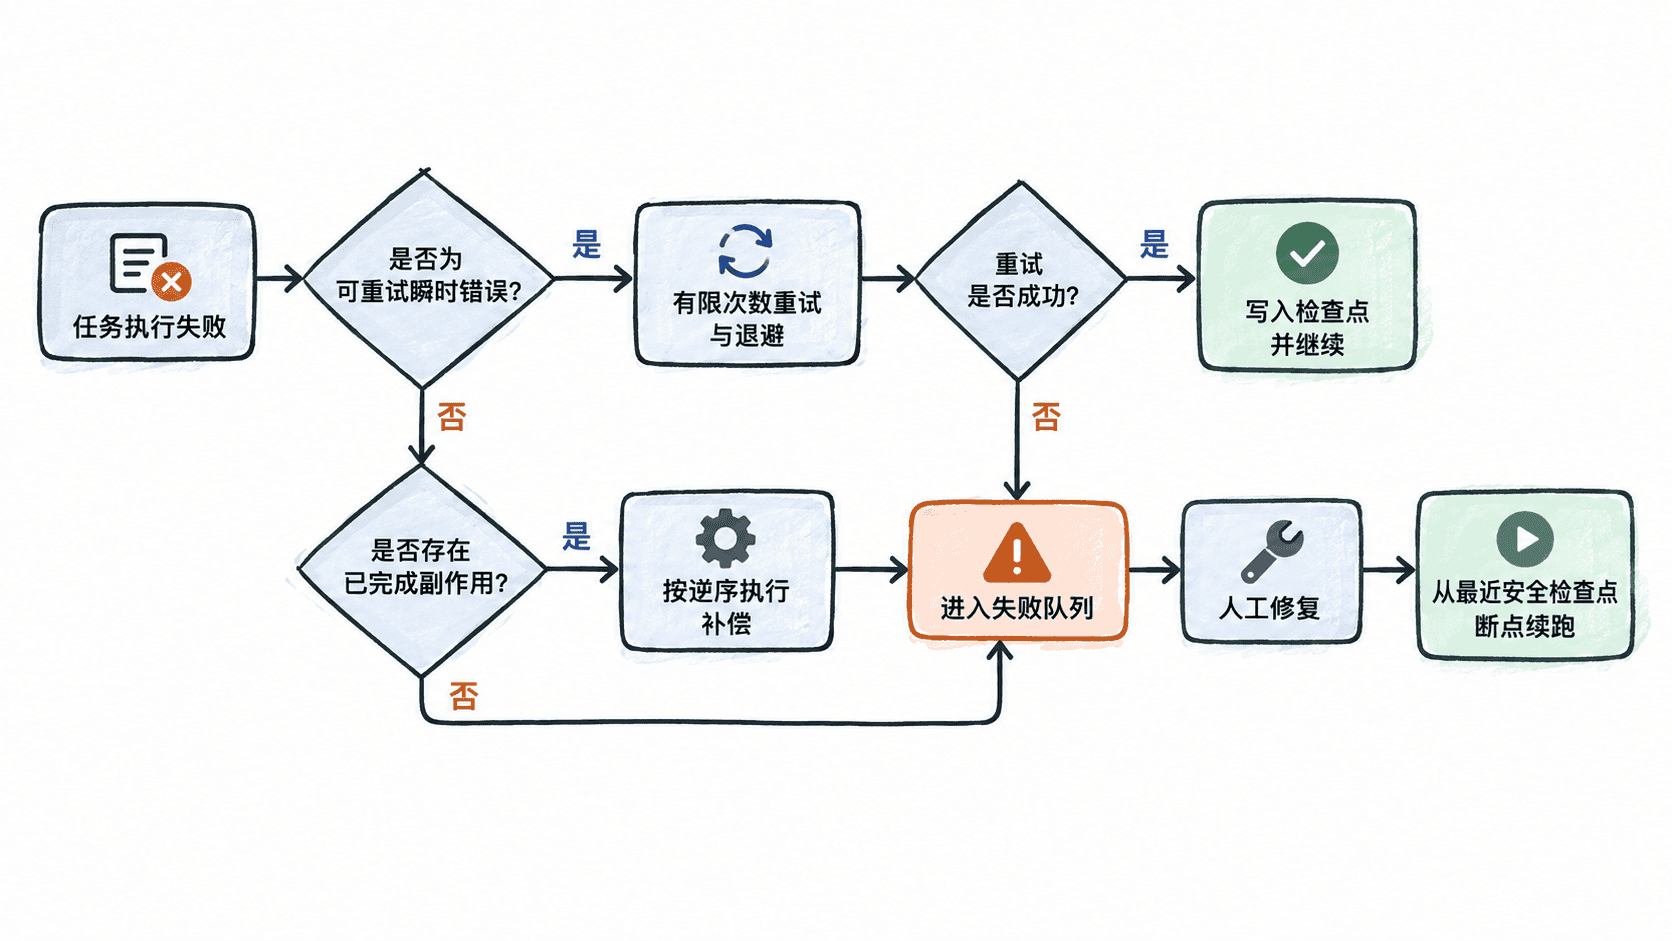
失败恢复的第一步是分类,而不是立刻重跑。网络超时、限流和临时服务不可用通常属于瞬时失败,适合有限次数重试;参数非法、权限不足或业务规则拒绝属于确定性失败,继续重试通常只会重复失败。
如果步骤已经产生外部副作用,例如扣减库存、创建工单或发起支付,还要判断该副作用能否安全撤销。能撤销时准备补偿动作;不能撤销时,不应假装回滚成功,而应保存证据并转入人工处理。
| 恢复手段 | 适用问题 | 关键约束 |
|---|---|---|
| 重试 | 瞬时失败 | 必须限制次数,并配合退避 |
| 补偿 | 已产生可撤销副作用 | 补偿本身也要幂等 |
| 断点续跑 | 长流程中途失败 | 已完成步骤必须有持久化检查点 |
| 失败队列 | 自动恢复仍失败 | 保存任务 ID、失败步骤、错误和上下文 |
用检查点保证断点续跑
检查点记录的是“最后一个已经确认完成的步骤”,而不是“最后一个开始执行的步骤”。只有步骤的结果和必要上下文已经持久化后,才能推进检查点。恢复时从下一个未完成步骤开始,避免重复调用已经成功的外部系统。
下面的示例实现一个最小工作流执行器:步骤成功后写入检查点;可重试异常使用有限重试;超过次数后进入失败队列;再次恢复时从检查点继续。补偿函数也被注册在步骤上,用于确定性失败时逆序撤销已完成副作用。
from dataclasses import dataclass, field
from typing import Callable

class RetryableError(Exception):
    pass

class PermanentError(Exception):
    pass

@dataclass
class Step:
    name: str
    run: Callable[[], None]
    compensate: Callable[[], None]

@dataclass
class WorkflowState:
    task_id: str
    checkpoint: int = -1
    completed: list[int] = field(default_factory=list)

failure_queue: list[dict] = []
attempts = {"charge": 0}
fixed = False

def reserve_inventory():
    print("reserve_inventory: ok")

def release_inventory():
    print("release_inventory: ok")

def charge():
    attempts["charge"] += 1
    if not fixed:
        raise RetryableError("payment gateway timeout")
    print("charge: ok")

def refund():
    print("refund: ok")

def send_receipt():
    print("send_receipt: ok")

def cancel_receipt():
    print("cancel_receipt: skipped")

steps = [
    Step("reserve_inventory", reserve_inventory, release_inventory),
    Step("charge", charge, refund),
    Step("send_receipt", send_receipt, cancel_receipt),
]

def run_workflow(state: WorkflowState, max_retries: int = 2) -> None:
    for index in range(state.checkpoint + 1, len(steps)):
        step = steps[index]
        for attempt in range(1, max_retries + 1):
            try:
                step.run()
                state.checkpoint = index
                state.completed.append(index)
                print(f"checkpoint={state.checkpoint}")
                break
            except RetryableError as exc:
                print(f"{step.name}: retry {attempt}/{max_retries}: {exc}")
        else:
            failure_queue.append({
                "task_id": state.task_id,
                "failed_step": step.name,
                "error": "retry_exhausted",
                "checkpoint": state.checkpoint,
            })
            return
        # 确定性失败应在这里捕获,并按 completed 的逆序调用 compensate。

state = WorkflowState(task_id="task-001")
run_workflow(state)

fixed = True
run_workflow(state)

print("failure_queue:", failure_queue)
预期输出
reserve_inventory: ok
checkpoint=0
charge: retry 1/2: payment gateway timeout
charge: retry 2/2: payment gateway timeout
charge: ok
checkpoint=1
send_receipt: ok
checkpoint=2
failure_queue: [{'task_id': 'task-001', 'failed_step': 'charge', 'error': 'retry_exhausted', 'checkpoint': 0}]
这里第二次调用 run_workflow 时,checkpoint=0,因此不会再次预留库存,而是从支付步骤继续。真实系统应把 WorkflowState 和失败队列写入数据库或持久化队列,不能只保存在进程内存中。
补偿不是数据库回滚
补偿用于撤销已经提交到外部系统的业务动作,例如“释放库存”补偿“预留库存”,“退款”补偿“扣款”。它无法获得数据库事务那样的原子性,因此每个补偿动作都应允许重复执行,并能识别“目标状态已经达成”。
执行补偿时通常按已完成步骤的逆序处理。例如流程完成了 A、B,在 C 发生不可重试错误,就先补偿 B,再补偿 A。若某个补偿失败,不要继续假设整体已经恢复,应记录补偿状态并进入失败队列等待后续处理。
失败队列要保存可恢复证据
失败队列不是错误日志的替代品,而是“待处理任务”的持久化入口。至少应保存任务标识、失败步骤、最近检查点、错误分类、重试次数以及恢复所需的业务上下文。敏感输入只保存必要字段,密钥和令牌不要直接写入队列。
恢复器从失败队列取出任务后,先确认根因已经解除,再依据检查点继续执行。只有工作流最终完成,或补偿后达到明确终态,才能把失败记录标记为已处理。这样恢复过程才是可追踪、可重复执行并且可以人工接管的。