
大模型应用开发 / 系统课时
压缩历史消息
压缩历史消息
当对话历史已经不能继续原样保留时,简单删除会损失用户偏好、项目约束和已经达成的结论。本节把历史拆成滚动摘要、结构化关键事实和最近原文三层,并用一个可运行示例生成可重新组装的压缩记忆。
学习目标
- 能区分摘要、关键事实与最近原文各自应该保存的信息
- 能把较旧消息压缩成稳定记忆,同时保留最近交互的原始细节
- 能为摘要更新、事实覆盖和重新压缩设置明确边界
用三层记忆代替一段超长历史
历史压缩不等于把所有旧消息改写成一段更短的话。更稳妥的做法是按用途分层:滚动摘要保存任务脉络和已完成决策;关键事实保存语言、数据库、用户偏好等可结构化约束;最近若干轮保留原文,避免摘要抹掉本轮正在处理的细节。
原始历史可以继续存放在数据库或日志中作为归档,但不必每次都送给模型。真正进入下一次请求的通常只是“摘要 + 事实 + 最近消息”,这样既能压缩长度,又保留可追溯性。
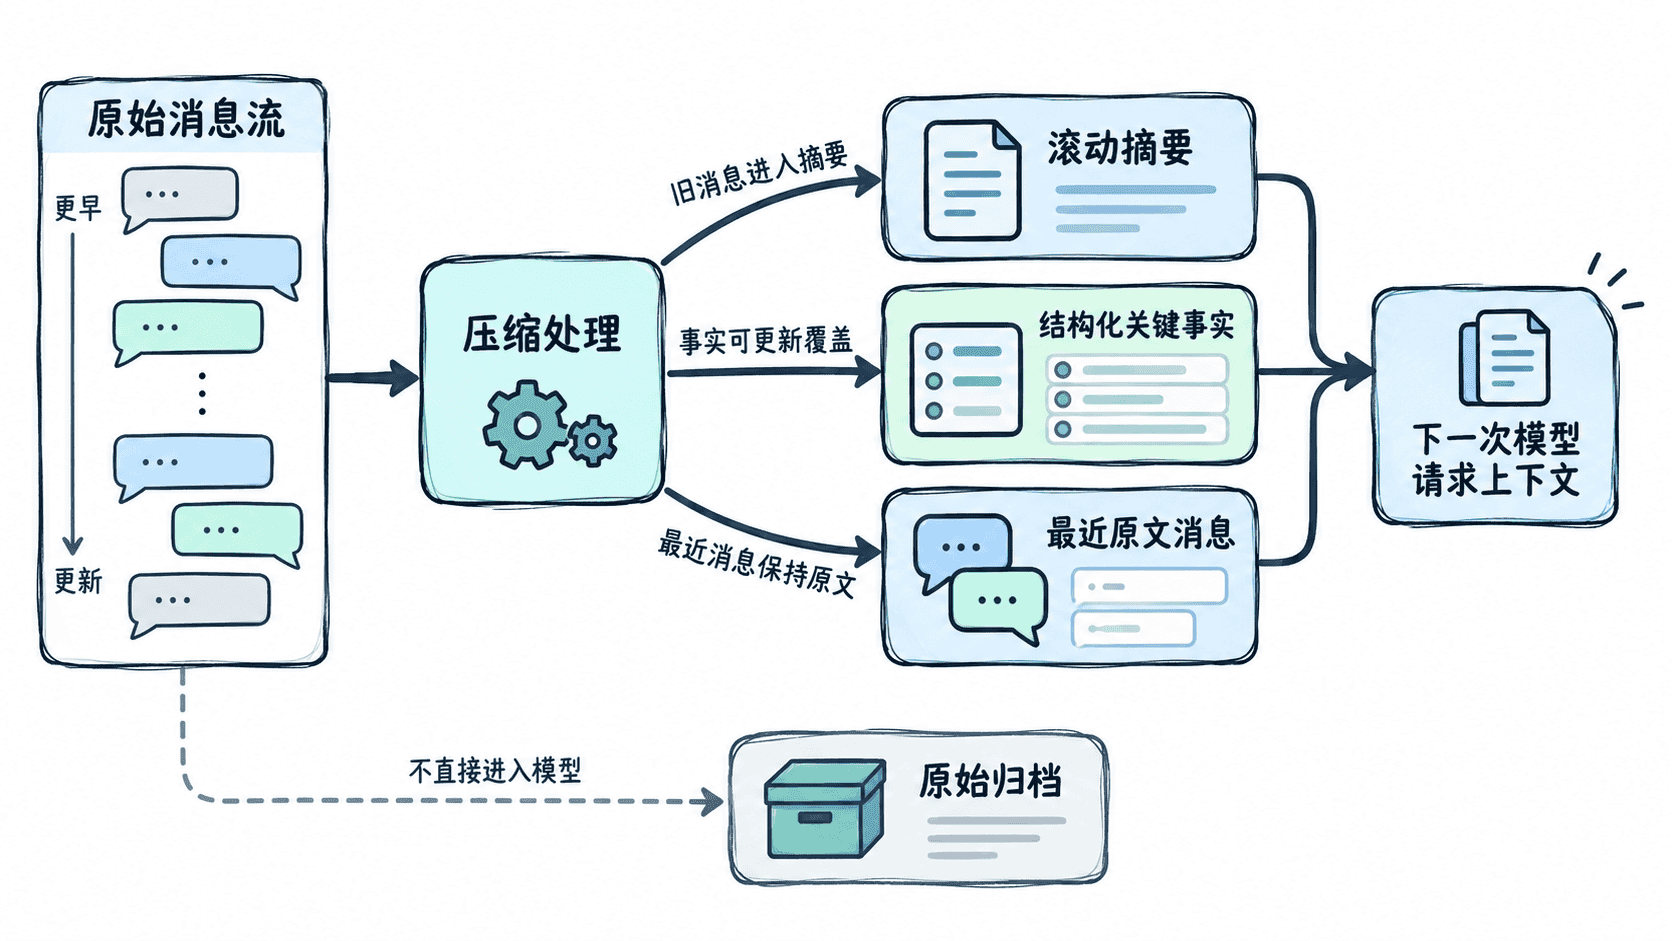
生成摘要、事实和最近原文
下面使用规则提取器演示分层结构,因此可以直接运行并得到确定结果。生产环境通常会把 build_summary 和 extract_facts 替换为模型调用或更可靠的语义抽取器,但输出仍建议保持结构化,避免只有一段不可校验的自由文本。
from __future__ import annotations

import json
import re
from typing import Dict, List

Message = Dict[str, str]

FACT_PATTERN = re.compile(r"记住:([a-zA-Z_][\w-]*)=([^\s。;]+)")
PROJECT_PATTERN = re.compile(r"维护\s+([A-Za-z0-9_-]+)")

def extract_facts(messages: List[Message]) -> Dict[str, str]:
    facts: Dict[str, str] = {}
    for message in messages:
        # 后出现的同名事实覆盖旧值,模拟偏好或配置发生更新。
        for key, value in FACT_PATTERN.findall(message["content"]):
            facts[key] = value
    return facts

def build_summary(old_messages: List[Message], facts: Dict[str, str]) -> str:
    project = None
    for message in old_messages:
        match = PROJECT_PATTERN.search(message["content"])
        if match:
            project = match.group(1)

    parts: List[str] = []
    if project:
        parts.append(f"当前项目:{project}")

    # 只把适合长期复用的稳定事实写进摘要,避免复制全部旧对话。
    for key in ("language", "database"):
        if key in facts:
            parts.append(f"{key}={facts[key]}")

    return ";".join(parts) or "无可复用历史摘要"

def compress_history(history: List[Message], keep_recent: int = 2) -> Dict[str, object]:
    recent = history[-keep_recent:]
    old_messages = history[:-keep_recent]
    facts = extract_facts(history)

    return {
        "summary": build_summary(old_messages, facts),
        "facts": facts,
        "recent": recent,
    }

history = [
    {"role": "user", "content": "我们在维护 order-service。记住:language=Python"},
    {"role": "assistant", "content": "好的,后续示例使用 Python。"},
    {"role": "user", "content": "数据库使用 PostgreSQL。记住:database=PostgreSQL"},
    {"role": "assistant", "content": "收到,我会按 PostgreSQL 给出 SQL。"},
    {"role": "user", "content": "现在把订单查询改成分页。"},
    {"role": "assistant", "content": "可以,接口增加 page 和 pageSize。"},
]

memory = compress_history(history, keep_recent=2)
print(json.dumps(memory, ensure_ascii=False, indent=2))
预期输出
{
  "summary": "当前项目:order-service;language=Python;database=PostgreSQL",
  "facts": {
    "language": "Python",
    "database": "PostgreSQL"
  },
  "recent": [
    {
      "role": "user",
      "content": "现在把订单查询改成分页。"
    },
    {
      "role": "assistant",
      "content": "可以,接口增加 page 和 pageSize。"
    }
  ]
}
这个结果没有把六条消息全部带到下一轮:较旧内容被压成摘要和事实,最新一轮仍保留原文。实际接入模型时,可以把摘要与事实包装成内部上下文,再按原顺序追加最近消息和新的用户请求。
让不同类型的信息按不同规则更新
摘要适合记录“发生过什么”和“当前做到哪里”,它会随着旧消息不断滚动更新;关键事实更像状态表,应该有明确键名、来源和覆盖规则。例如用户把语言从 Python 改成 Java 时,应更新 language,而不是同时保留两个互相冲突的值。
最近原文则不宜过早摘要。正在修改的代码、刚返回的错误信息、用户对上一条回答的指代,都高度依赖原始措辞。通常先保留最近若干轮,只有当它们进入“较旧历史区”后再参与压缩。
什么时候重新压缩
不要每收到一条消息就重写全部历史。常见做法是在输入接近预算阈值、最近原文超过固定轮数,或某个任务阶段结束时触发一次压缩。压缩后要重新计算上下文大小,并确保摘要、事实和最近消息之间没有明显冲突。
如果摘要本身持续增长,也要对摘要再次压缩,而不是让“摘要”最终变成另一份完整历史。长期对话中,原始归档负责追溯,结构化事实负责稳定约束,滚动摘要负责脉络,最近原文负责当前细节;四者职责分开,才能在缩短上下文的同时尽量保住有效信息。