
大模型应用开发 / 系统课时
生成语音输出
生成语音输出
把模型回答转成语音,不只是调用一次 TTS 接口:还要决定音色、语速、编码格式,并把长文本切成可连续播放的小段。本节给出一条可落地的输出链路,让文字回答能稳定进入播放器。
学习目标
- 设计从文本回答到语音分段播放的完整处理链路
- 正确设置音色、语速、音频格式和分段边界
- 用缓冲与队列降低首段等待和播放卡顿
组织语音生成链路
典型流程是:模型先产出文本,再经过清理与分段,逐段提交给语音合成服务,最终把音频片段交给播放器。不要等整篇回答完全生成后再一次性合成,否则首包延迟会明显增加,长文本失败后还需要整体重试。
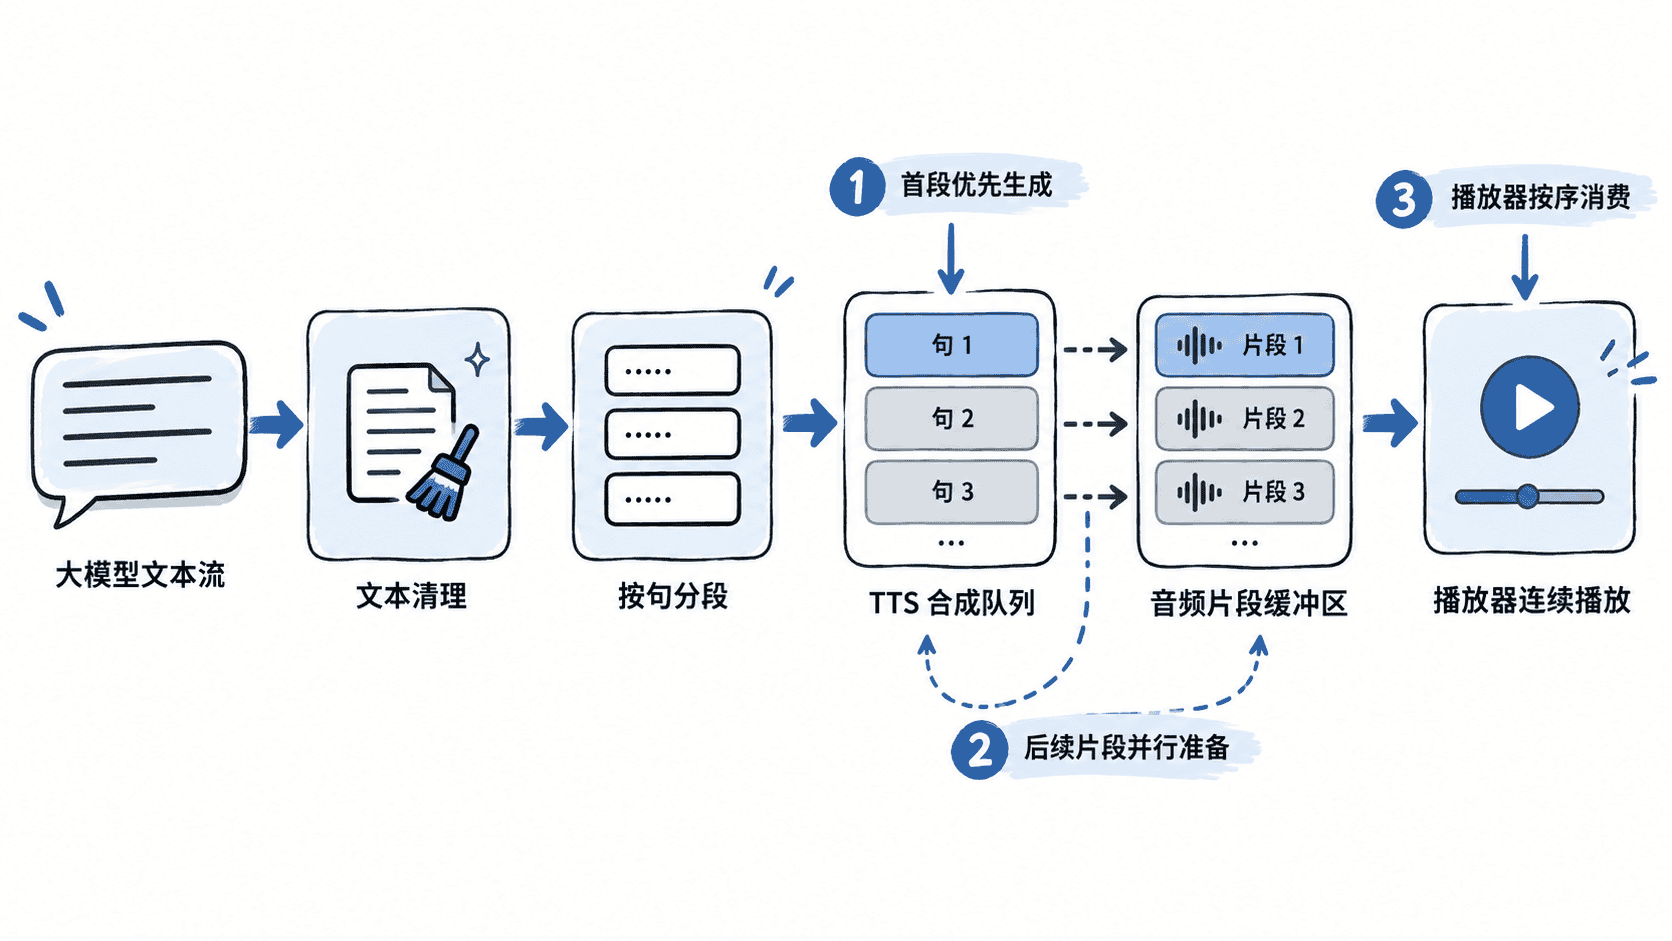
分段最好落在完整句子或自然停顿处。过短会增加请求次数和编码开销,过长又会抬高首段延迟。实际应用可先以 1~3 句话为一段,再根据语言、平均句长和 TTS 服务限制调参。
设置音色、语速与格式
如果语音服务支持多音色,优先把音色作为产品级配置,而不是写死在业务代码中。语速也应设定可接受范围,例如只允许在正常语速附近微调,避免用户输入极端值造成难以理解的输出。
下面用一个与厂商无关的配置对象表达最常见的参数。它是配置示例,不直接执行。
{
  "voice": "neutral-female",
  "rate": 1.05,
  "format": "mp3",
  "sampleRate": 24000,
  "chunkMaxChars": 220
}
voice 表示音色标识,rate 控制语速倍率,format 和 sampleRate 决定编码与播放兼容性,chunkMaxChars 则是文本切段上限。若目标是浏览器和移动端通用播放,MP3 通常兼容性更稳;若强调低延迟,可优先选择服务与播放器都支持的流式编码格式。
验证这类配置时,要同时检查服务端是否接受参数、生成文件能否被目标播放器解码,以及同一段文本在不同语速下是否仍保持自然停顿。
按句切分并保持顺序
分段播放最容易出错的地方不是“能不能生成”,而是“能不能按原顺序播放”。下面的 Python 示例只负责稳定切句和编号,可直接运行,用于构造后续 TTS 队列的输入。
import re

def split_for_tts(text: str, max_chars: int = 80) -> list[str]:
    sentences = [s.strip() for s in re.split(r"(?<=[。!?!?])", text) if s.strip()]
    chunks: list[str] = []
    current = ""

    for sentence in sentences:
        if current and len(current) + len(sentence) > max_chars:
            chunks.append(current)
            current = sentence
        else:
            current += sentence

    if current:
        chunks.append(current)

    return chunks

text = "订单已经创建成功。预计明天下午送达!如果地址有变化,请尽快修改。"
for index, chunk in enumerate(split_for_tts(text, max_chars=20), start=1):
    print(index, chunk)
预期输出:
1 订单已经创建成功。预计明天下午送达!
2 如果地址有变化,请尽快修改。
把 max_chars 调小后可能得到多个片段,实际分段数量取决于文本长度。进入合成队列时要保留序号,播放器只消费“下一个连续序号”的音频片段,避免并发合成完成顺序不同导致语句错位。
控制长回答的播放体验
流式语音通常采用“小缓冲启动”:先生成一到两个片段,播放器开始播放,同时后台继续合成后续片段。缓冲区过小容易因网络抖动停顿,过大又会让用户等待更久才听到第一句话。
还要定义取消策略。用户点击“停止”时,应立即停止播放器,并取消尚未开始的合成任务;如果用户重新提问,旧回答剩余音频也应失效,不能与新回答串音。
处理失败与降级
单个片段合成失败时,不要直接让整次回答失败。更稳妥的做法是对当前片段做有限次数重试;仍失败时跳过语音并保留文字回答,同时给播放器一个明确的结束状态。
对于语音服务超时、音色不可用或格式不兼容,也应有可观测日志,至少记录回答 ID、片段序号、音色、格式和失败原因。这样才能区分是文本切分问题、服务端合成问题,还是客户端播放问题。
最终可把链路理解为三个独立职责:文本层保证语义完整的分段,合成层保证每段可生成且可重试,播放层保证顺序、缓冲和取消。三层分开后,语音输出才容易调优和排错。