
大模型应用开发 / 系统课时
处理多个工具
处理多个工具
当一次请求需要调用两个以上的外部工具时,真正困难的不是“多调用几次”,而是决定哪些可以并行、哪些必须串行,以及如何把不同结果稳定地合并。本节给出一个可落地的调度方法:先识别依赖和副作用,再执行工具,最后统一聚合结果。
学习目标
- 根据数据依赖和副作用判断工具应并行还是串行执行
- 为多工具调用建立稳定的选择、执行和结果聚合流程
- 识别重复写入、资源冲突和部分失败等常见风险
先把工具分成读取与写入
多工具调度的第一步不是追求并发,而是判断每个工具是否会改变外部状态。查询库存、读取价格、获取天气这类只读工具通常可以安全并行;创建订单、发送邮件、修改工单等写入工具则要额外检查依赖、幂等性和冲突范围。
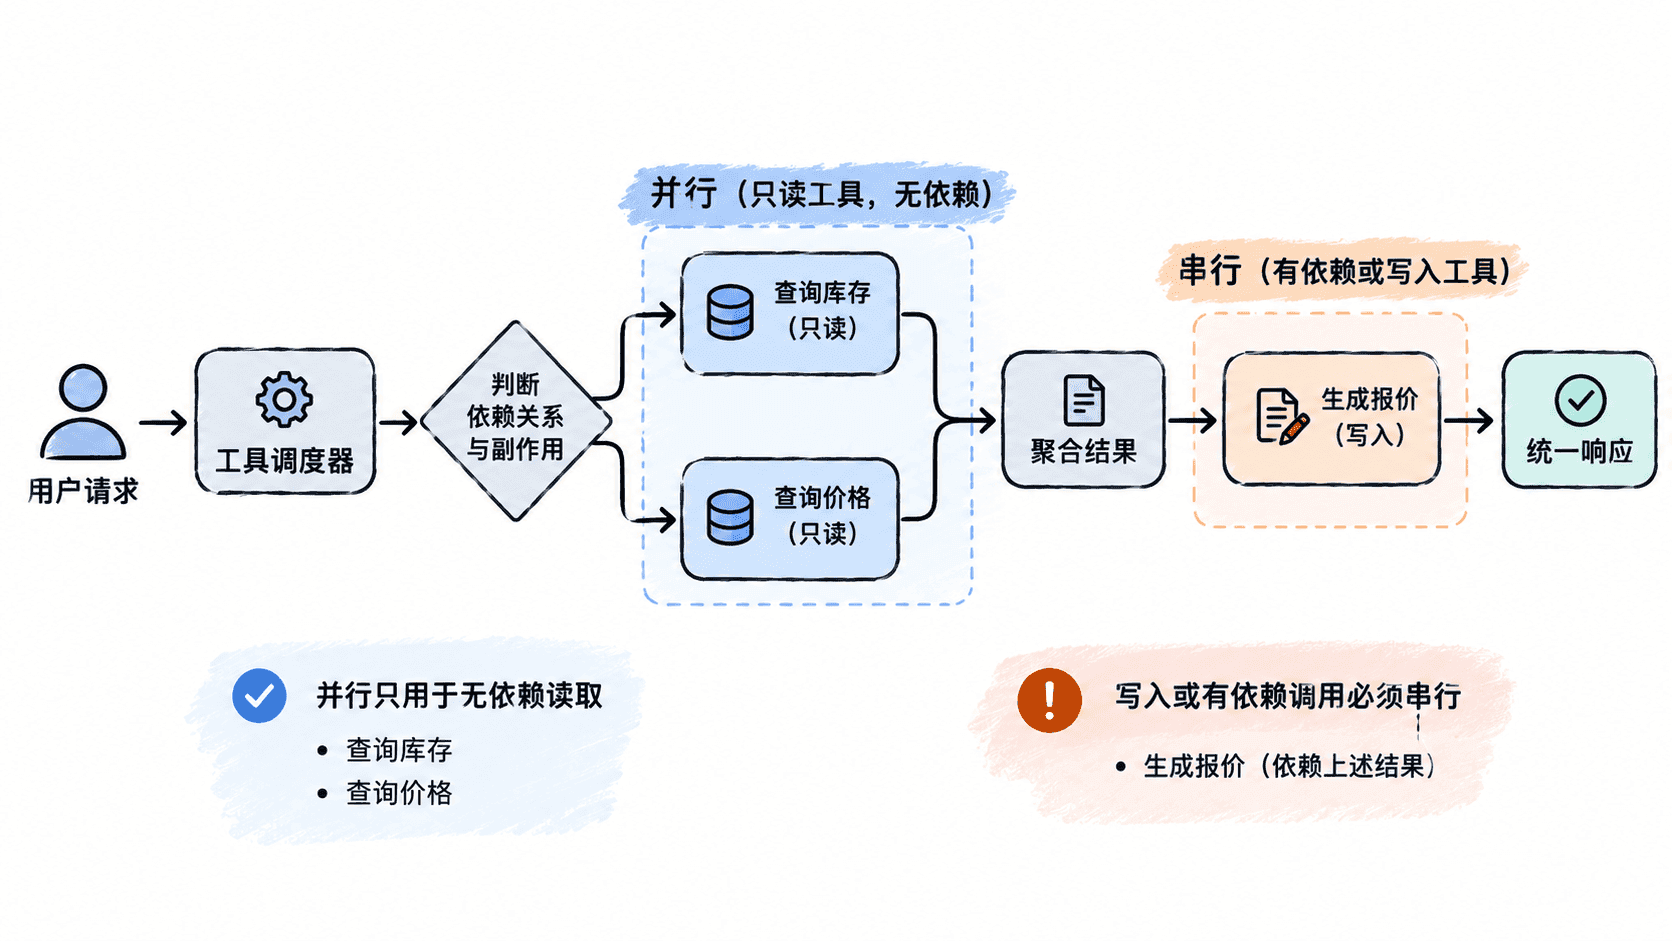
同一批调用如果没有前后依赖,并且只读取互不影响的数据,可以使用并行执行。后一个工具需要前一个工具的输出时必须串行。例如“先查库存和价格,再生成报价”中,库存与价格可以并行,但生成报价必须等待两者完成。
用执行阶段表达依赖
下面的完整示例把调用计划拆成两个阶段:第一阶段并行读取库存和价格,第二阶段使用聚合后的结果生成报价。示例中的工具是本地函数,可以直接用 Node.js 运行,因此重点只放在调度逻辑上。
const tools = {
  getInventory: async ({ sku }) => ({ sku, available: 8 }),
  getPrice: async ({ sku }) => ({ sku, unitPrice: 199 }),
  createQuote: async ({ sku, quantity, unitPrice }) => ({
    sku,
    quantity,
    total: quantity * unitPrice,
    status: "created"
  })
};

async function run() {
  const sku = "demo-sku";
  const quantity = 2;

  // 无数据依赖的只读工具并行执行,减少总等待时间。
  const [inventory, price] = await Promise.all([
    tools.getInventory({ sku }),
    tools.getPrice({ sku })
  ]);

  if (inventory.available < quantity) {
    throw new Error("库存不足,停止创建报价");
  }

  // 写操作依赖前两项结果,因此必须放在读取完成之后。
  const quote = await tools.createQuote({
    sku,
    quantity,
    unitPrice: price.unitPrice
  });

  console.log(JSON.stringify({ inventory, price, quote }, null, 2));
}

run().catch((error) => {
  console.error(error.message);
  process.exitCode = 1;
});
预期输出
{
  "inventory": {
    "sku": "demo-sku",
    "available": 8
  },
  "price": {
    "sku": "demo-sku",
    "unitPrice": 199
  },
  "quote": {
    "sku": "demo-sku",
    "quantity": 2,
    "total": 398,
    "status": "created"
  }
}
真实工具的响应时间和字段可能不同,但调度原则不变:先完成当前阶段中可并行的调用,再把经过校验的结果传给后续阶段。
聚合结果时保留来源与失败状态
模型最终需要的是“可解释的上下文”,而不是一堆无法追踪来源的文本。聚合层至少应保留工具名、成功或失败状态,以及真正需要传回模型的数据。这样其中一个工具失败时,可以明确决定是整体终止、降级回答,还是仅重试失败工具。
还要避免把多个工具的原始输出直接拼接成超长提示词。先做字段筛选、格式统一和长度限制,只把回答当前问题所需的数据交给模型,既减少上下文开销,也降低不同工具返回互相矛盾信息时的混乱。
防止工具之间互相冲突
同一个资源上的多个写操作默认不要并行。例如“取消订单”和“修改收货地址”如果同时作用于同一订单,就可能出现执行顺序不确定、后写覆盖前写或状态检查失效。此类调用应由应用侧设置资源级串行化、状态前置条件或幂等键,而不是让模型自行猜测顺序。
当模型提出多个工具调用时,可以按三条规则决策:无依赖的只读调用并行;有数据依赖的调用按拓扑顺序串行;会修改同一资源的调用进入受控写入通道。这样既能获得并行带来的延迟收益,又不会用不可控的并发换取数据一致性风险。