
大模型应用开发 / 系统课时
记录调用日志
记录调用日志
调用日志的目标不是“把所有输入输出都存下来”,而是让一次大模型调用可追踪、可定位、可审计,同时避免把密钥、隐私和完整提示词写进日志。本节会建立一份最小但够用的结构化日志,并验证脱敏后的记录结果。
学习目标
- 设计能串起一次调用的日志字段,包括请求标识、模型参数、耗时、用量和状态
- 在日志落盘前过滤密钥、用户隐私和不必要的正文内容
- 用结构化 JSON 日志快速定位失败请求
先确定一条日志该记录什么
一条调用日志至少要回答三个问题:这是谁的一次请求、调用时发生了什么、最终结果如何。建议记录 request_id、模型名、关键推理参数、开始与结束时间、总耗时、输入与输出令牌数、状态和错误类型。
不要默认记录完整 Prompt、用户消息、API Key 或模型原始响应。排障确实需要正文时,应先做字段级授权,再采用脱敏、截断或采样策略。日志的长期价值来自稳定字段,而不是无限堆积文本。
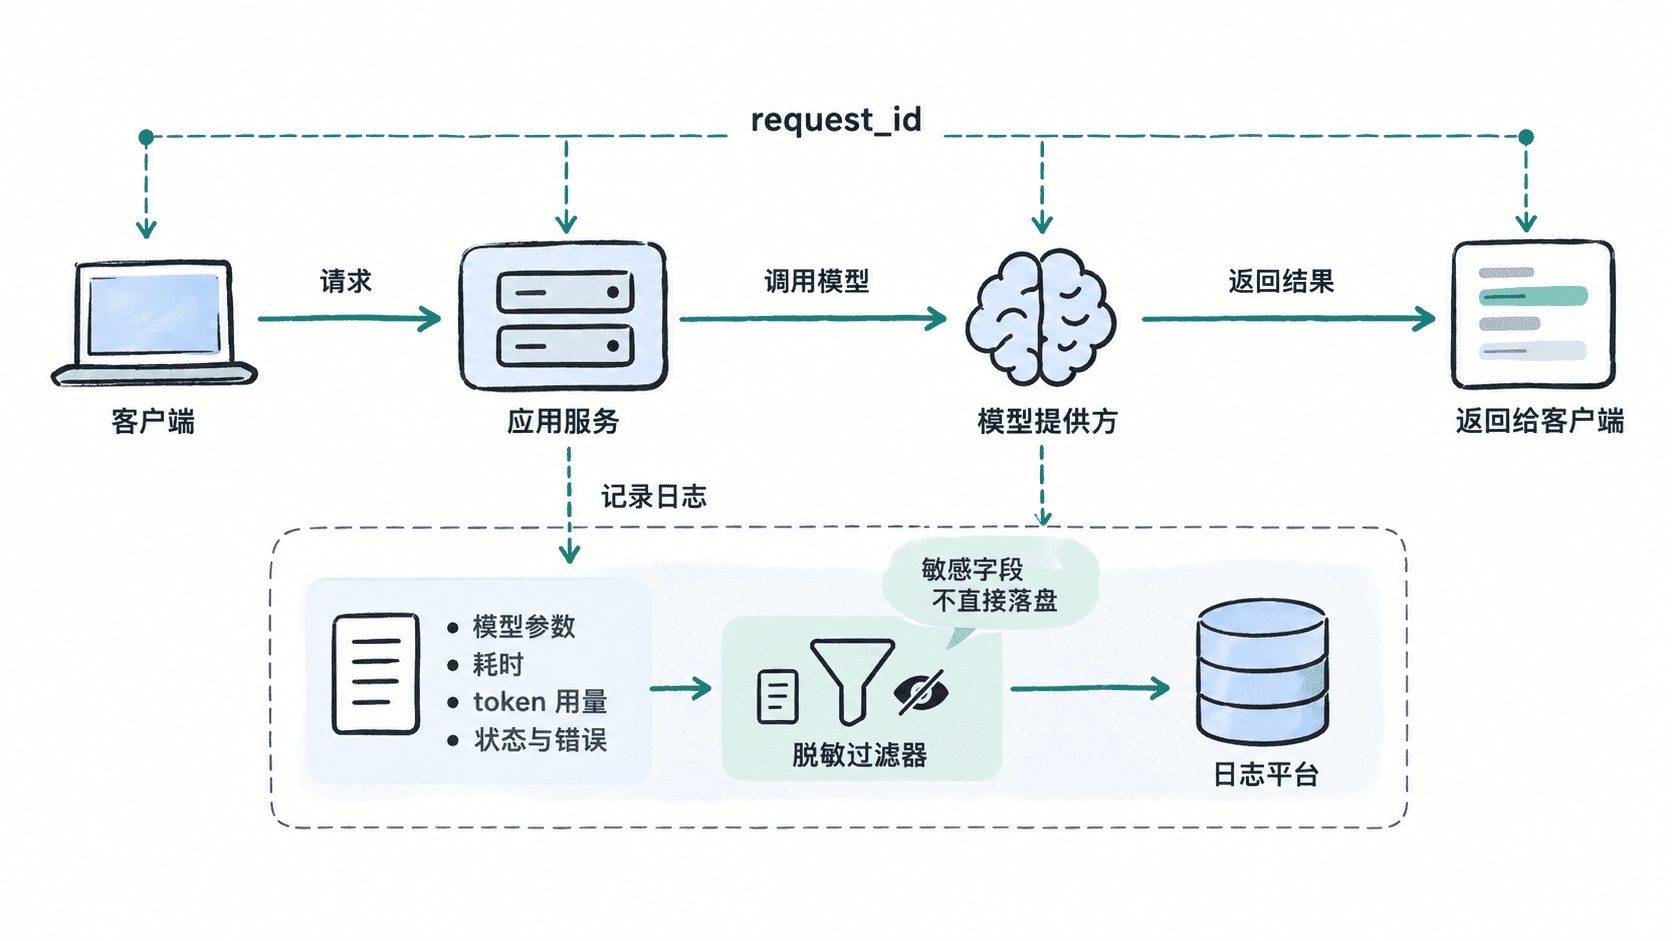
用结构化日志记录一次调用
下面用 Python 模拟一次模型调用。示例重点是日志字段与脱敏策略,call_model 用固定结果代替真实 SDK,因此可直接运行,不依赖外部服务。
import json
import time
import uuid

def call_model(prompt: str) -> dict:
    # 示例仅模拟模型返回,便于专注观察日志结构。
    time.sleep(0.02)
    return {"text": "退款可在订单页申请。", "input_tokens": 18, "output_tokens": 11}

request_id = str(uuid.uuid4())
prompt = "用户邮箱 alice@example.com,询问退款流程。"
started = time.perf_counter()

try:
    result = call_model(prompt)
    elapsed_ms = round((time.perf_counter() - started) * 1000, 1)
    log = {
        "request_id": request_id,
        "model": "demo-model",
        "temperature": 0.2,
        "duration_ms": elapsed_ms,
        "input_tokens": result["input_tokens"],
        "output_tokens": result["output_tokens"],
        "status": "success",
        "prompt_preview": "[REDACTED]",
    }
except Exception as exc:
    log = {
        "request_id": request_id,
        "model": "demo-model",
        "status": "error",
        "error_type": type(exc).__name__,
    }

print(json.dumps(log, ensure_ascii=False))
预期输出
{"request_id": "<ID>", "model": "demo-model", "temperature": 0.2, "duration_ms": <VALUE>, "input_tokens": 18, "output_tokens": 11, "status": "success", "prompt_preview": "[REDACTED]"}其中 <ID> 和 <VALUE> 每次运行可能不同。关键点是请求标识和统计字段保留,而原始邮箱与完整 Prompt 没有进入日志。
让日志真正可用于排障
生产环境中应保证入口请求日志、模型调用日志和错误日志都携带同一个 request_id。出现异常时,先按请求标识聚合,再查看 status、error_type、模型参数和耗时,而不是全文搜索用户内容。
错误日志还应区分可重试与不可重试类型,例如超时、限流、认证失败和输入校验失败。若所有失败都只写成 error,后续无法统计主要故障来源,也很难决定是否自动重试。
检查日志是否合格
上线前可以抽查三类请求:正常请求、模型超时、输入非法。合格的日志应能通过 request_id 串起调用过程,成功请求含耗时和用量,失败请求含明确错误类型,同时搜索不到 API Key、完整用户消息或未脱敏的个人信息。
日志的设计原则可以压缩成一句话:记录定位问题所需的最少事实,而不是记录所有能拿到的数据。