
大模型应用开发 / 系统课时
设计降级策略
设计降级策略
降级不是简单地“失败后换个模型”。本篇要建立一条可验证的降级链:主模型不可用或过慢时依次尝试备用模型、确定性规则,最后才返回明确的友好提示,同时记录每次降级原因。
学习目标
- 设计主模型、备用模型、规则结果和友好提示的降级顺序
- 为每一级降级定义触发条件与质量边界
- 通过可运行示例验证不同故障场景下的最终输出
先定义可接受的降级层级
常见顺序是主模型优先,主模型失败后切备用模型;若所有模型都不可用,只对少量确定性问题返回规则结果;仍无法可靠回答时,明确告知用户服务暂不可用并提供下一步动作。
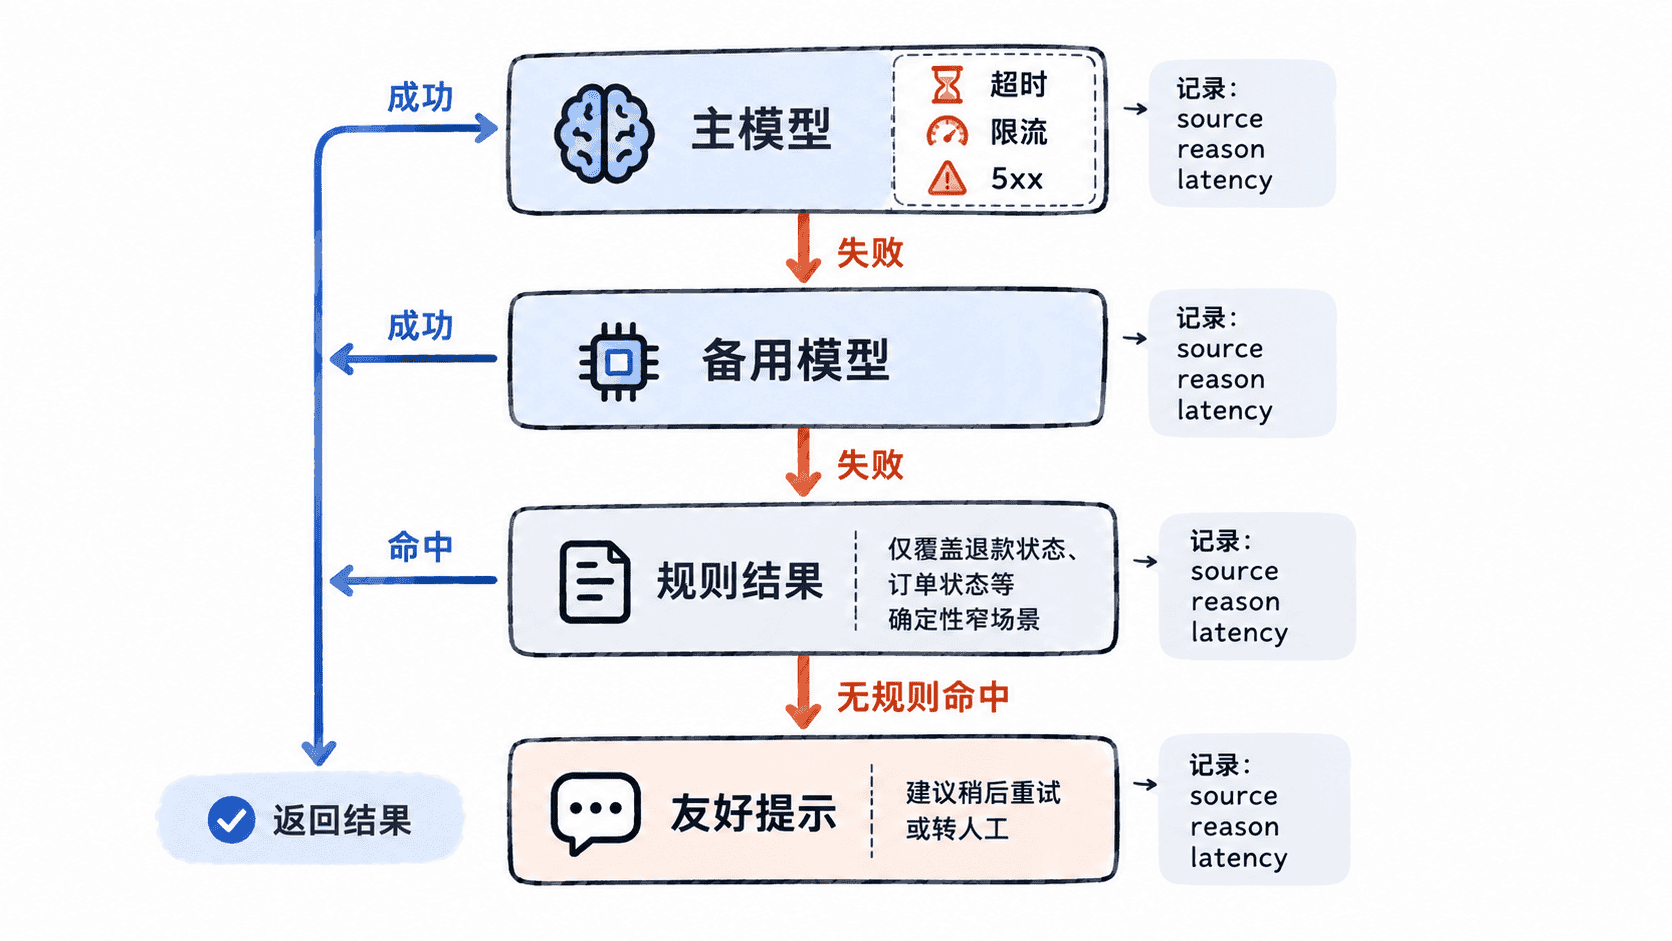
降级层级越靠后,能力通常越弱,因此必须同时降低承诺。备用模型可以继续生成开放式回答;规则结果只能处理预先定义的窄场景;友好提示则不应伪装成业务答案。
为每一级设定触发条件
| 层级 | 典型触发条件 | 输出要求 |
|---|---|---|
| 主模型 | 正常路径 | 完整回答 |
| 备用模型 | 主模型超时、限流或暂态 5xx | 能力可下降,但语义仍需满足任务 |
| 规则结果 | 模型均不可用且问题命中确定规则 | 只返回可验证、低风险结果 |
| 友好提示 | 无可靠结果可返回 | 明确失败,不编造答案,并提供后续动作 |
不要用一个宽泛的 except Exception 把所有错误都静默吞掉。认证失败、配置错误等问题通常需要尽快暴露;只有预期内的暂态故障才适合触发自动降级。
用可运行脚本实现降级链
下面的示例用四种场景验证不同降级层级。主模型在非正常场景下故意超过局部超时,备用模型只在指定场景成功,因此可以直接观察主模型、备用模型、规则和友好提示四条路径。
python
import asyncio

class ServiceUnavailable(Exception):
    pass

async def primary_model(query: str, scenario: str) -> str:
    if scenario != "primary_ok":
        await asyncio.sleep(0.10)  # 模拟主模型响应过慢。
    else:
        await asyncio.sleep(0.01)
    return f"主模型回答:{query}"

async def backup_model(query: str, scenario: str) -> str:
    await asyncio.sleep(0.01)
    if scenario != "backup_ok":
        raise ServiceUnavailable("backup unavailable")
    return f"备用模型回答:{query}"

def rule_answer(query: str) -> str | None:
    # 规则只覆盖可以确定性回答的窄场景。
    if "退款" in query:
        return "可在订单详情页查看退款状态。"
    return None

async def answer(query: str, scenario: str) -> tuple[str, str]:
    try:
        text = await asyncio.wait_for(
            primary_model(query, scenario),
            timeout=0.05,
        )
        return "primary", text
    except TimeoutError:
        pass

    try:
        return "backup", await backup_model(query, scenario)
    except ServiceUnavailable:
        pass

    rule = rule_answer(query)
    if rule is not None:
        return "rule", rule

    return "friendly", "当前智能服务暂不可用,请稍后重试或转人工。"

async def main() -> None:
    cases = [
        ("如何修改地址", "primary_ok"),
        ("如何修改地址", "backup_ok"),
        ("如何查询退款状态", "all_models_fail"),
        ("解释量子力学", "all_models_fail"),
    ]
    for query, scenario in cases:
        source, text = await answer(query, scenario)
        print(f"{source}: {text}")

asyncio.run(main())
预期输出
text
primary: 主模型回答:如何修改地址
backup: 备用模型回答:如何修改地址
rule: 可在订单详情页查看退款状态。
friendly: 当前智能服务暂不可用,请稍后重试或转人工。
把降级做成可观测能力
每次返回结果都应附带内部可观测信息,例如 fallback_level、触发原因、下游耗时和最终是否成功。监控中一旦备用模型命中率突然升高,即使用户仍然能拿到答案,也说明主链路已经退化。
可用的降级策略不是一串 try/except,而是一份明确的质量契约:每一级知道何时接管、能回答到什么程度,以及什么时候必须停止生成并如实提示用户。
按自己的节奏,确认真正理解。