
大模型应用开发 / 系统课时
采集运行指标
采集运行指标
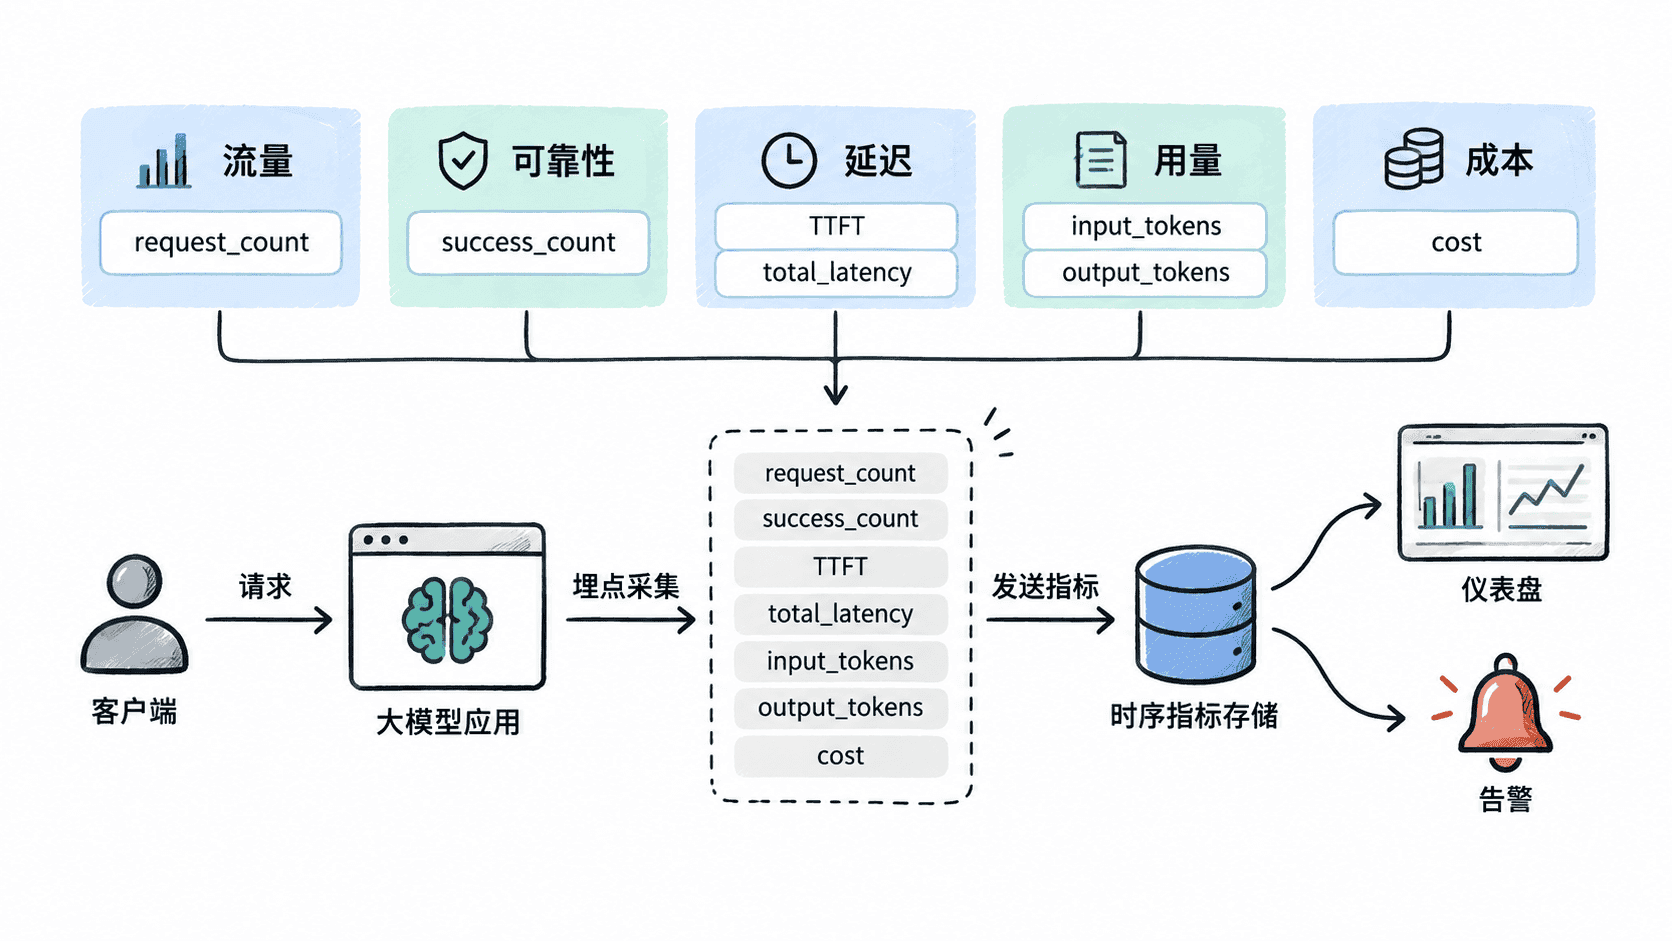
运行指标用来回答“系统现在健康吗、慢在哪里、成本是否异常”。与逐请求日志不同,指标关注可聚合的趋势。本节建立请求量、成功率、首字延迟、总耗时、令牌用量和单位成本六类指标,并用一个最小示例计算结果。
学习目标
- 区分流量、可靠性、延迟、用量和成本指标的职责
- 正确计算成功率、首字延迟、总耗时和单位请求成本
- 为告警与容量判断选择可聚合的指标维度
建立最小指标集合
请求量回答系统承受了多少流量;成功率反映可用性;首字延迟 TTFT 反映用户多久看到第一个 token;总耗时反映完整请求完成速度。令牌用量决定模型负载,而单位成本把资源消耗转换为可比较的业务指标。
这些指标不能只看平均值。延迟至少应观察 P50、P95 或 P99,因为少量慢请求会被平均值掩盖。成功率也应按模型、接口和错误类型切分,但不要把 request_id、用户 ID 这类高基数字段作为指标标签,否则会造成时序数据爆炸。
用样本数据计算核心指标
下面的 Python 示例模拟四次请求,并计算请求量、成功率、P95 总耗时、平均 TTFT、总令牌数和平均单位成本。真实系统中这些原始数据通常由 SDK 中间件或服务端埋点自动上报。
from statistics import mean

samples = [
    {"ok": True, "ttft_ms": 120, "total_ms": 680, "in_tokens": 320, "out_tokens": 90, "cost": 0.0041},
    {"ok": True, "ttft_ms": 150, "total_ms": 720, "in_tokens": 280, "out_tokens": 100, "cost": 0.0040},
    {"ok": False, "ttft_ms": 0, "total_ms": 410, "in_tokens": 0, "out_tokens": 0, "cost": 0.0},
    {"ok": True, "ttft_ms": 210, "total_ms": 950, "in_tokens": 360, "out_tokens": 140, "cost": 0.0052},
]

request_count = len(samples)
success_count = sum(1 for item in samples if item["ok"])
success_rate = success_count / request_count
successful = [item for item in samples if item["ok"]]
avg_ttft = mean(item["ttft_ms"] for item in successful)
total_tokens = sum(item["in_tokens"] + item["out_tokens"] for item in samples)
avg_cost = sum(item["cost"] for item in samples) / request_count

# 小样本演示:按最接近 95% 位置取值,不代表生产级直方图算法。
latencies = sorted(item["total_ms"] for item in samples)
p95_total = latencies[-1]

print(f"requests={request_count}")
print(f"success_rate={success_rate:.2%}")
print(f"avg_ttft_ms={avg_ttft:.1f}")
print(f"p95_total_ms={p95_total}")
print(f"total_tokens={total_tokens}")
print(f"avg_cost={avg_cost:.4f}")
预期输出
requests=4
success_rate=75.00%
avg_ttft_ms=160.0
p95_total_ms=950
total_tokens=1290
avg_cost=0.0033
这个结果说明四次请求中有一次失败,成功率只有 75%;成功请求首字延迟平均 160 ms,最慢请求总耗时 950 ms。实际生产环境的 P95 应由直方图或监控系统按时间窗口计算,而不是像小样本示例一样直接取最大值。
指标维度要能解释问题
建议保留 model、endpoint、status、error_type、region 等低基数维度。这样当成功率下降时,可以进一步判断是否集中在某个模型或接口;当成本上升时,也能查看是否由输出令牌增长造成。
单位成本可以按请求、会话或业务动作定义。例如每请求成本为 总模型费用 / 请求数,每成功请求成本则为 总模型费用 / 成功请求数。定义一旦进入仪表盘和告警,就应保持口径稳定,否则不同时间段无法直接比较。
用指标设置可行动的告警
告警要对应明确动作。成功率持续低于目标值时检查错误类型和上游状态;P95 TTFT 突增时检查排队、网络和模型侧延迟;单位成本突然上涨时优先检查输入长度、输出长度和模型路由是否变化。
最终要得到的不是“监控项越多越好”,而是一组能够稳定回答流量、成功率、体验和成本变化的指标。先把六类核心指标做准,再按实际故障补充新的观测信号。