
大模型应用开发 / 系统课时
缩短输入上下文
缩短输入上下文
输入上下文越长,推理成本和首 token 延迟通常越高。本节把上下文拆成系统指令、历史消息、检索片段和当前问题,建立明确预算,并用代码演示只保留真正影响回答的内容。
学习目标
- 能识别输入上下文中最常见的冗余来源
- 能按预算裁剪历史消息与检索片段
- 能用质量指标验证缩短上下文没有伤害回答
先拆清输入从哪里来
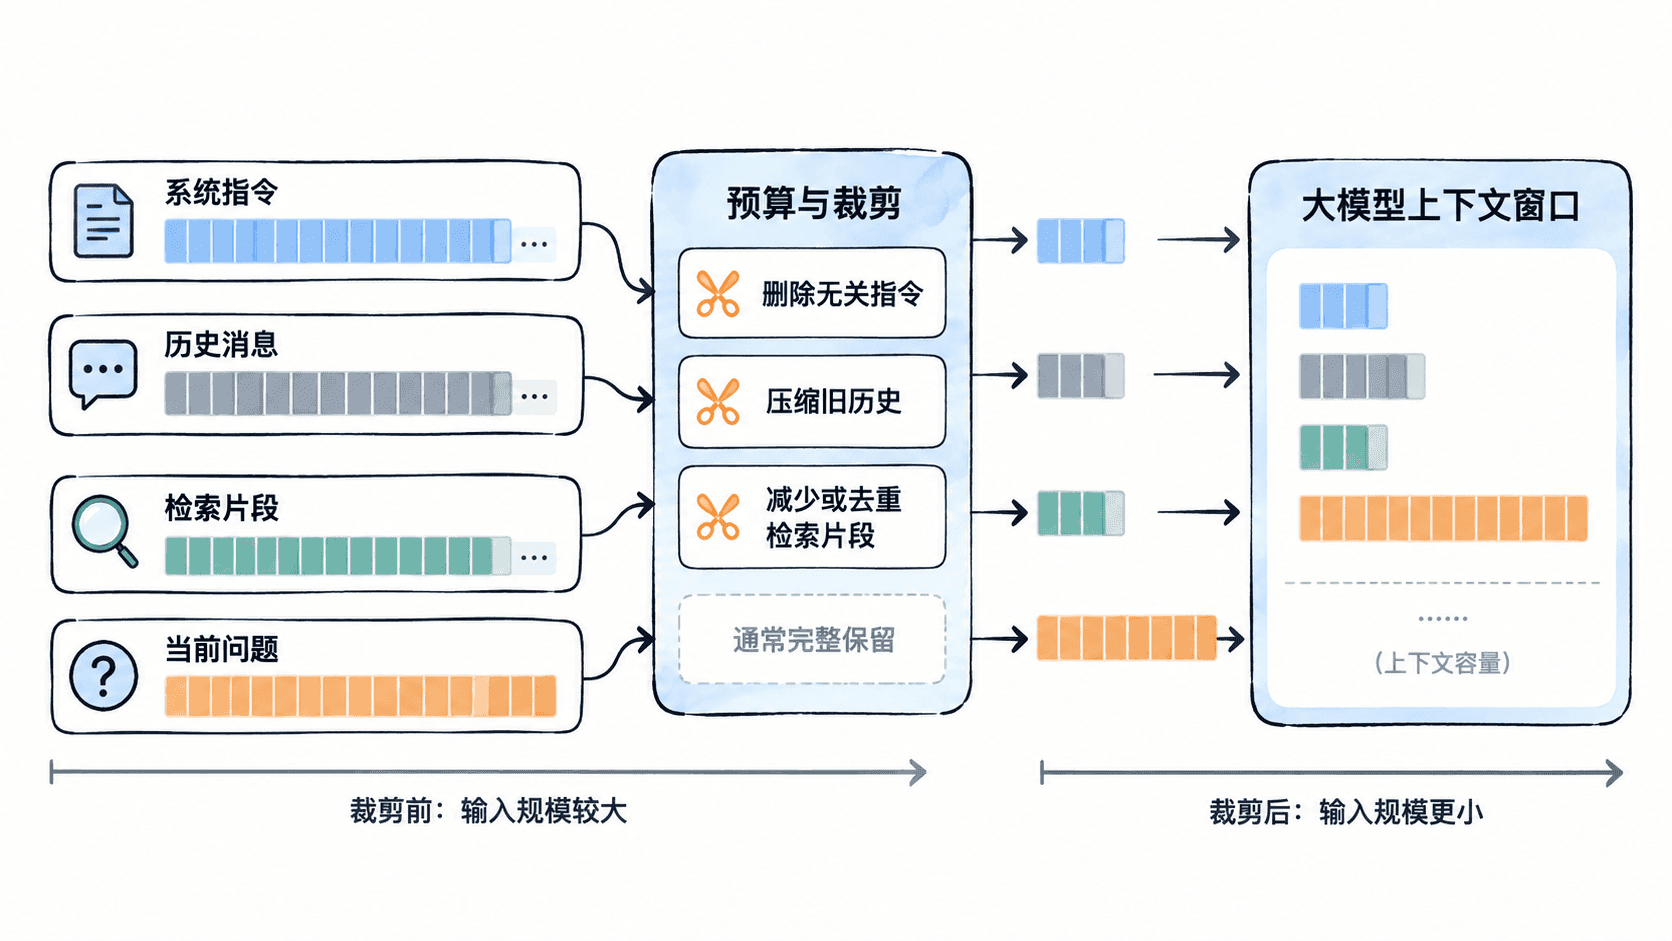
一次请求的输入通常由四部分组成:系统指令、对话历史、检索上下文和当前用户消息。可以把输入规模近似看成 。优化重点不是把每一部分都压到最短,而是删除不会改变正确答案的内容。
系统指令优先保留角色边界、输出格式、安全约束和当前任务规则;背景介绍、重复措辞和已经被更高优先级规则覆盖的句子可以删除。历史消息保留仍会影响指代、约束和偏好的部分;检索片段只保留回答当前问题所需的证据。
按预算组装上下文
最稳妥的做法是在调用模型之前统一组装上下文,而不是让每个业务模块无限追加文本。下面的示例只保留最近两条历史消息和前两个检索片段,确保“裁剪策略”集中在一个地方。
def build_context(system_instruction, history, snippets, user_message,
                  max_history_messages=2, max_snippets=2):
    # 系统指令先做空白归一化,真正的语义删减应在规则设计阶段完成。
    compact_instruction = " ".join(system_instruction.split())
    # 历史和检索片段都在请求组装阶段执行硬预算,避免下游继续累加。
    kept_history = history[-max_history_messages:]
    kept_snippets = snippets[:max_snippets]

    lines = [f"System: {compact_instruction}", "History:"]
    lines.extend(f"{role}: {content}" for role, content in kept_history)
    lines.append("Retrieved:")
    lines.extend(kept_snippets)
    lines.append(f"User: {user_message}")
    return "\n".join(lines), kept_history, kept_snippets

history = [
    ("user", "Tell me the product background."),
    ("assistant", "It is a hosted API."),
    ("user", "Compare option A and option B."),
    ("assistant", "A is cheaper; B is faster."),
]
snippets = [
    "doc-1: A costs less per request.",
    "doc-2: B has lower median latency.",
    "doc-3: Company history and office locations.",
]

context, kept_history, kept_snippets = build_context(
    "Answer with one recommendation and one reason.",
    history,
    snippets,
    "Which option should I choose?",
)

print(f"history_messages={len(kept_history)}")
print(f"retrieval_snippets={len(kept_snippets)}")
print(context)
预期输出
history_messages=2
retrieval_snippets=2
System: Answer with one recommendation and one reason.
History:
user: Compare option A and option B.
assistant: A is cheaper; B is faster.
Retrieved:
doc-1: A costs less per request.
doc-2: B has lower median latency.
User: Which option should I choose?
这个例子故意没有把第三个检索片段送进模型,因为“公司历史和办公地点”与当前选择无关。生产环境不应只按固定条数裁剪,而应同时设置 token 预算、相关性阈值和最小证据覆盖要求,并使用所选模型对应的 tokenizer 计算真实 token 数。
分别处理三类冗余
删除指令冗余时,先合并重复规则,再删除与当前任务无关的背景说明。不要为了省 token 删除输出结构、合规约束或决定答案口径的条件,否则模型可能变得更便宜,却更难预测。
压缩历史消息时,可保留最近若干轮原文,把更早对话压成结构化摘要,例如“已确认需求、未解决问题、用户约束”。摘要必须可覆盖关键事实;涉及数字、权限、承诺或精确配置时,关键原文应单独保留,避免摘要漂移。
减少检索片段时,优先做去重、相关性排序和片段级截断。不要把“top-k 越小越好”当成目标:若问题需要多个证据源,过度压缩会让回答缺少依据。更合理的是先定义最低证据覆盖,再在覆盖要求内压缩长度。
用质量门槛验证节省是否成立
优化前后至少同时观察输入 token、首 token 延迟、总延迟和任务质量。对有标准答案的场景可以比较准确率或事实一致性;对生成任务可以维护一组回归样例,检查关键约束是否仍被满足。
一次有效的缩短通常表现为:输入 token 明显下降,质量指标基本不变,延迟和费用同步下降。如果质量先恶化,再低的 token 数也只是把必要信息删掉了。最终应把“上下文预算”当成请求组装的固定约束,而不是上线后才做的临时清理。