
大模型应用开发 / 系统课时
设计用户记忆
设计用户记忆
用户记忆的目标不是“把所有对话永久保存”,而是把真正跨会话有价值的信息提炼出来,并在需要时安全地取回。合理的设计要同时区分短期上下文与长期记忆,控制哪些内容可写、何时读取、如何更新,以及如何避免过期事实持续影响模型。
学习目标
- 区分短期上下文与长期用户记忆的职责边界
- 设计“候选提取、校验、写入、检索、注入”的记忆链路
- 为偏好与业务事实设置更新、过期和删除规则
先划清短期上下文与长期记忆
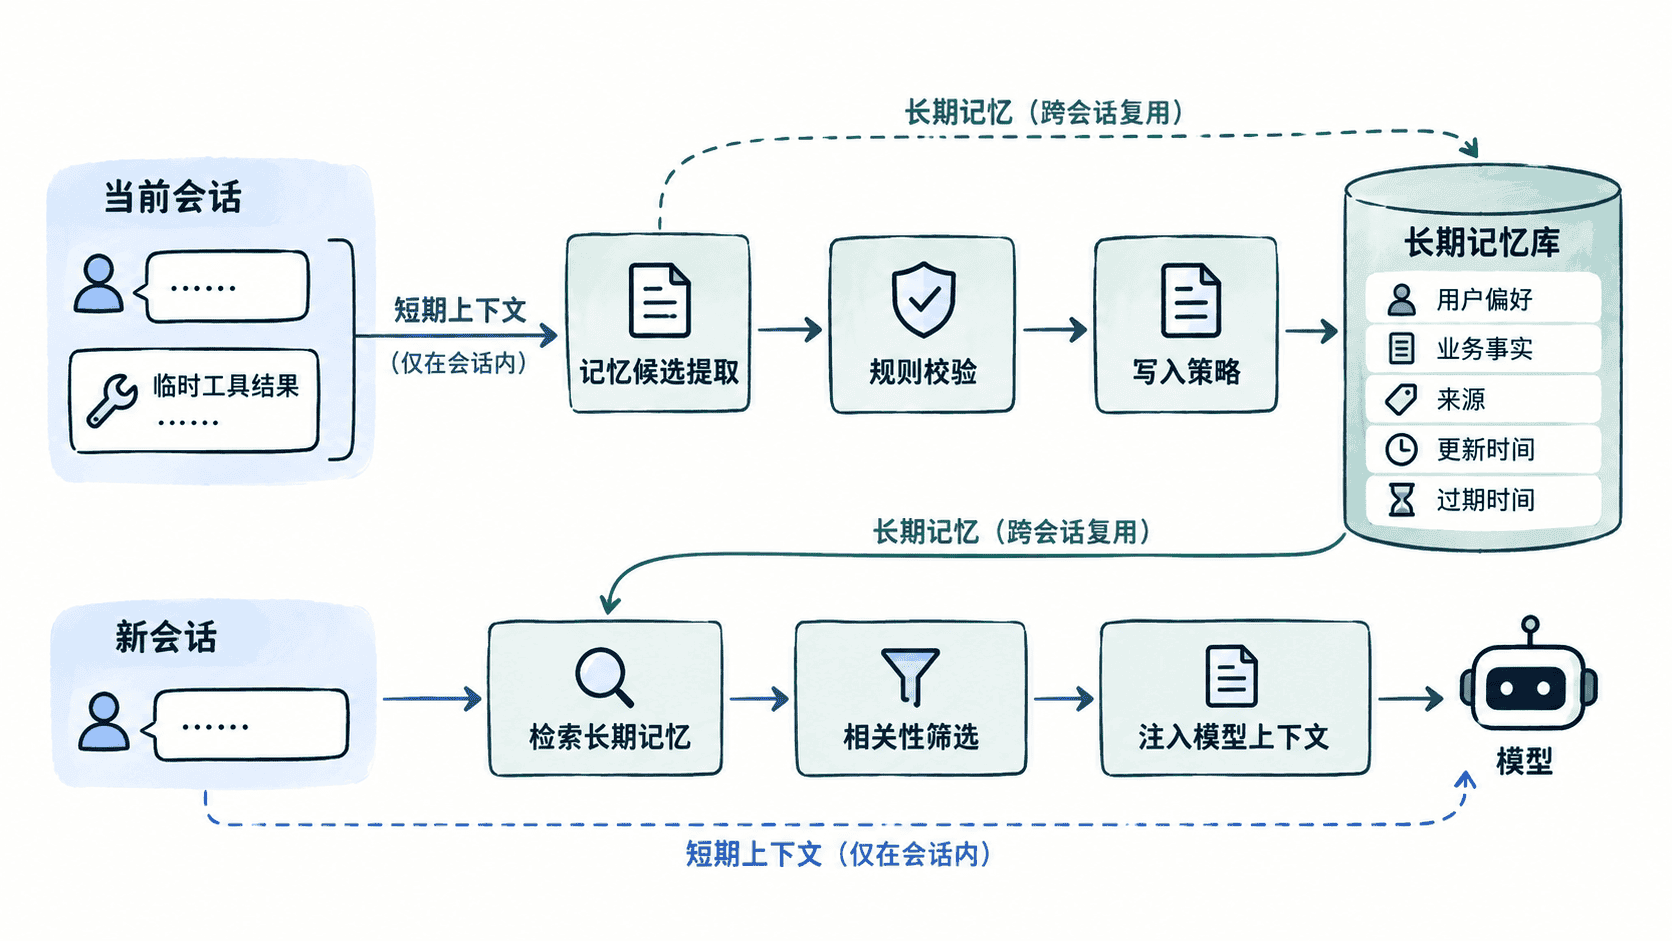
短期上下文服务于“当前这次对话能否连贯继续”,通常包含最近消息、当前任务状态和临时工具结果。它的生命周期可以只覆盖一个会话,内容可以详细,但不应默认跨会话保留。
长期记忆服务于“以后再次遇到同一用户时,哪些稳定信息值得复用”。典型内容包括长期偏好、明确授权保存的资料,以及具有较长有效期的业务事实。它应当比原始聊天更精炼,并具备来源、更新时间和有效期等元数据。
只写入值得长期保留的信息
记忆写入应先生成“候选”,再由规则决定是否落库。一个实用的判断顺序是:信息是否与用户本人相关、未来是否大概率复用、是否足够稳定、是否允许保存。临时情绪、一次性任务参数、未经确认的推断通常不应写入。
可以把记忆记录设计为结构化对象,而不是只有一段自由文本。下面的示例演示偏好类记忆如何经过白名单规则后写入内存存储。
from dataclasses import dataclass
from datetime import datetime, timezone

@dataclass
class Memory:
    user_id: str
    kind: str
    key: str
    value: str
    updated_at: str

ALLOWED_KINDS = {"preference", "business_fact"}
store: list[Memory] = []

def save_memory(user_id: str, kind: str, key: str, value: str) -> bool:
    if kind not in ALLOWED_KINDS or not value.strip():
        return False
    store.append(
        Memory(
            user_id=user_id,
            kind=kind,
            key=key,
            value=value.strip(),
            updated_at=datetime.now(timezone.utc).isoformat(),
        )
    )
    return True

print(save_memory("u-42", "preference", "answer_style", "prefer concise answers"))
print(save_memory("u-42", "temporary", "current_page", "checkout"))
print([(m.kind, m.key, m.value) for m in store])
预期输出:
True
False
[('preference', 'answer_style', 'prefer concise answers')]
时间字段的实际值会随运行时变化,因此示例只验证写入结果。生产系统还应记录来源消息、授权方式和过期时间,便于后续审计与删除。
读取时只注入当前任务需要的记忆
长期记忆不是每轮都全部塞进提示词。读取阶段应先用当前请求做检索,再按用户 ID、记忆类型、相关性和有效期过滤,只把少量真正相关的内容注入模型。这样既减少上下文成本,也能降低旧信息干扰当前判断的概率。
例如,用户询问代码风格时,可以读取 answer_style 或常用语言偏好;用户询问物流状态时,则不应把无关的写作偏好、旧项目背景全部注入。记忆召回的目标是“足够相关”,不是“越多越好”。
设计更新、冲突与删除规则
用户偏好会变化,业务事实也会过期。对于唯一性较强的键,例如默认语言、通知方式,可以采用“同键覆盖并保留更新时间”;对于历史事实,可以保留多版本,但读取时只选择仍然有效且来源可信的记录。
当新信息与旧记忆冲突时,不要仅凭模型猜测谁更准确。优先使用用户明确更正、可信业务系统的最新状态或人工确认结果,并记录覆盖原因。对于带有效期的事实,到期后应停止召回,而不是继续影响回答。
用户还应能查看、修改和删除长期记忆。真正可控的记忆系统,关键不是“记得更多”,而是每条记忆都能说明为什么被保存、何时使用,以及何时应该失效。