
大模型应用开发 / 系统课时
隔离系统指令
隔离系统指令
系统指令只有在应用架构中被真正当作可信控制信息时才有意义。把它与用户输入、检索文档和工具结果混成一段文本,会让模型难以区分命令与数据。本节从上下文分层、数据封装和工具权限三个层面建立可落地的隔离边界。
学习目标
- 按可信程度分离系统指令、用户请求和外部数据
- 避免仅依赖分隔符或自然语言声明保护系统规则
- 用工具权限与服务端校验限制不可信内容造成的实际影响
建立可信层级
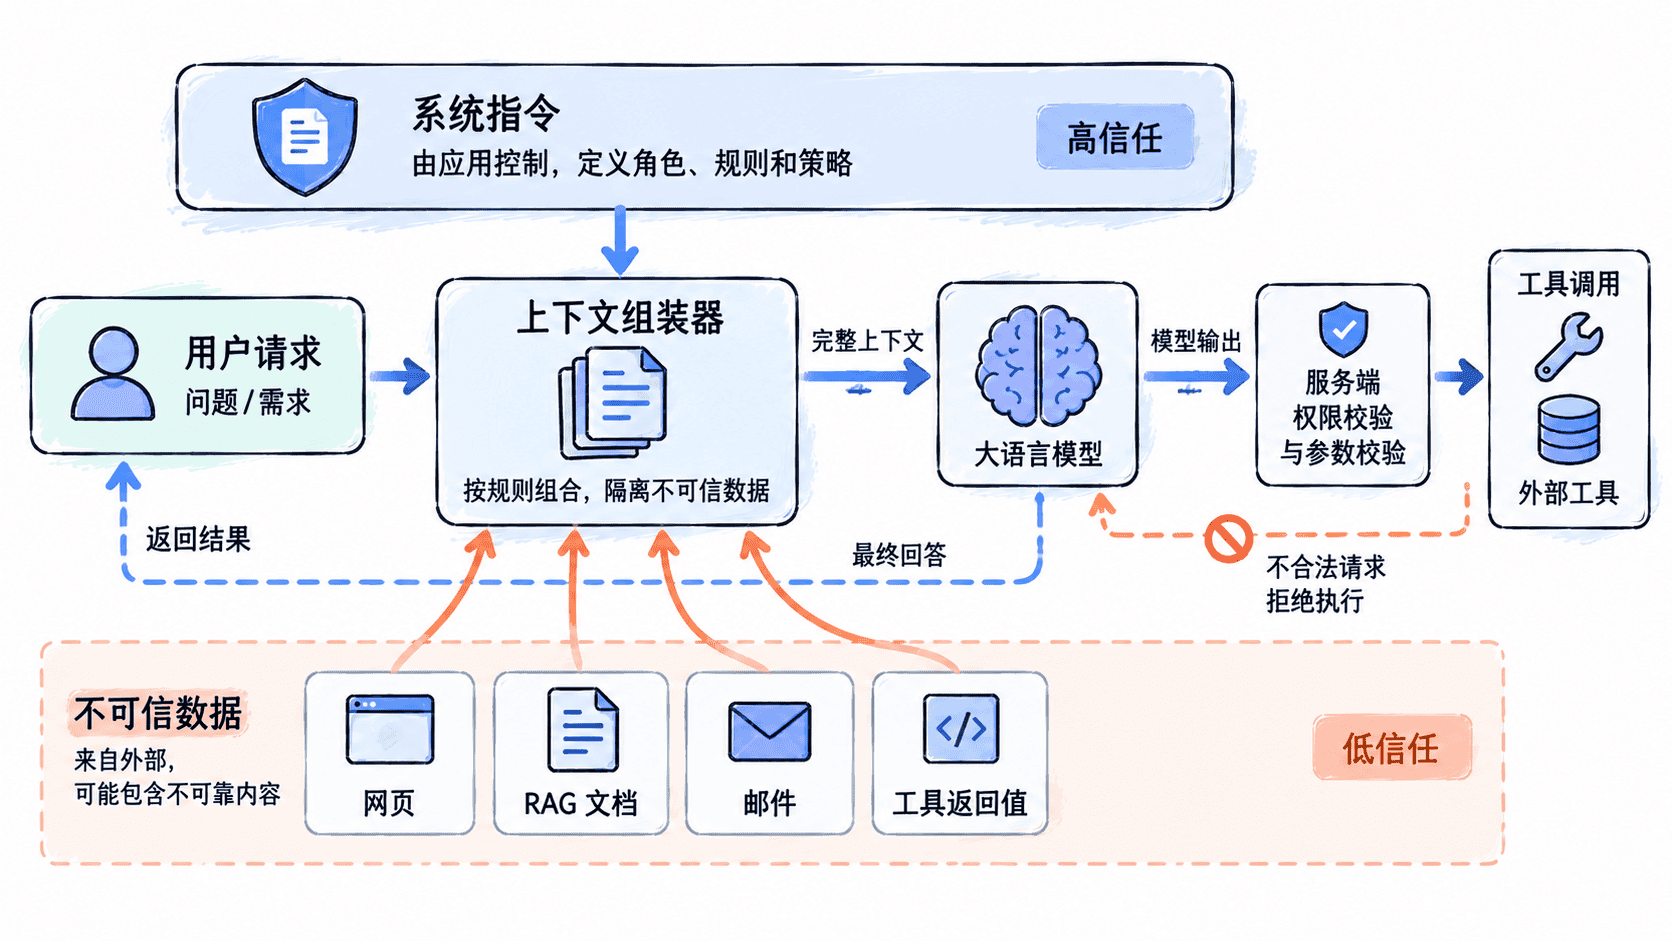
系统指令应由应用开发者控制,用来定义模型职责、安全规则和输出约束;用户消息用于表达当前任务;网页、知识库、邮件和工具返回值则属于待处理数据。它们可以影响回答内容,但不应获得修改系统规则的权限。
因此,上下文组装时不要把所有内容拼成一个巨大的用户字符串。模型 API 支持不同消息角色时,应利用原生角色保存系统指令和用户请求;外部内容则放进明确的数据字段或独立上下文区域,并在系统规则中声明其不具备控制权限。
分隔数据但不要迷信分隔符
使用清晰的数据边界仍然有价值。例如在提交检索结果时,可以标明哪些字段属于文档标题、正文和来源,使模型更容易理解“下面是待分析的数据”。但诸如三引号、XML 风格标签或“以下内容不可信”这样的自然语言分隔,本身并不是安全边界。
攻击文本完全可以出现在分隔区域内部,并继续要求模型忽略上级规则。因此分隔符的作用是提高语义清晰度,而真正的隔离还需要应用侧控制消息角色、数据来源和可执行能力。
把关键约束放在模型之外
任何必须百分之百执行的规则,都不应只写在系统提示词里。例如“只能查询当前用户自己的订单”“转账金额不得超过授权额度”“删除操作必须再次确认”,这些都应该由服务端代码依据身份、权限和参数重新校验。
模型可以负责理解意图并提出工具调用建议,但实际执行层必须独立决定该调用是否允许。即使外部文档成功诱导模型生成了错误的工具参数,权限检查仍应阻止越权行为。这样才能把一次提示词注入从真实安全事件降级为一次无效模型输出。
对于高风险工具,还可以减少模型可见的能力:只暴露当前任务必要的工具,限制文件目录、数据库范围、网络目标和可写字段,并对删除、付款、发送消息等副作用操作增加人工确认或确定性的审批规则。
控制外部内容进入上下文
隔离并不意味着把外部数据全部丢弃,而是让应用知道数据来自哪里,并限制它能产生什么影响。RAG 检索结果应保留来源元数据;网页抓取内容可以先经过正文提取和风险检测;工具返回值只暴露完成当前任务需要的字段,避免把内部凭据、调试信息或无关敏感数据直接传给模型。
当多个来源同时进入上下文时,应用还应防止来源之间发生权限继承。例如一份普通知识库文档不能因为与管理员消息同时出现,就获得管理员级工具权限。权限应绑定到真实用户身份和服务端策略,而不是绑定到某段文本声称的身份。
验证隔离是否真正生效
安全测试时,应分别向用户输入和外部文档注入互相冲突的行为要求,观察模型是否仍遵循系统目标;随后再检查高权限工具是否能被这些内容直接触发。只有“模型不听从恶意文本”和“执行层拒绝越权动作”两层都成立,隔离才算有效。
还应覆盖系统指令泄露、跨用户数据访问、恶意检索文档和工具参数篡改等场景。发现模型偶尔被诱导生成错误文本并不可怕,真正危险的是错误文本能够未经校验地转化为数据库修改、外部请求或敏感信息泄露。
可靠的隔离方案不是寻找一种更复杂的提示词写法,而是把信任边界落实到应用结构中:系统规则由可信代码控制,外部内容始终作为数据处理,真正产生副作用的动作再由服务端独立授权。