
大模型应用开发 / 系统课时
实现会话服务
实现会话服务
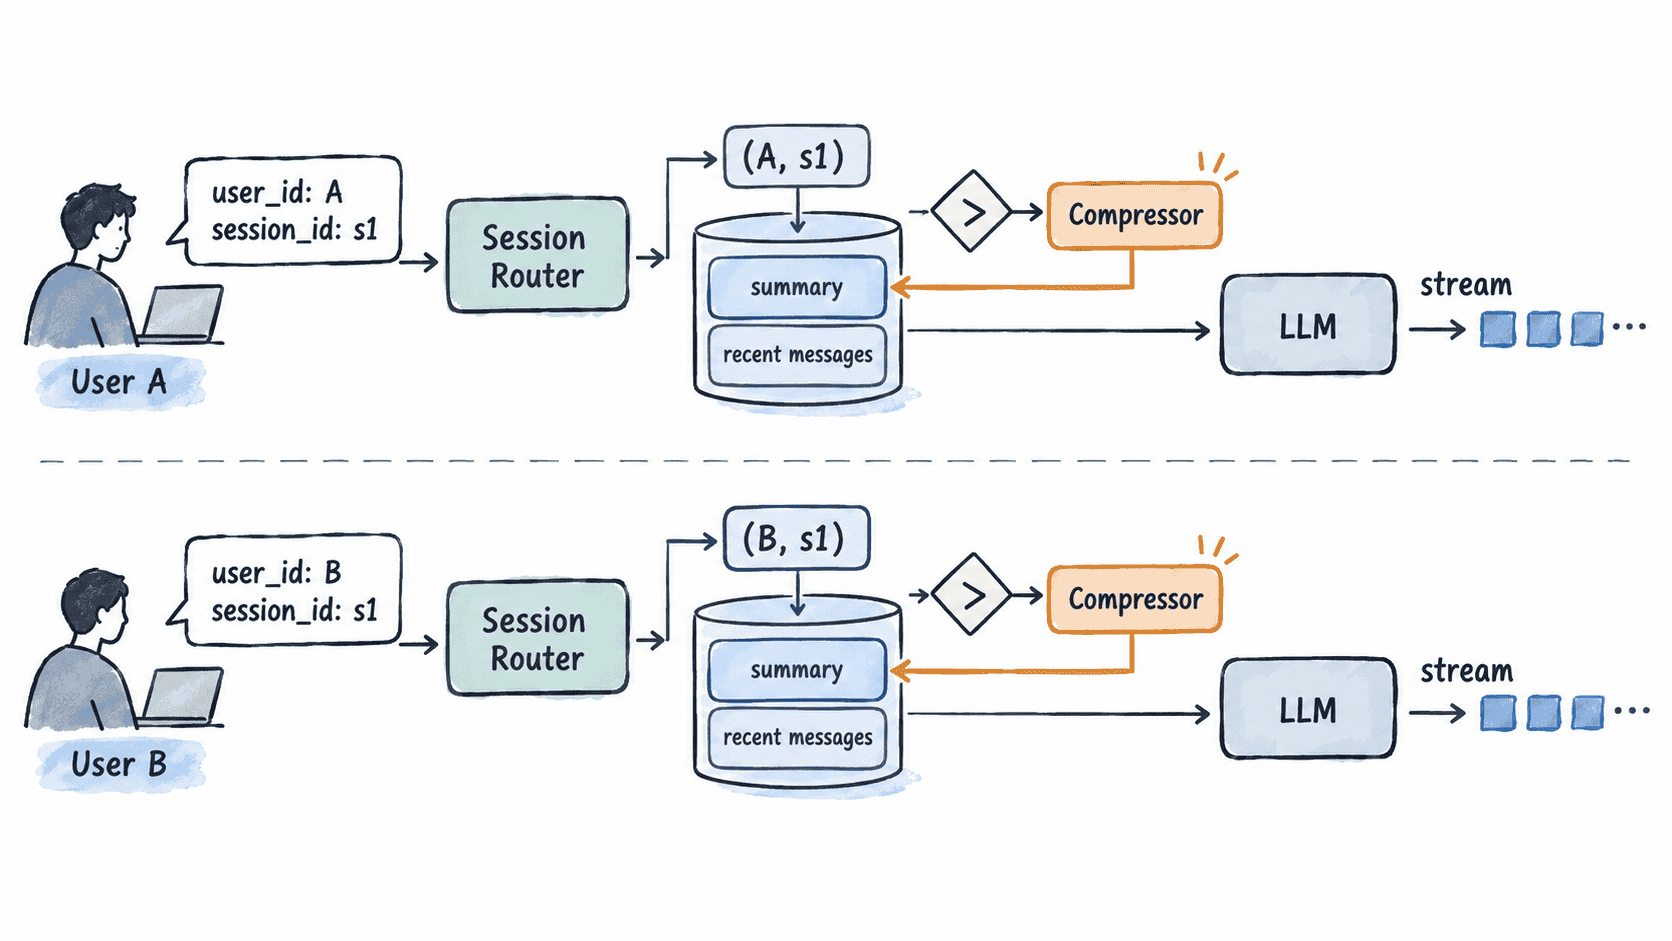
会话服务要同时解决四件事:持续流式返回、保存可追溯历史、在上下文过长时压缩旧消息,并确保不同用户即使使用相同会话编号也绝不串线。本节用一个可运行的 Python 服务核心把这四个边界放到同一条请求链路中。
学习目标
- 用
user_id + session_id复合键隔离多用户会话状态。 - 用异步生成器实现流式响应,并在回复前后维护历史消息。
- 在上下文超过预算时压缩旧消息,同时保留最近对话用于连续交互。
把隔离边界放在会话键上
只用 session_id 做键存在天然串话风险:用户 A 和用户 B 都可能拥有 s1。因此历史、摘要、锁和缓存都应绑定复合键 (user_id, session_id)。请求进入后先确定复合键,再读取该键对应的摘要和最近消息,最后把新回复写回同一空间。
实现流式写入与上下文压缩
下面的示例不依赖外部模型,chat() 用异步生成器模拟模型分块输出,便于直接运行验证会话层逻辑。生产环境只需要把构造 answer 的部分替换成真实模型的流式调用,并把 summary + recent messages 作为模型上下文。
import asyncio
from collections import defaultdict
from dataclasses import dataclass

@dataclass
class Message:
    role: str
    content: str

class SessionService:
    def __init__(self, max_chars: int = 30):
        self.histories = defaultdict(list)
        self.summaries = {}
        self.max_chars = max_chars

    async def chat(self, user_id: str, session_id: str, text: str):
        key = (user_id, session_id)
        self.histories[key].append(Message("user", text))
        self._compress(key)

        # 真实项目在这里把 summary 与 recent messages 传给模型。
        context_count = len(self.histories[key]) + (1 if key in self.summaries else 0)
        answer = f"收到:{text};上下文条目={context_count}"
        for index in range(0, len(answer), 6):
            await asyncio.sleep(0)
            yield answer[index:index + 6]

        self.histories[key].append(Message("assistant", answer))
        self._compress(key)

    def _compress(self, key):
        history = self.histories[key]
        total_chars = sum(len(message.content) for message in history)
        if total_chars <= self.max_chars or len(history) <= 2:
            return

        # 保留最近两条,把更旧内容折叠到摘要;生产环境应按 token 预算压缩。
        old, recent = history[:-2], history[-2:]
        digest = " | ".join(f"{message.role}:{message.content}" for message in old)
        previous = self.summaries.get(key, "")
        self.summaries[key] = (previous + " | " + digest).strip(" |")[-80:]
        self.histories[key] = recent

    def inspect(self, user_id: str, session_id: str):
        key = (user_id, session_id)
        return self.summaries.get(key), self.histories[key]

async def ask(service, user_id, session_id, text):
    chunks = []
    async for chunk in service.chat(user_id, session_id, text):
        chunks.append(chunk)
    print(f"{user_id}> {''.join(chunks)}")

async def main():
    service = SessionService(max_chars=30)
    await ask(service, "alice", "s1", "记住项目代号是 Orion")
    await ask(service, "alice", "s1", "当前代号是什么?")
    await ask(service, "bob", "s1", "我的项目代号是 Vega")

    alice_summary, alice_messages = service.inspect("alice", "s1")
    bob_summary, _ = service.inspect("bob", "s1")
    print("alice_has_summary:", bool(alice_summary))
    print("alice_recent_messages:", len(alice_messages))
    print("bob_has_summary:", bool(bob_summary))

asyncio.run(main())
预期输出
alice> 收到:记住项目代号是 Orion;上下文条目=1
alice> 收到:当前代号是什么?;上下文条目=3
bob> 收到:我的项目代号是 Vega;上下文条目=1
alice_has_summary: True
alice_recent_messages: 2
bob_has_summary: False
输出说明了两个关键事实:Alice 的旧消息已经被压入摘要,而 Bob 使用同一个 s1 仍拥有独立历史。实际模型的分块大小、生成文本和 token 数会不同,但隔离键与历史更新顺序不应改变。
处理并发与持久化边界
单进程字典只适合演示。真实服务应把消息和摘要放到数据库或分布式缓存,并为同一复合键建立串行化机制,否则两个并发请求可能同时读取旧历史,随后互相覆盖。常见做法是每个会话使用互斥锁、带版本号的乐观写入,或由单一会话消费者顺序处理。
上下文压缩也不能只看消息条数。生产环境应按模型 token 上限预留系统提示、工具定义和本轮输出空间,再决定摘要预算与最近消息窗口;摘要本身还要限制长度,避免每次压缩后继续无界增长。
验收会话服务
验收时至少覆盖四类场景:同一用户连续多轮能读取自己的上下文;不同用户使用相同 session_id 不串话;超过预算后旧内容进入摘要且最近消息仍保留;客户端中止流式连接后不会留下伪造的完整回复。通过这些检查后,会话层才具备接入真实模型、鉴权和持久化存储的稳定边界。