
大模型应用开发 / 系统课时
建立回归测试
建立回归测试
大模型应用最危险的退化往往来自“修好一个案例,却弄坏另一类案例”。本课把历史失败样本沉淀成自动化回归测试,并在发布前用质量门槛阻止明显退化进入生产环境。
学习目标
- 把线上失败案例转换成可重复执行的测试样本
- 为不同任务定义稳定、可自动判断的断言
- 在发布流程中设置回归门槛,并定位具体退化样本
把失败案例变成测试资产
一个回归样本至少应包含输入、期望行为和判定规则。不要只保存“用户说模型答错了”这种描述,而要把失败压缩成最小可复现案例,并去掉账号、隐私数据和与问题无关的上下文。
对确定性任务,断言可以直接检查标签、字段或格式;对开放式生成,优先检查必须满足的事实、禁止出现的内容和结构约束。只有规则确实覆盖不了时,再引入人工评分或模型裁判。
下面是片段示例,只定义测试数据,依赖后续测试执行器读取这些字段。
cases = [
    {
        'id': 'case-001',
        'input': '用户要求退款,订单已超过退款期',
        'expected_label': 'manual_review',
    },
    {
        'id': 'case-002',
        'input': '用户询问如何修改收货地址',
        'expected_label': 'address_change',
    },
]
真实项目中可以把样本保存为 JSONL,并在代码评审中同时审查新增失败案例和对应断言。
让测试先稳定再自动化
回归测试不能依赖“每次输出必须逐字相同”,否则提示词稍微改写措辞就会大量误报。更稳妥的做法是判断业务契约,例如分类标签必须正确、结构化 JSON 必须包含必填字段、禁止输出的敏感内容不能出现。
下面的完整示例模拟一个版本的分类结果,并在发现退化时返回非零退出码,便于接入 CI。
import sys

cases = [
    {'id': 'case-001', 'expected': 'manual_review'},
    {'id': 'case-002', 'expected': 'address_change'},
    {'id': 'case-003', 'expected': 'cancel_order'},
]

actual = {
    'case-001': 'manual_review',
    'case-002': 'address_change',
    'case-003': 'manual_review',
}

failed = []

for case in cases:
    got = actual.get(case['id'])
    if got != case['expected']:
        failed.append((case['id'], case['expected'], got))

passed = len(cases) - len(failed)
rate = passed / len(cases)

print(f'passed={passed}/{len(cases)} rate={rate:.2%}')

for case_id, expected, got in failed:
    print(f'FAIL {case_id}: expected={expected}, got={got}')

# 发布门槛:本示例要求所有关键回归样本通过。
if failed:
    sys.exit(1)
预期输出
passed=2/3 rate=66.67%
FAIL case-003: expected=cancel_order, got=manual_review
进程最终以退出码 1 结束,因此 CI 可以直接把这次版本标记为失败。真实项目还应同时输出模型、提示词版本、运行时间和失败样本 ID,便于定位是哪次改动引入了退化。
把回归测试接到发布门禁
回归流程包含样本集、候选版本、测试执行、质量门槛和失败报告五个对象,顺序关系比单纯文字更适合用流程图表达。
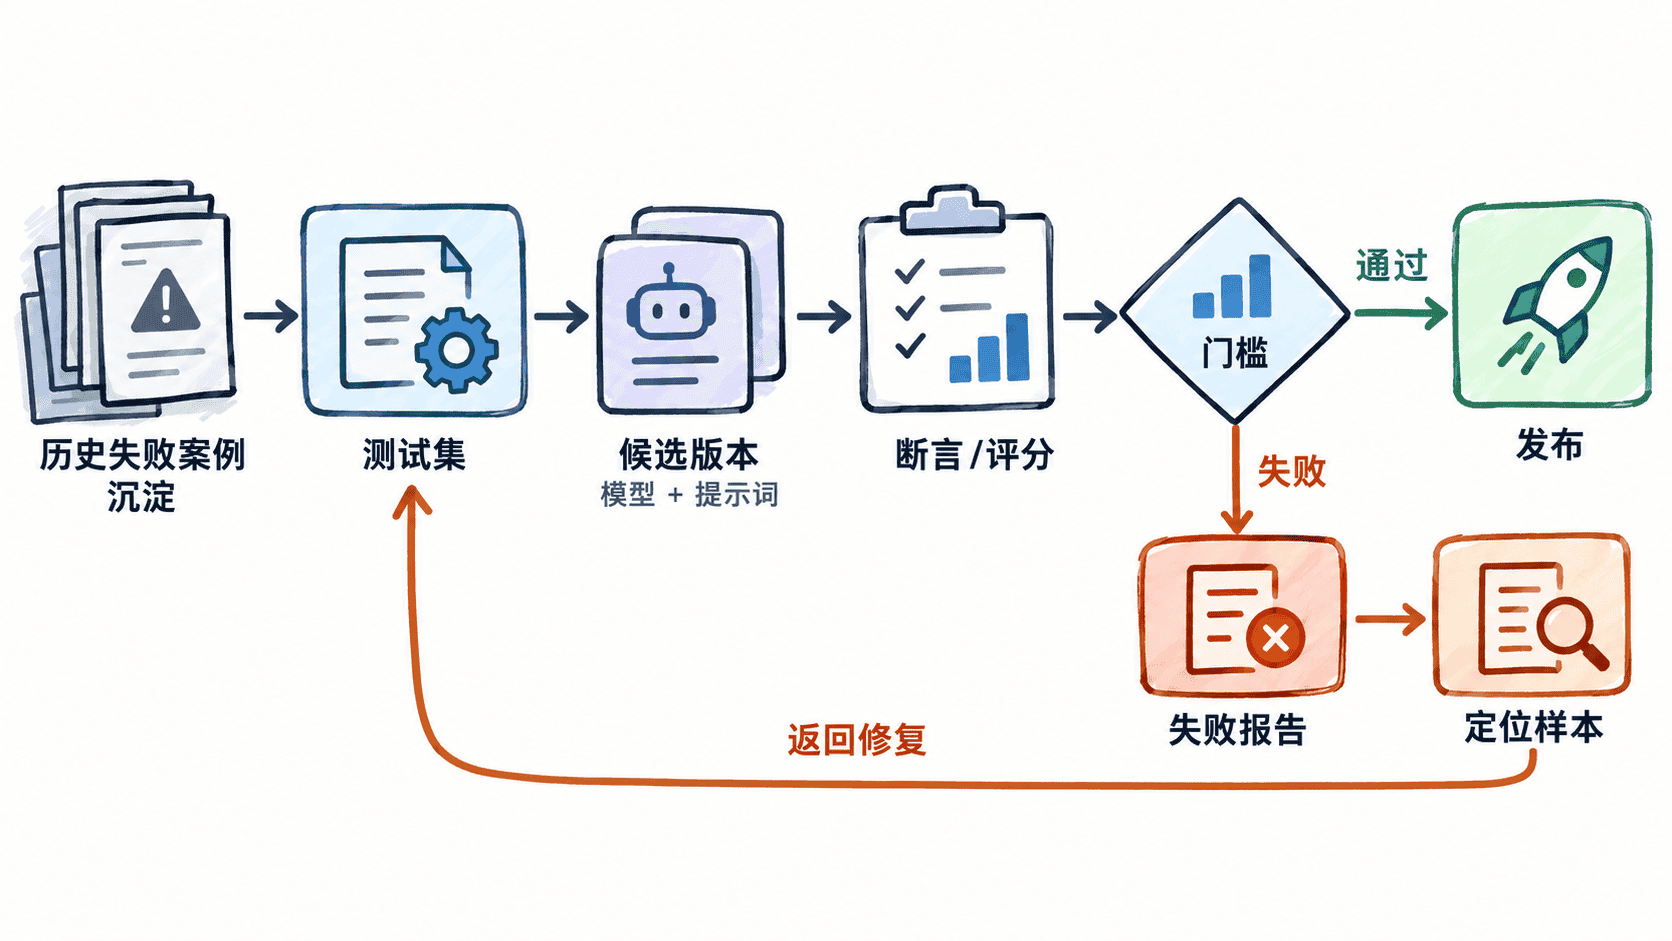
门槛不一定要求所有指标都“比上一版高”。更常见的是设置不可突破的底线,例如关键安全样本必须 100% 通过、核心准确率不得下降超过 1 个百分点、P95 延迟不得超过既定上限。门槛应提前定义,避免看到结果后再调整标准。
管理不断增长的回归集
回归集会持续变大,但不是越大越好。重复样本会拖慢发布,又不会提供新的风险覆盖。可以定期合并同类案例,同时保留高风险边界、曾经真实发生过的事故样本和最容易被改动影响的代表样本。
当某个失败案例修复后,不要删除它;只要它仍代表真实业务约束,就应该长期留在测试集。这样每次模型、提示词、检索策略或工具调用逻辑变化时,都能自动回答一个关键问题:旧问题有没有重新出现。