
大模型应用开发 / 系统课时
回传工具结果
回传工具结果
工具执行完成后,应用还不能直接把结果拼进普通用户文本。模型需要收到与原工具请求一一对应的工具结果消息,才能把外部数据纳入后续生成。本节完成调用 ID 关联、结果序列化和消息顺序组织,形成完整的工具调用闭环。
学习目标
- 使用原始调用 ID 将工具结果绑定到正确的工具请求
- 将工具执行结果序列化为模型可接收的工具结果消息
- 按正确消息顺序继续请求模型,并正确表达工具失败
回传依赖调用 ID
一次工具调用至少跨过两个模型回合:模型先发出工具请求,应用执行工具,再把结果回给模型。最容易出错的是只传“工具名称 + 结果”,却丢掉原始调用 ID;当一次响应里有多个工具请求时,模型就无法可靠判断哪份结果属于哪次调用。
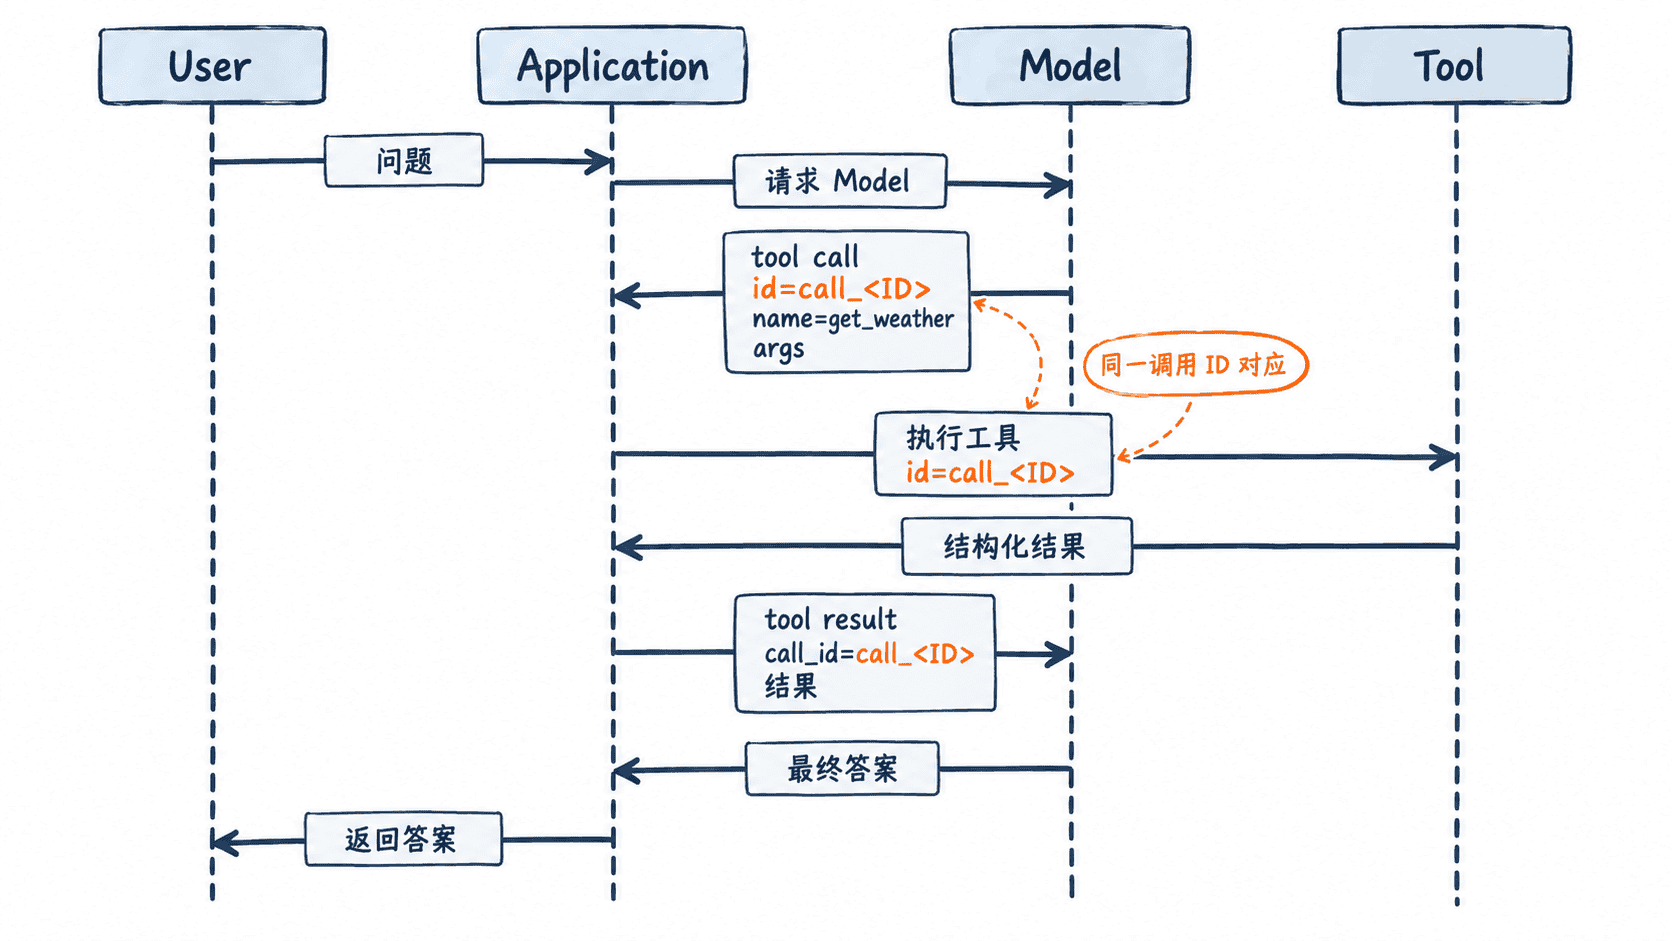
因此,应用需要保存模型产生的工具请求,以及后续生成的工具结果消息。第二次请求模型时,两部分都应按协议要求放回上下文,不能只保留最终工具输出。
组织工具结果消息
下面使用 TypeScript 构造一个供应商无关的消息数组。工具执行返回对象后,先序列化为字符串,再用 tool_call_id 绑定原请求。
type Message =
  | { role: "user"; content: string }
  | {
      role: "assistant";
      content: string;
      tool_calls: Array<{
        id: string;
        name: string;
        arguments: Record<string, unknown>;
      }>;
    }
  | { role: "tool"; tool_call_id: string; content: string };

const toolCallId = "call_<ID>";

const messages: Message[] = [
  {
    role: "user",
    content: "上海今天多少度?"
  },
  {
    role: "assistant",
    content: "",
    tool_calls: [
      {
        id: toolCallId,
        name: "get_weather",
        arguments: { city: "Shanghai" }
      }
    ]
  }
];

const toolResult = {
  city: "Shanghai",
  temperatureC: 28
};

messages.push({
  role: "tool",
  tool_call_id: toolCallId,
  content: JSON.stringify(toolResult)
});

console.log(JSON.stringify(messages[messages.length - 1], null, 2));
预期输出:
{
  "role": "tool",
  "tool_call_id": "call_<ID>",
  "content": "{\"city\":\"Shanghai\",\"temperatureC\":28}"
}
<ID> 表示实际调用过程中生成的动态标识。不同模型接口的字段名可能不同,但核心原则不变:结果消息必须引用原工具请求的唯一 ID,并使用接口规定的工具结果消息类型,而不是伪装成 user 或普通 assistant 消息。
保持消息顺序完整
第二次模型请求通常应包含用户问题、模型产生的工具请求以及对应的工具结果,然后才由模型继续生成答案。如果省略中间的 assistant 工具请求消息,严格校验消息结构的接口可能直接拒绝请求,模型也可能失去工具调用上下文。
一次出现多个工具请求时,每个结果都要分别回传,并与自己的调用 ID 对应。工具彼此独立时可以并行执行,但并行只改变执行方式,不能打乱“哪个调用 ID 对应哪个结果”的关系。
工具失败也要结构化回传
工具超时、参数被下游拒绝或外部服务返回错误时,不应伪造成功结果。应用可以把允许模型看到的失败信息序列化为工具结果,让模型据此解释失败、改用其他工具或询问用户补充信息。
实践中可以让工具统一返回 { "ok": true, "data": ... } 或 { "ok": false, "error": ... } 这一类包装结构。这样应用和模型都能区分“工具执行失败”与“工具执行成功但业务上没有数据”。
当模型收到正确类型、正确顺序且带原调用 ID 的工具结果后,工具调用闭环才真正完成。最终自然语言答案应由模型基于这次工具结果继续生成,而不是由应用把未经解释的工具输出直接冒充成模型结论。