
大模型应用开发 / 系统课时
过滤敏感信息
过滤敏感信息
大模型应用里的敏感数据不只来自用户输入,还可能进入日志、向量知识库和模型输出。本节建立一条端到端的数据保护链路,并用可运行的脱敏程序验证:敏感值应尽量在进入持久化系统或第三方模型之前被识别、删除或替换。
学习目标
- 判断输入、日志、知识库和输出阶段分别可能泄露什么数据
- 实现基础的敏感信息识别与掩码处理
- 根据数据用途选择删除、替换、加密或禁止存储
先确定敏感数据经过哪些环节
一次普通的模型请求可能复制同一份数据多次:原始输入进入业务服务,服务记录日志,文本被写入知识库或会话记忆,随后模型又可能把其中的信息重新生成到输出中。因此,不能只在聊天框入口做一次过滤。
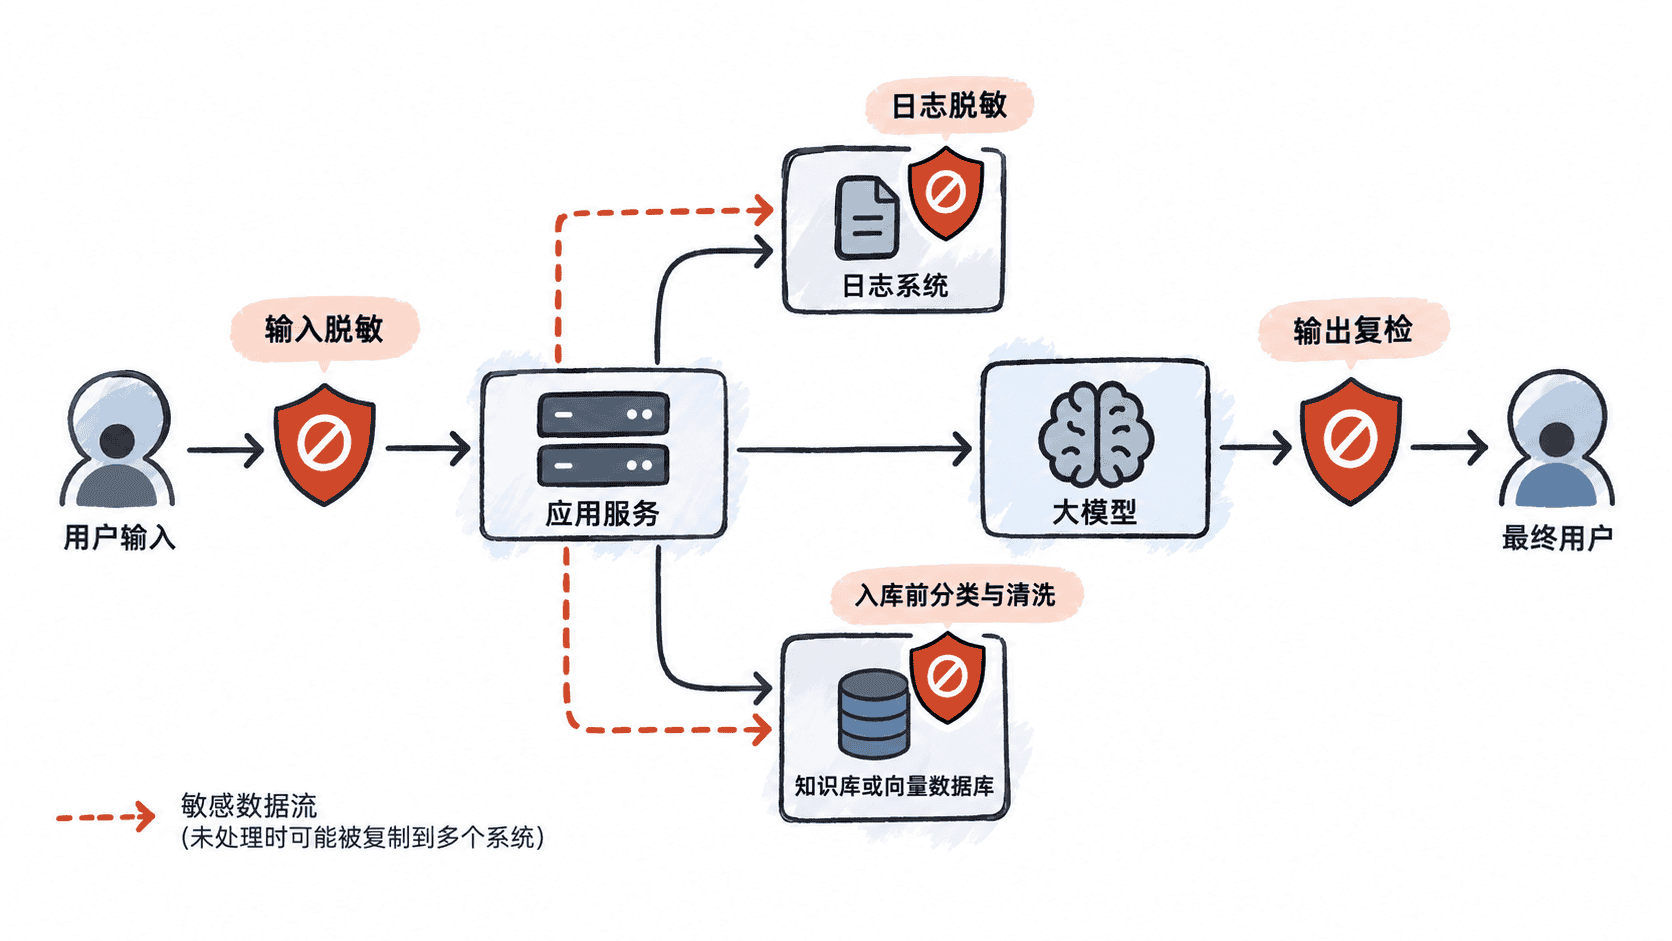
入口过滤的目标是减少敏感数据继续传播;日志过滤要避免监控和错误追踪系统成为新的泄露面;知识库过滤要决定哪些字段根本不应被索引;输出过滤则用于阻止模型复述先前接触过的敏感值。
用最小程序完成识别与脱敏
下面的示例识别电子邮箱、手机号和订单号,并把原值替换成稳定标签。示例适合演示处理顺序,生产环境还应结合结构化字段、数据分类规则和专用 DLP 能力,不能只依赖正则表达式。
import re

PATTERNS = [
    ("EMAIL", re.compile(r"\b[A-Za-z0-9._%+-]+@[A-Za-z0-9.-]+\.[A-Za-z]{2,}\b")),
    ("PHONE", re.compile(r"\b1[3-9]\d{9}\b")),
    ("ORDER_ID", re.compile(r"\bORD-\d{6}\b")),
]


def redact_sensitive(text: str) -> str:
    result = text
    # 先识别再替换,避免原值继续进入日志、知识库或模型上下文。
    for label, pattern in PATTERNS:
        result = pattern.sub(f"<{label}>", result)
    return result


def main() -> None:
    message = "客户 13800138000,邮箱 alice@example.com,订单 ORD-123456。"
    safe_text = redact_sensitive(message)
    print(safe_text)


if __name__ == "__main__":
    main()
预期输出
客户 <PHONE>,邮箱 <EMAIL>,订单 <ORDER_ID>。实际系统中的编号、字段形式和国家地区规则可能不同,因此识别规则必须根据真实数据模型维护。对于姓名、地址、身份证件、密钥、访问令牌等更复杂的数据,还需要使用结构化字段校验、实体识别或专门的敏感数据检测服务。
不同位置采用不同处理策略
输入阶段应优先执行最小化原则:任务根本不需要的字段直接删除;确实需要模型理解但不需要知道原值的字段使用占位符替换。若业务之后还要恢复原值,应把映射关系保存在受控系统中,而不是放进模型上下文。
日志应默认记录事件类型、请求 ID、耗时和错误码,而不是完整 Prompt 与响应。确需记录内容排障时,也应先脱敏,并限制保存期限和访问权限。尤其不要把 API Key、Cookie、Authorization 头或数据库连接凭据写入日志。
知识库的风险更持久。文本一旦完成切分、向量化和备份,后续删除通常比入口阻断困难。因此应在索引前完成数据分类,并明确哪些文档允许进入检索系统。权限敏感的知识还需要在检索阶段继续执行访问控制,脱敏不能代替授权。
输出仍然需要再次检查
即使入口已经过滤,模型仍可能从历史会话、检索结果、工具返回值或系统提示中获得敏感内容,所以响应发送给用户之前要再次执行检测。对于可确定的敏感字段可以自动掩码;对于无法确定是否允许披露的内容,更安全的动作是阻断响应或转人工审核。
一个可靠的敏感信息治理方案应遵循同一原则:越早减少不必要的数据传播,后续需要保护的副本就越少;任何会持久保存数据的环节,都必须在写入前重新确认数据是否真的应该存在于那里。