
大模型应用开发 / 系统课时
排查回答不准确
排查回答不准确
回答不准确不能只归因于“模型不够好”。有效排查要沿着提示词、模型能力、检索召回、上下文质量和数据时效逐层取证,先确认错误在哪一层产生,再针对根因修改,避免靠反复改提示词碰运气。
学习目标
- 将“回答不准确”拆成可以验证的故障现象
- 按提示词、模型、检索、上下文和时效顺序定位根因
- 用固定测试集验证修复是否真的提高准确性
先把错误变成可检查的证据
排查前先保存一次失败请求的完整现场:用户问题、最终提示词、模型版本、检索结果、送入模型的上下文、最终回答以及数据更新时间。只保留最终回答,会失去判断错误产生位置所需的大部分证据。
常见现象可以先分成四类:事实写错、已有证据却没有采用、检索不到正确证据、回答使用了过期事实。分类的价值在于缩短路径,例如正确文档根本没有进入检索结果时,应先查召回而不是修改生成参数。
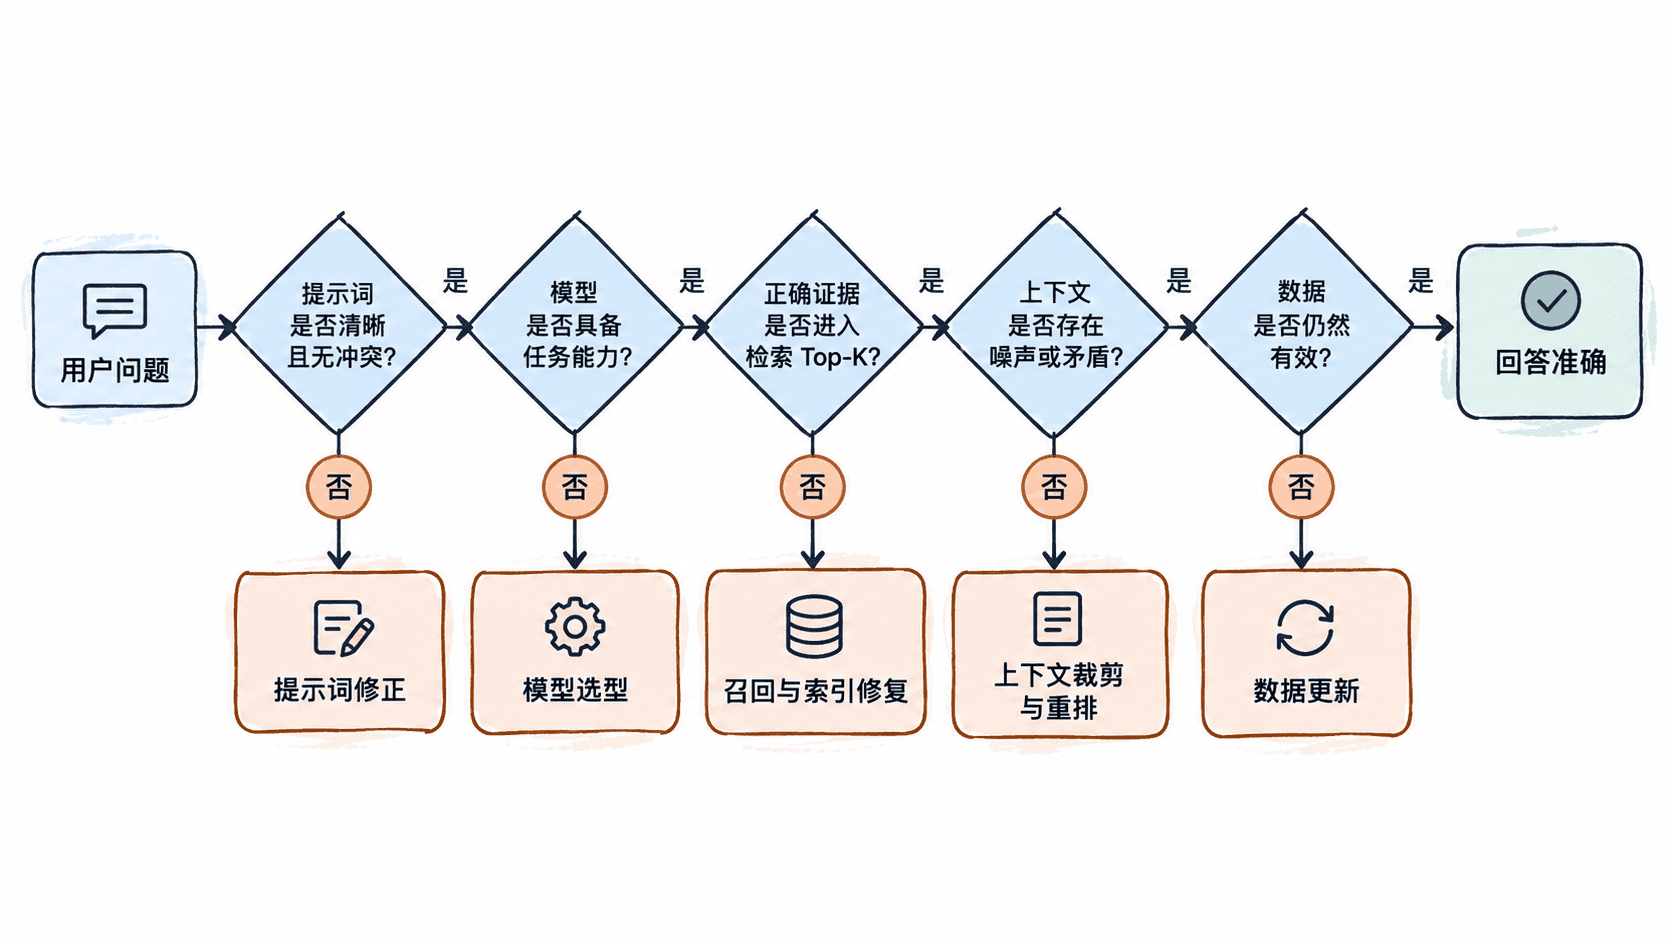
沿证据链逐层定位
提示词层先检查任务边界是否明确,以及系统指令、业务模板和用户输入之间是否互相冲突。保持模型和检索结果不变,将提示词缩减为最小版本做对照;如果错误随提示词变化而消失,根因通常在指令表达或约束冲突。
模型能力层关注“给足正确证据后能不能答对”。可以把目标事实直接放入短上下文,再运行同一问题。如果模型仍无法稳定完成推理、结构化输出或专业判断,再考虑更合适的模型,而不是继续调整检索。
检索层要直接查看正确证据是否进入 Top-K。如果没有,应检查查询改写、分块粒度、向量或关键词召回、元数据过滤和索引更新。证据已经召回但答案仍错,则继续检查上下文,而不是把问题错误归因于召回率。
上下文层重点寻找重复片段、互相矛盾的版本、无关文档和过长上下文。将正确证据前置,并通过去重、重排或缩减 Top-K 做对照,可以验证模型是否因为信息竞争而忽略关键事实。
数据时效层最后核对来源更新时间和索引更新时间。模型依据旧文档正确回答,对当前业务仍可能是错误答案;这类问题必须修复数据更新链路或明确时间边界,单纯修改提示词无法消除旧事实。
用最小脚本确定优先排查层
下面的可运行示例把一次失败请求的检查结果编码为布尔信号,并输出第一个未通过的环节。实际系统中可以把这些值替换为评测程序或请求日志得到的结果。
case = {
    "prompt_clear": True,
    "model_can_answer": True,
    "evidence_retrieved": False,
    "context_clean": True,
    "data_fresh": True,
}

checks = [
    ("提示词", case["prompt_clear"]),
    ("模型能力", case["model_can_answer"]),
    ("检索召回", case["evidence_retrieved"]),
    ("上下文质量", case["context_clean"]),
    ("数据时效", case["data_fresh"]),
]

for name, passed in checks:
    print(f"{name}: {'通过' if passed else '失败'}")

first_failed = next((name for name, passed in checks if not passed), "未发现")
print(f"优先根因: {first_failed}")
预期输出
提示词: 通过
模型能力: 通过
检索召回: 失败
上下文质量: 通过
数据时效: 通过
优先根因: 检索召回
这里应先查看缺失证据为什么没有被召回。只有把正确文档稳定送入上下文后,才有意义继续评价模型是否正确使用证据。
修复后用固定问题集回归
修复不能只重试刚才那一个问题。准备一组包含正确答案、关键证据和数据版本的固定问题,在修改前后使用相同模型、相同数据和相同生成配置重放,并分别记录答案正确率、关键证据召回率以及引用是否命中正确来源。
如果正确证据能够稳定进入上下文、上下文不存在冲突、数据版本符合问题时间范围,同时模型在固定测试集上的错误明显下降,才可以认为根因已经被处理,而不是偶然得到了一次正确回答。