
大模型应用开发 / 系统课时
开展人工评审
开展人工评审
人工评审适合处理模型评测难以覆盖的业务判断,例如语气是否得体、方案是否可执行、内容是否符合领域规则。完成本节后,你可以设计一套可复核的评分表与抽样流程,把主观判断变成相对稳定的数据。
学习目标
- 判断哪些质量问题必须由人工评审承担
- 设计带评分锚点、问题标签和备注字段的评审表
- 通过分层抽样、盲评和复核降低评审者差异
先定义需要人判断的问题
不要把“请整体打分”当成人工评审任务。先明确人工要判断的对象,例如客服回复是否真正解决用户诉求、营销文案是否符合品牌口吻、代码解释是否对初学者可执行。能通过单元测试、规则校验或事实比对自动判断的部分,应尽量交给自动评测,避免浪费人工成本。
一个样本只保留必要上下文。上下文太少会让评审者无法判断,太多又会让不同评审者关注不同信息。最实用的做法是固定输入字段:任务、必要参考、候选输出、评分标准,并隐藏模型名称和版本。
设计可落地的评分表
评分维度应少而清楚,每个维度给出具体锚点。下面的示例适用于大多数生成式应用,可按业务删减:
| 维度 | 低分锚点 | 高分锚点 |
|---|---|---|
| 任务完成度 | 漏掉核心要求,用户仍需补做 | 核心要求全部完成,可直接使用 |
| 业务正确性 | 违反领域规则或给出错误操作 | 与业务规则一致,无关键错误 |
| 约束遵循 | 明显违反格式、语气或范围要求 | 完整遵守显式约束 |
| 表达质量 | 难读、冗余或结构混乱 | 清晰、直接,信息密度合适 |
每个维度建议采用固定等级,例如 1~5 分,并允许填写“无法判断”。同时增加问题标签,如“事实错误”“遗漏约束”“语气问题”“拒答不当”,因为标签比一个总分更适合指导后续改进。
组织抽样与盲评流程
人工评审不要只抽“随机用户请求”。线上流量往往由大量简单请求构成,纯随机抽样会掩盖少见但高风险的问题。更稳妥的方式是按关键场景分层,例如高频场景、高价值用户、长上下文、工具调用失败、拒答和高风险领域,再从每层抽取样本。
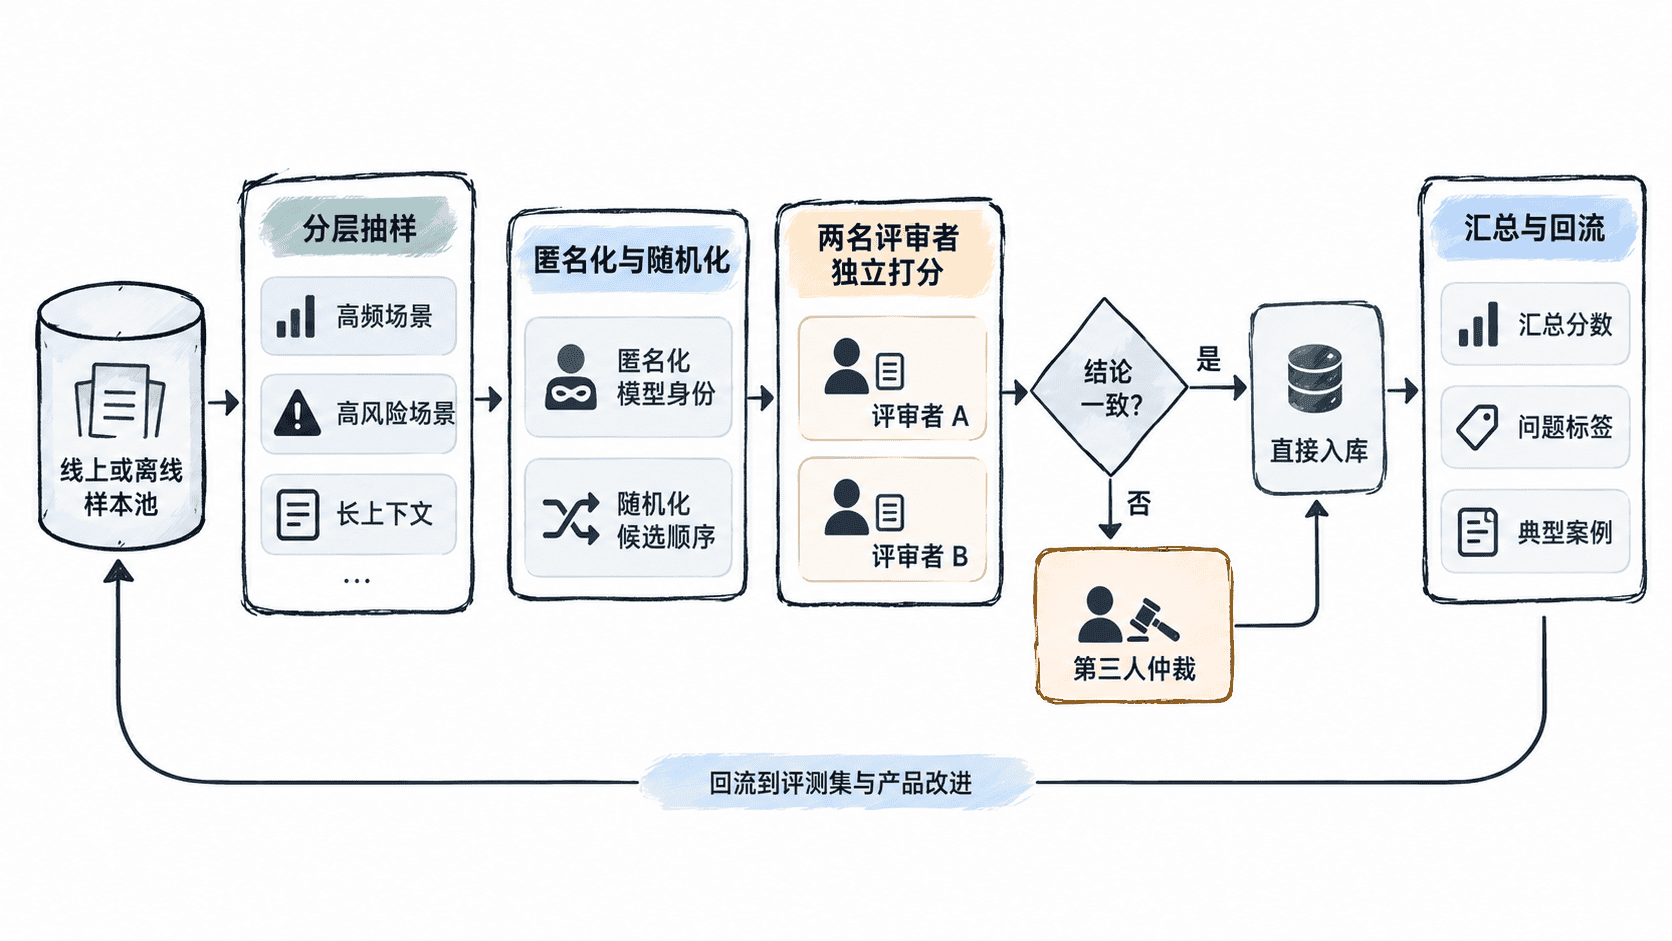
正式评审前先做一轮小规模校准:让所有评审者独立评同一批样本,再集中讨论分歧。只有当大家对“什么情况算 2 分、什么情况算 4 分”形成一致理解后,评分表才算真正可用。
控制评审偏差与一致性
盲评是最低成本的偏差控制:不展示模型名称、提供方和“新旧版本”标签,成对比较时随机左右或 A/B 顺序。对重要样本可安排双人独立评审,并保留一部分重叠样本用于观察一致性。
一致性低时,不要先责怪评审者。常见根因通常是评分标准含糊、样本上下文不足,或某个维度同时包含两个判断任务。先回看分歧最大的样本,修改锚点,再重新校准,比单纯增加评审人数更有效。
记录结果并形成改进闭环
每条评审记录至少保留样本 ID、评审者、各维度分数、问题标签、简短依据和是否需要仲裁。汇总时除了平均分,还要按场景查看失败率和问题类型分布;否则一个高频简单场景可能把高风险场景的问题“平均掉”。
| 样本 ID | 场景 | 总分 | 问题标签 | 备注 | 是否仲裁 |
|---|---|---|---|---|---|
<ID> |
退款咨询 | 3 | 遗漏约束 | 未说明处理时限 | 是 |
实际 ID、场景和评分会随评审集变化。更有价值的输出不是一个总分,而是一组可行动结论:哪些场景退化、哪类错误最多、哪些样本适合加入长期回归集。这样人工评审才会从一次性验收,变成持续改进模型应用的稳定反馈源。