
大模型应用开发 / 系统课时
解析知识文档
解析知识文档
知识库检索依赖的不是“文件本身”,而是一组结构稳定、可追溯的文本记录。本节把文档解析拆成正文提取、结构识别、页码与来源保留、统一记录格式四个步骤,并用一个可运行示例构造后续切分和索引可直接消费的数据。
学习目标
- 知道解析阶段必须保留哪些正文与元数据。
- 能把不同来源文档归一化为统一的可检索记录。
- 能识别扫描件、页眉页脚和结构丢失等常见解析风险。
先定义解析后的记录
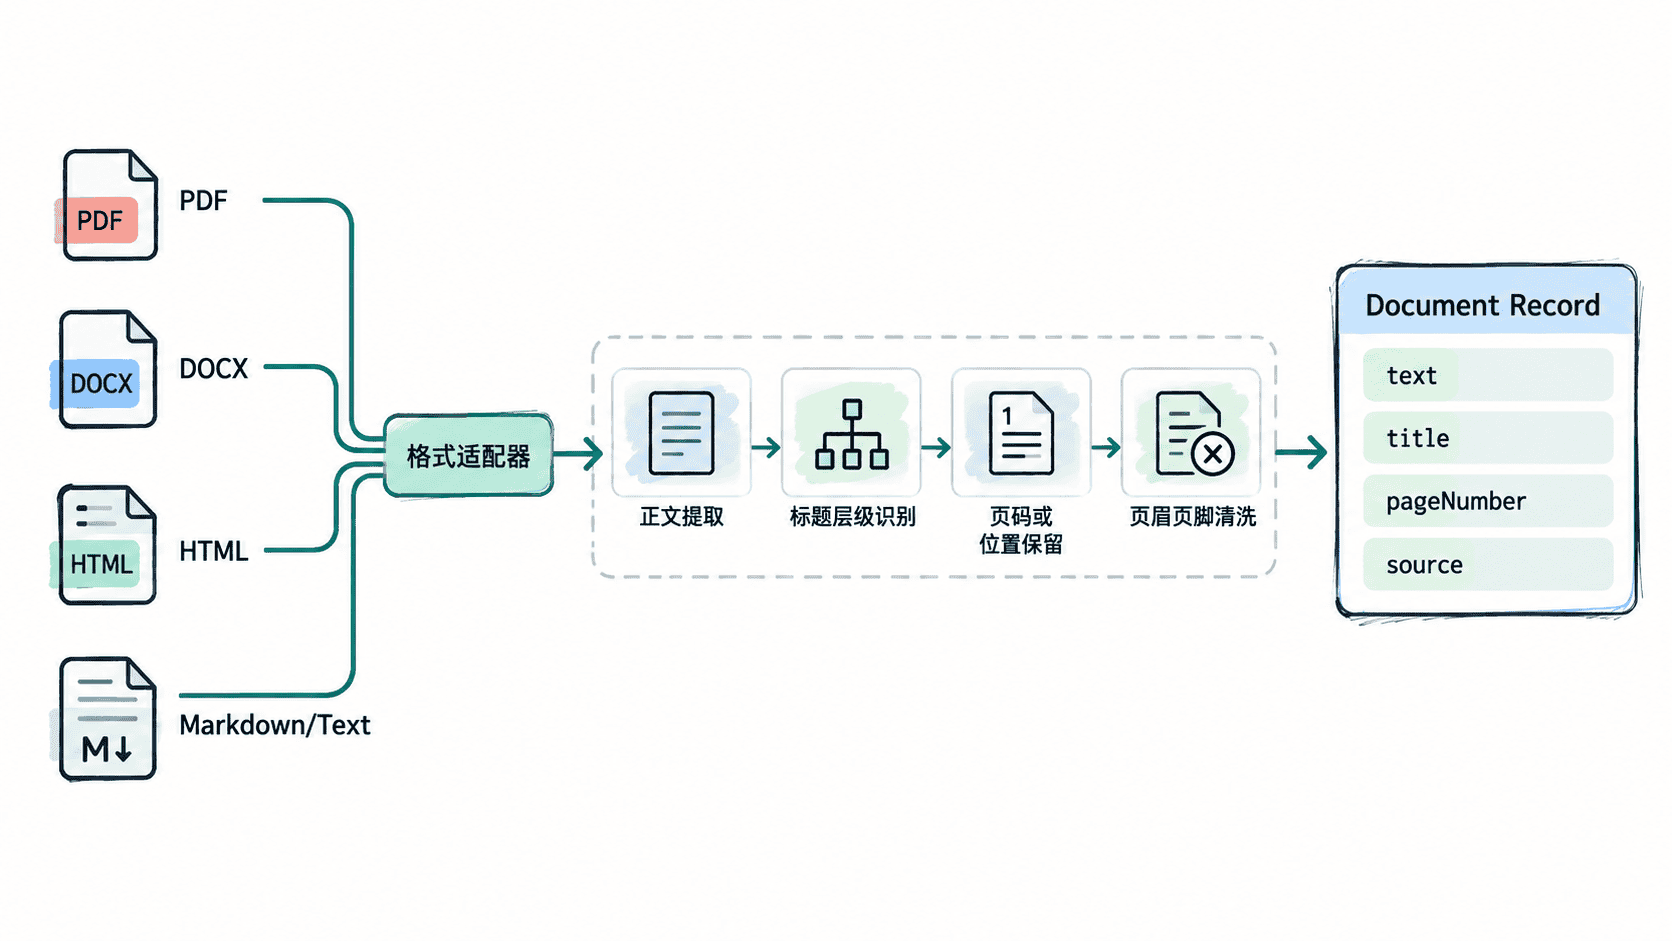
后续切分、Embedding 和检索不应该直接依赖 PDF、DOCX 或 HTML 的内部结构。更稳妥的做法是先归一化成统一记录,每条至少包含正文、标题、页码和来源。没有页码的格式可以把页码设为空,但来源标识不能丢。
典型字段可以是 text、title、pageNumber、source。如果业务需要权限过滤、版本控制或多租户隔离,还可以增加文档 ID、更新时间、租户 ID 等元数据,但这些字段应在解析阶段确定含义,避免后续各环节自行猜测。
用统一函数产出可检索记录
下面的示例只使用 Python 标准库,模拟一个已经完成“文件读取”的文本适配器。它用换页符 \f 表示页边界,用 Markdown 一级标题作为文档标题,并输出统一记录。真实 PDF 或 DOCX 适配器只需要把各页或各段正文交给同样的归一化逻辑。
from dataclasses import asdict, dataclass
import json
import re

@dataclass
class DocumentRecord:
    text: str
    title: str
    pageNumber: int
    source: str

def parse_text_document(source: str, raw_text: str) -> list[DocumentRecord]:
    pages = raw_text.split("\f")
    records: list[DocumentRecord] = []
    title = source

    for page_number, page in enumerate(pages, start=1):
        lines = [line.strip() for line in page.splitlines()]
        lines = [line for line in lines if line]

        # 优先使用第一个 Markdown 一级标题作为文档标题。
        heading = next((line for line in lines if re.match(r"^#\s+\S", line)), None)
        if heading:
            title = re.sub(r"^#\s+", "", heading).strip()

        # 清除标题标记后保留正文,空页不写入检索记录。
        body_lines = [re.sub(r"^#{1,3}\s+", "", line) for line in lines]
        body = "\n".join(body_lines).strip()
        if body:
            records.append(DocumentRecord(body, title, page_number, source))

    return records

def main() -> None:
    sample = "# 向量检索指南\n向量检索用于按语义召回候选片段。\f"
    sample += "## 参数建议\ntop_k 决定初次召回的候选数量。"

    records = parse_text_document("knowledge.md", sample)
    print(json.dumps([asdict(item) for item in records], ensure_ascii=False, indent=2))

if __name__ == "__main__":
    main()
预期输出:
[
  {
    "text": "向量检索指南\n向量检索用于按语义召回候选片段。",
    "title": "向量检索指南",
    "pageNumber": 1,
    "source": "knowledge.md"
  },
  {
    "text": "参数建议\ntop_k 决定初次召回的候选数量。",
    "title": "向量检索指南",
    "pageNumber": 2,
    "source": "knowledge.md"
  }
]
这个示例把“解析”和“切分”刻意分开:解析阶段只负责忠实提取与归一化,不在这里把文本切成检索 Chunk。这样可以先检查原始内容是否完整,再单独调节切分策略,避免错误相互叠加。
不同格式需要不同适配器
PDF 适配器应按页读取文本,并尽量保留页码;DOCX 适配器应读取段落和标题样式;HTML 适配器需要移除导航、脚本和样式,只保留正文结构;Markdown 和纯文本则重点保留标题层级与来源路径。最终都转换成同一种记录结构。
对于扫描版 PDF,普通文本提取通常会得到空字符串或乱码,这时需要 OCR;对于双栏论文、复杂表格和页眉页脚重复的文档,还需要版面分析或清洗规则。解析器不是越“智能”越好,关键是输出内容可验证、来源可追溯。
用抽样检查保证解析质量
入库前至少抽样检查正文完整性、标题归属、页码和来源四项。正文中不应大量混入页眉页脚;跨页内容不能无故丢失;同一条记录的来源必须能定位回原文件。对表格、代码块和图片说明等特殊内容,要明确是保留原文、转成文本,还是在当前知识库中忽略。
解析的验收标准不是“成功读出了字符串”,而是得到结构稳定、内容完整、来源可追溯的记录。把格式差异封装在适配器里,后续切分与索引才能只面向统一数据结构。