
大模型应用开发 / 系统课时
追踪调用链路
追踪调用链路
大模型请求往往跨过检索、模型、工具和业务服务,单看某一层日志很难解释一次慢请求为何发生。本节建立统一的 Trace 与 Span 记录方式,让你能从一次用户请求追到具体高延迟或失败节点。
学习目标
- 用统一
trace_id关联模型、检索、工具和业务服务记录 - 通过 Span 的父子关系、耗时和状态定位异常节点
- 识别异步调用、重试和并行调用导致的链路断裂问题
先统一链路标识
一次用户请求应只生成一个 trace_id,后续检索、模型调用、工具调用和业务接口都继承它。每个独立操作再创建自己的 span_id,并用 parent_span_id 表示它由哪个操作触发。
如果下游服务重新生成 trace_id,日志虽然都存在,却无法还原为同一条链路。生产环境通常通过 HTTP Header、RPC Metadata 或消息属性传播 Trace Context,而不是让各服务自行猜测关联关系。
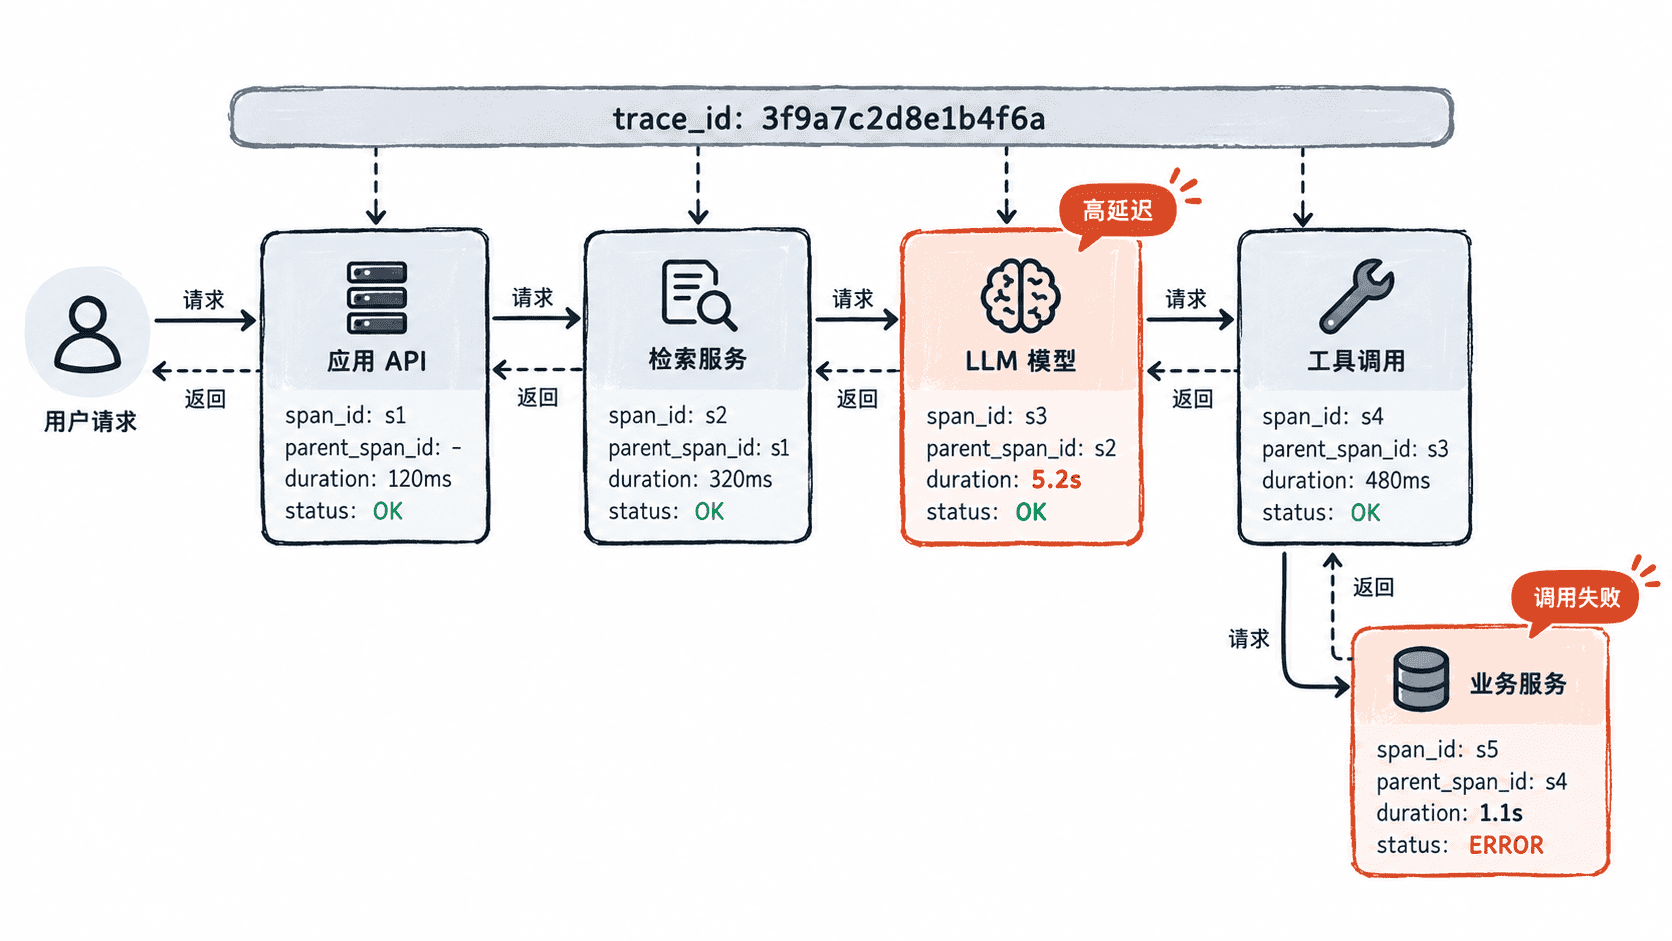
记录足够定位问题的字段
每个 Span 至少记录操作名称、开始时间、耗时、状态和上下文标识。模型调用还可附加模型名、Token 数与重试次数;检索调用记录索引名、候选数量和过滤条件;工具与业务服务记录目标服务、接口名和返回状态。
不要默认记录完整提示词、用户输入、检索原文或工具参数。它们可能包含隐私、密钥或业务数据,应优先保存脱敏后的摘要、长度、哈希或允许列出的字段。
用一个请求串起四类调用
下面用标准库模拟一条完整调用链。真实系统可替换成 OpenTelemetry 等追踪 SDK,但字段关系保持一致。
import json
import uuid


def record_span(trace_id, span_id, parent_span_id, operation, duration_ms, status):
    # 所有节点共享 trace_id,span_id 只标识当前操作。
    event = {
        'trace_id': trace_id,
        'span_id': span_id,
        'parent_span_id': parent_span_id,
        'operation': operation,
        'duration_ms': duration_ms,
        'status': status,
    }
    print(json.dumps(event, ensure_ascii=False))


def main():
    trace_id = uuid.uuid4().hex

    # root 表示一次完整业务请求,其他 Span 按真实调用关系挂接。
    record_span(trace_id, 'root', None, 'chat_request', 1280, 'OK')
    record_span(trace_id, 's1', 'root', 'vector_retrieval', 85, 'OK')
    record_span(trace_id, 's2', 'root', 'llm_generation', 910, 'OK')
    record_span(trace_id, 's3', 'root', 'tool_order_query', 260, 'OK')
    record_span(trace_id, 's4', 's3', 'order_service', 230, 'OK')


if __name__ == '__main__':
    main()
预期输出
{"trace_id": "<ID>", "span_id": "root", "parent_span_id": null, "operation": "chat_request", "duration_ms": 1280, "status": "OK"}
{"trace_id": "<ID>", "span_id": "s1", "parent_span_id": "root", "operation": "vector_retrieval", "duration_ms": 85, "status": "OK"}
{"trace_id": "<ID>", "span_id": "s2", "parent_span_id": "root", "operation": "llm_generation", "duration_ms": 910, "status": "OK"}
{"trace_id": "<ID>", "span_id": "s3", "parent_span_id": "root", "operation": "tool_order_query", "duration_ms": 260, "status": "OK"}
{"trace_id": "<ID>", "span_id": "s4", "parent_span_id": "s3", "operation": "order_service", "duration_ms": 230, "status": "OK"}
实际 trace_id 每次运行都会不同。这个例子中模型生成占用了 910 ms,是整条链路最大的单节点耗时;工具调用的 260 ms 中又有 230 ms 来自订单服务,因此继续优化工具封装本身意义有限,应优先检查下游服务。
按固定顺序定位慢请求和失败
先按 trace_id 找到完整请求,再检查状态为失败的 Span,避免只盯着总耗时。没有显式错误时,再按耗时从高到低查看关键路径,同时区分串行和并行调用:两个并行 Span 各耗时 500 ms,并不意味着总请求一定增加 1000 ms。
出现失败时还要查看重试关系。一次模型调用超时后重试成功,最终业务状态可能是成功,但调用次数、延迟和费用都已经上升,因此重试次数也应成为 Span 属性或事件。
一套有效的追踪方案最终要回答三个问题:这次请求经过了哪些节点、时间花在了哪里、失败最早出现在哪里。只要统一传播上下文并记录必要字段,就能把分散日志还原成可操作的故障证据。