
大模型应用开发 / 系统课时
识别拒答与截断
识别拒答与截断
同样是“没有得到目标内容”,安全拒答、长度截断和调用异常的处理方式完全不同。本节建立一个统一响应分流规则,并用可运行示例把三类状态映射为明确动作:结束、续写或重试。
学习目标
- 根据响应状态区分拒答、截断和调用异常。
- 为不同失败类型选择停止、续写或重试策略。
- 避免把拒答当网络故障重试,也避免把截断结果误当完整答案。
先按状态分流,而不是先读正文
不同模型 SDK 的字段名并不完全一致,但应用层最好先归一化为少量稳定状态。例如:completed 表示正常完成,refusal 表示安全拒答,length 表示因输出长度限制而停止,error 表示调用失败。
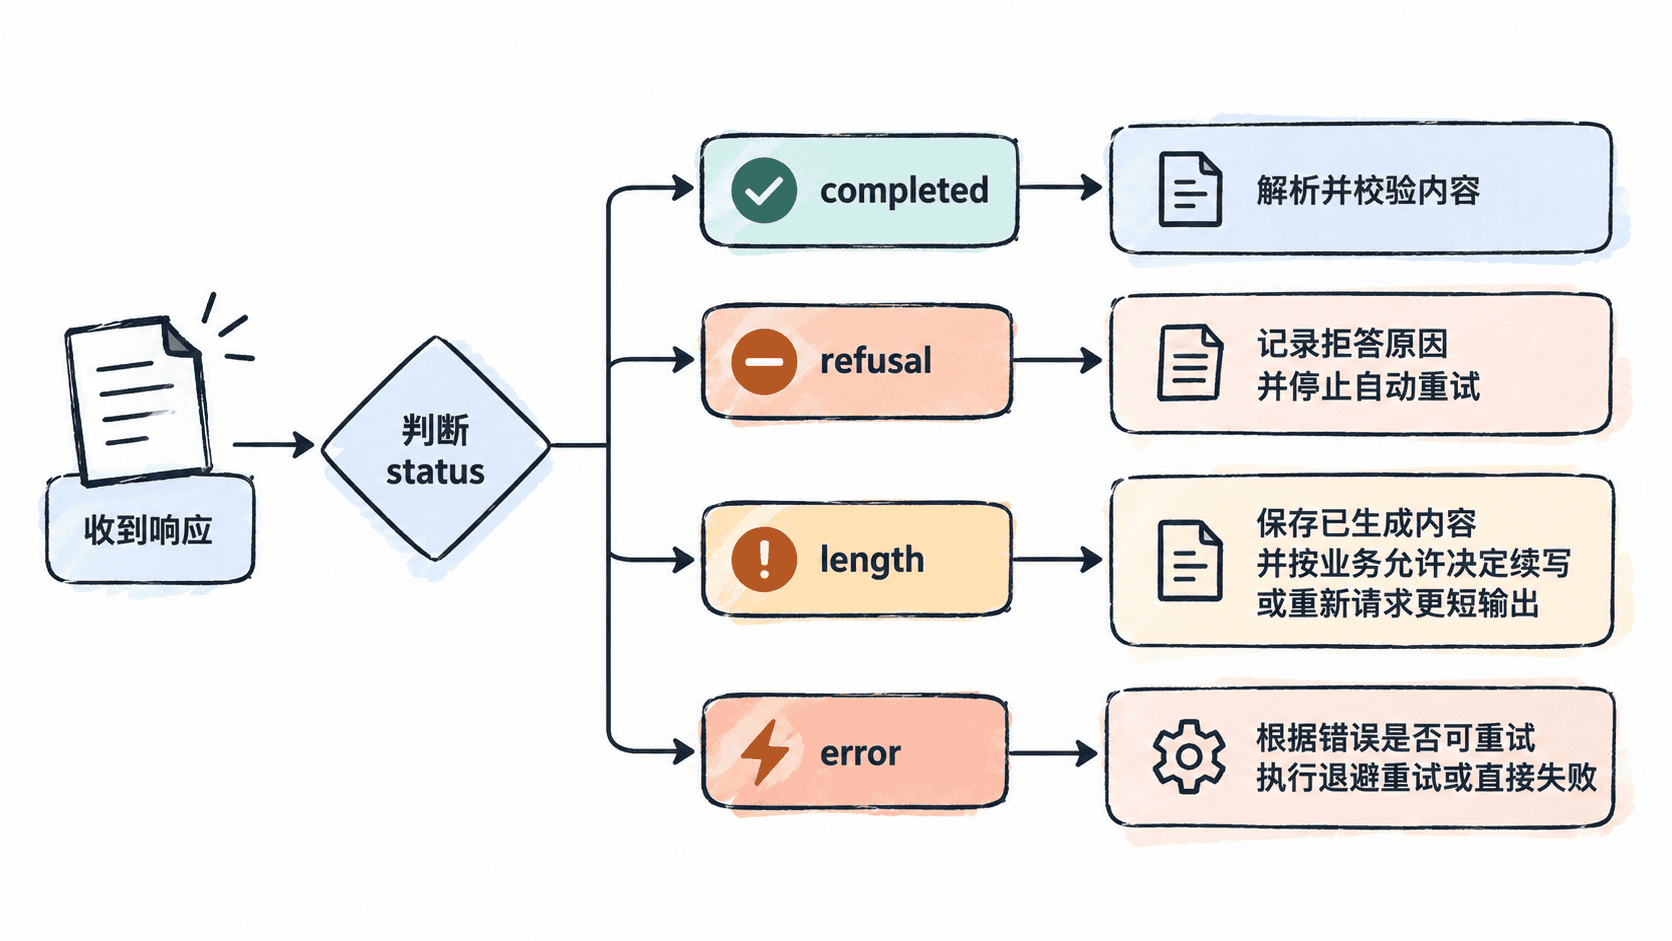
这一步的关键不是猜测正文语气,而是优先使用响应中的结构化状态。仅凭“抱歉”“无法协助”等文本判断拒答并不可靠,因为这些词也可能出现在正常内容里。
用统一处理器映射动作
下面示例模拟应用已经把供应商响应归一化后的结果。处理器只负责根据状态决定下一步,不耦合具体 SDK。
def decide_action(response):
    status = response.get("status")
    if status == "completed":
        return "ACCEPT"
    if status == "refusal":
        return "STOP_AND_RECORD"
    if status == "length":
        return "CONTINUE_OR_REASK_SHORTER"
    if status == "error":
        return "RETRY_IF_TRANSIENT"
    return "FAIL_UNKNOWN_STATUS"

samples = [
    {"status": "completed"},
    {"status": "refusal"},
    {"status": "length"},
    {"status": "error"},
]

for item in samples:
    print(item["status"], "->", decide_action(item))
预期输出
completed -> ACCEPT
refusal -> STOP_AND_RECORD
length -> CONTINUE_OR_REASK_SHORTER
error -> RETRY_IF_TRANSIENT
三类异常分别怎么处理
安全拒答通常意味着模型明确不提供某类内容。应用应记录拒答状态和可公开的原因,向用户给出合适提示,并停止无意义的自动重试。连续换措辞规避拒答不仅浪费调用次数,也可能破坏安全边界。
长度截断意味着已经生成的内容可能只是前半段。不要直接进入 JSON 解析或业务执行;应先判断协议是否允许续写。自由文本可以携带末尾上下文继续生成,严格 JSON 则通常更适合重新请求更短、更受约束的结果,因为简单拼接两段 JSON 容易得到无效结构。
调用异常则需要继续细分。超时、连接中断、限流等瞬时错误可以按策略重试;认证失败、请求参数错误等确定性错误应立即失败并修正调用。重试时使用最大次数和退避间隔,避免故障期间形成请求风暴。
先处理状态,再处理内容
推荐固定顺序:先确认调用是否成功,再判断是否拒答或截断,只有确认是完整正常响应后,才进入解析、字段校验和业务处理。这样可以避免把半截 JSON 误判成格式错误,也能让监控准确区分模型行为和基础设施故障。
只要把“状态识别”和“内容解析”分成两个阶段,后续无论更换模型供应商还是调整重试策略,业务层都能保持稳定。