
大模型应用开发 / 系统课时
隔离多用户会话
隔离多用户会话
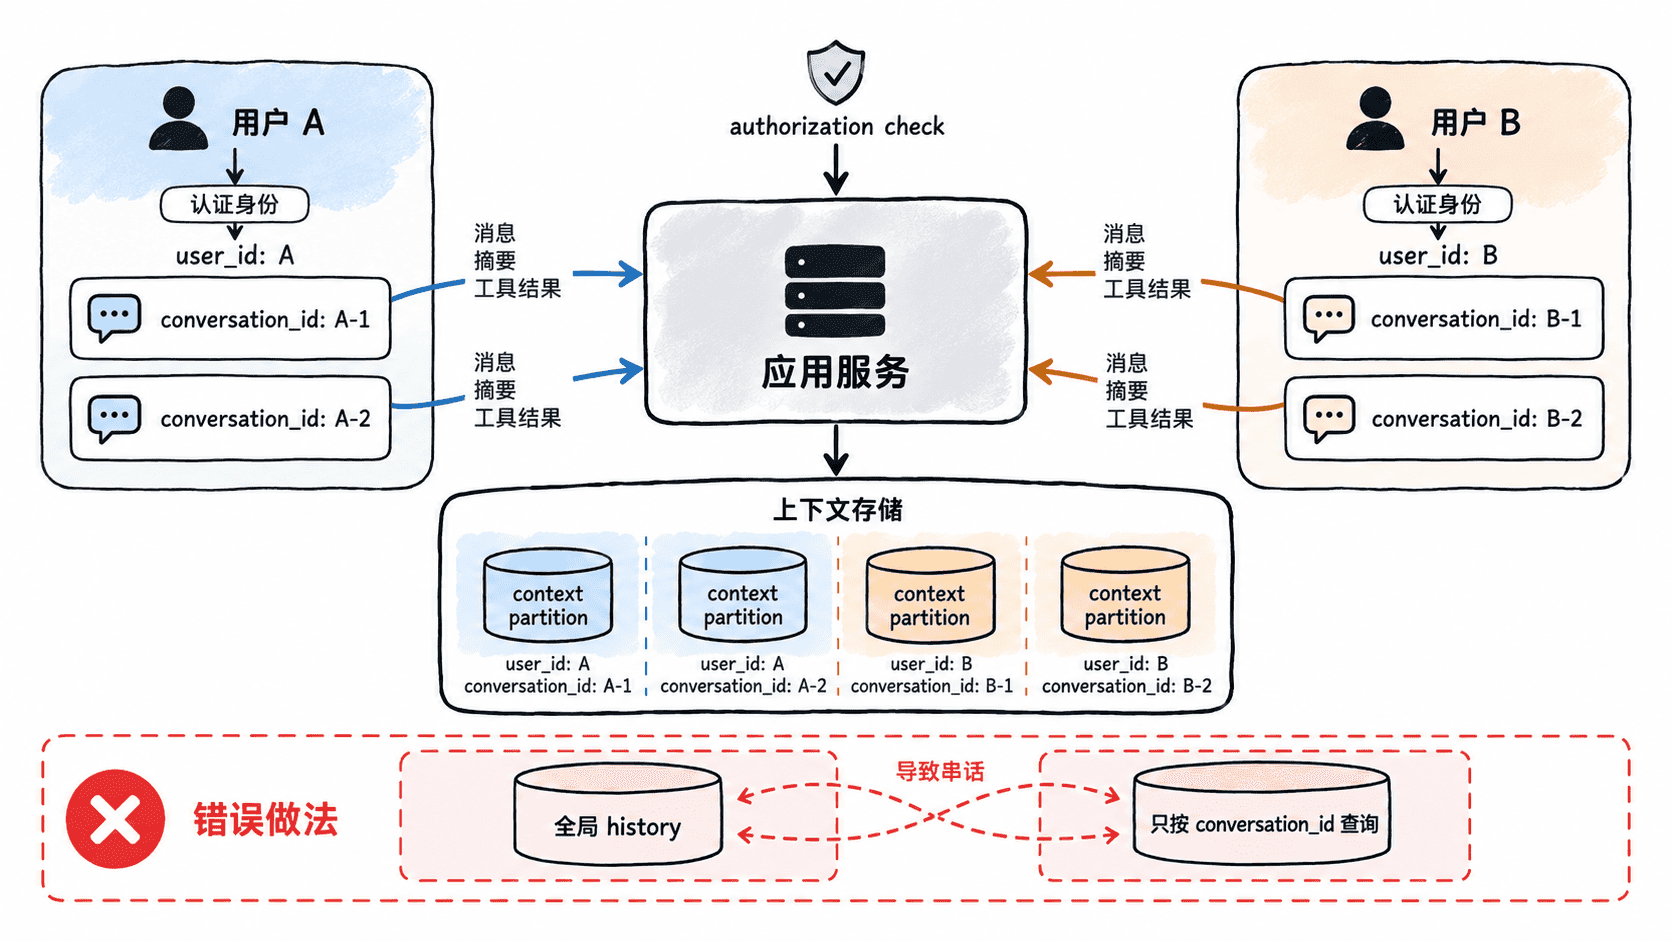
多用户应用最危险的上下文问题不是模型“忘记”,而是把 A 用户的数据带进 B 用户的请求。可靠的会话隔离必须同时约束存储键、读取条件、缓存范围和权限校验,让任何上下文都只能在明确的用户与会话边界内流动。
学习目标
- 用用户 ID 与会话 ID 建立双重上下文边界
- 识别共享缓存、错误查询条件和对象复用造成的串话风险
- 通过授权校验与隔离测试验证多用户数据不会越界
用两个标识定义上下文边界
user_id 表示“数据属于谁”,conversation_id 表示“这次对话是哪一条线程”。只按会话 ID 存储,如果 ID 可猜测或查询缺少用户条件,就可能发生越权读取;只按用户 ID 存储,又会把同一用户的多个任务混在一起。
因此,消息、摘要、工具结果和会话状态至少应以 (user_id, conversation_id) 作为逻辑分区键。长期用户记忆可以只按用户隔离,但读取时仍需确认当前请求已经通过该用户的身份认证。
让存储和读取都带上所属用户
隔离不能只靠变量命名,真正的约束必须落到查询条件。下面用一个最小示例模拟会话存储:写入和读取都同时检查用户与会话,错误用户即使知道会话 ID 也取不到内容。
from collections import defaultdict

messages: dict[tuple[str, str], list[str]] = defaultdict(list)

def append_message(user_id: str, conversation_id: str, text: str) -> None:
    messages[(user_id, conversation_id)].append(text)

def load_messages(user_id: str, conversation_id: str) -> list[str]:
    return list(messages.get((user_id, conversation_id), []))

append_message("user-a", "conv-1", "A 的订单号是 1001")
append_message("user-b", "conv-1", "B 的订单号是 9008")

print(load_messages("user-a", "conv-1"))
print(load_messages("user-b", "conv-1"))
print(load_messages("user-c", "conv-1"))
预期输出:
['A 的订单号是 1001']
['B 的订单号是 9008']
[]
这里故意让两个用户都使用 conv-1,用于验证会话 ID 不能单独承担隔离职责。数据库实现时,应让查询条件始终同时包含当前认证用户和会话 ID,而不是先按会话查出记录再在应用层“尽量过滤”。
防止缓存和进程内对象绕过隔离
很多串话并不是数据库查询写错,而是来自共享变量。例如把 history 定义成全局列表、把最近一次摘要缓存在单例对象上,或者用 conversation_id 作为唯一缓存键,都会让不同用户复用同一份上下文。
缓存键应包含租户或用户边界,例如 context:{user_id}:{conversation_id}。异步任务也要显式携带这两个标识,不能依赖线程本地变量或“当前用户”这种隐式状态,因为任务切换后这些状态可能已经不属于原请求。
把授权校验放在读取之前
会话 ID 应被视为资源标识,而不是访问凭证。每次读取历史消息、摘要、文件引用或工具状态前,都要先确认该资源属于当前认证用户。对于团队或组织协作场景,还要再检查成员关系和资源权限,而不是因为“同组织”就默认可读。
服务端最好从认证令牌或受信任的会话中获得 user_id,不要接受客户端任意传入一个用户 ID 后直接用于查询。客户端可以提交 conversation_id,但最终访问范围必须由服务端身份决定。
用隔离测试证明不会串话
验收时至少构造两个用户,并刻意让它们使用相同的会话 ID、相似的问题和并发请求。验证四件事:A 只能读 A 的历史,B 只能读 B 的历史;不存在会话时返回空或明确的未授权结果;缓存命中不会跨用户;异步任务完成后结果仍写回原用户与原会话。
如果系统支持删除会话,还要检查删除 A 的会话不会误删 B 的同名会话。隔离设计只有在“错误用户拿不到数据”的测试中成立,才算真正形成边界,而不是仅在正常路径上看起来没有串话。