
大模型应用开发 / 系统课时
转写音频内容
转写音频内容
音频转写不只是把声音变成一段文字。可用结果还要同时处理语言、时间戳、说话人、静音与噪声,并为不确定片段保留位置。把这些信息分层保存,后续才能做检索、字幕、会议纪要和人工复核。
学习目标
- 把音频转写拆成识别、时间对齐、说话人和清洗四个层次
- 根据单语、混合语言和噪声情况选择合适的转写策略
- 生成既适合阅读又能回到原音频复核的结构化文本
先明确转写链路
稳定的转写链路通常先做音频标准化和语音活动检测,再进入语音识别;识别结果随后补时间戳、说话人分段,最后才做标点、格式和术语修正。不要在最前面就“润色”,否则错误会失去原始位置。
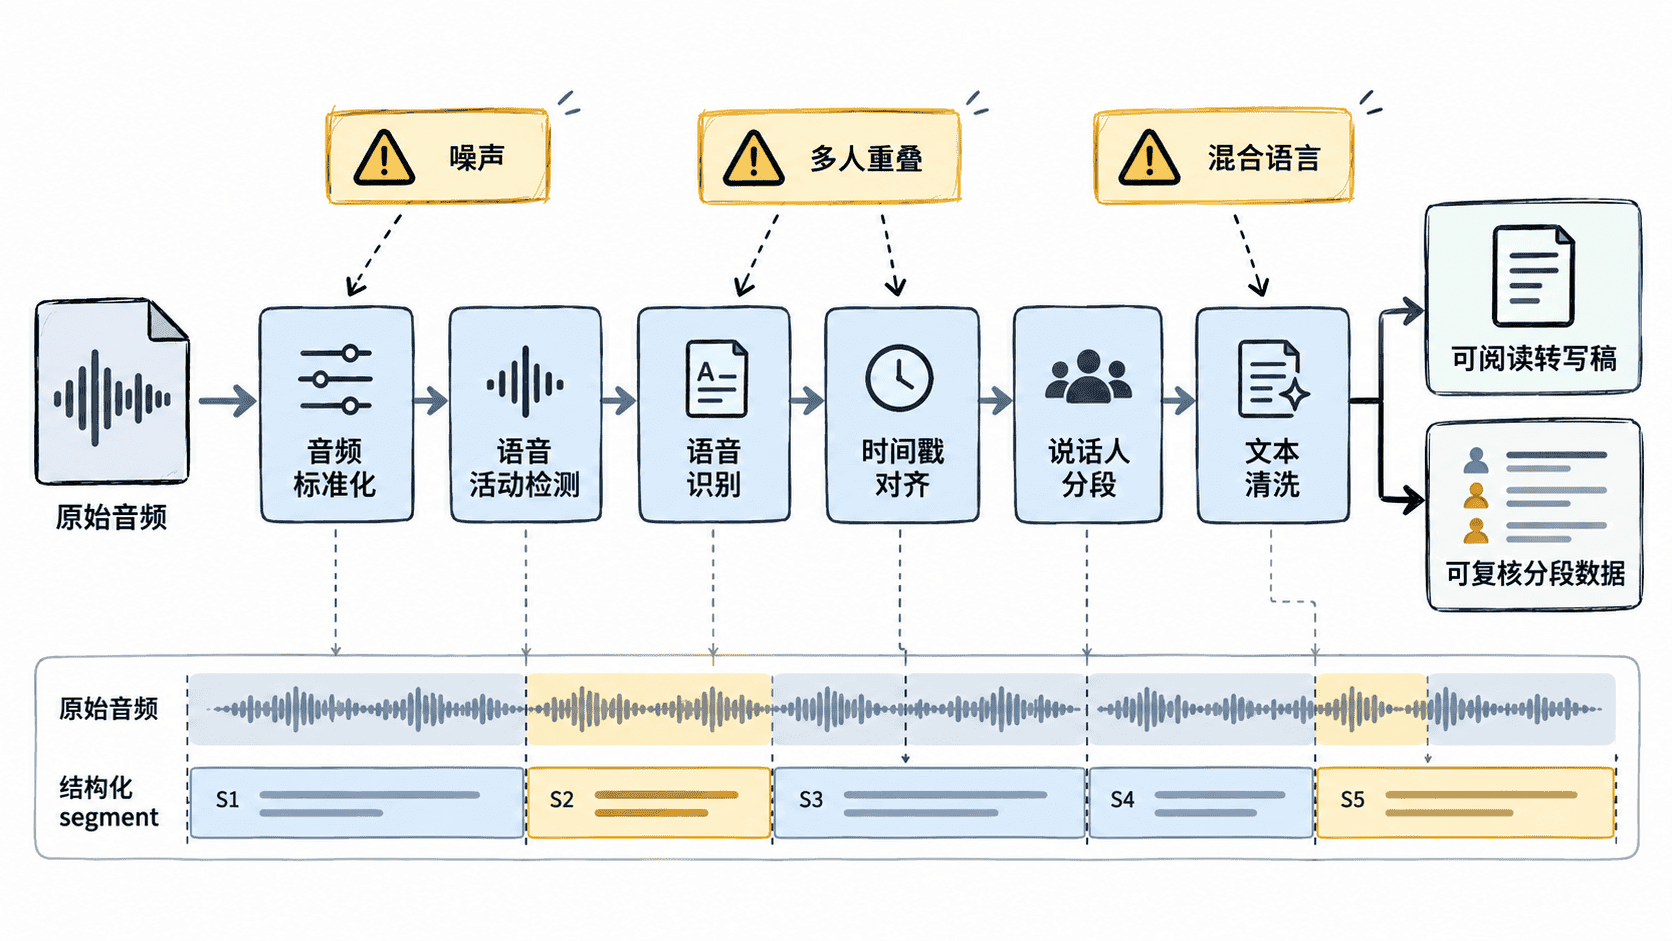
每个识别片段最好至少保留 start、end、text 和说话人标签;如果引擎提供置信度,也应保存在结构化数据中,而不是直接把低置信度文本删除。删除会让后续复核无法判断“这里没有人说话”还是“这里没识别出来”。
选择语言与时间戳策略
已知音频几乎全是单一语言时,显式指定语言通常更稳定,也能减少模型在短片段上的误判。真正的混合语言场景再使用自动检测,并尽量按较长语音片段判断,不要对每个词频繁切换语言标签。
时间戳粒度取决于用途。做全文检索和会议纪要时,句段级时间戳通常足够;做字幕编辑、逐字审校或对齐训练数据时,才需要词级时间戳。粒度越细,处理成本和对齐误差也越值得关注。
处理噪声、重叠和说话人
降噪不是越强越好。过度消除背景声可能同时削弱辅音和低音量人声,反而降低识别率。更稳妥的做法是先做语音活动检测,跳过长静音;对低信噪比区段保留时间戳和低置信度标记,必要时单独重跑。
多人同时说话是最容易破坏说话人分段的情况。系统应允许“重叠说话”或“说话人不确定”这类状态,而不是强制把每一秒归给唯一的人。会议场景还要警惕频繁切换:若同一人连续说话却被切成多个标签,说明分段粒度可能过细。
把识别结果整理成可复核文本
下面示例不实现具体 ASR 引擎,而是演示所有引擎都需要的后处理层:保留时间范围、说话人和低置信度标记,再生成适合人工阅读的文本。示例可直接运行,不依赖第三方库。
from dataclasses import dataclass

@dataclass
class Segment:
    start: float
    end: float
    speaker: str
    text: str
    confidence: float

def stamp(seconds: float) -> str:
    total = int(seconds)
    return f"{total // 60:02d}:{total % 60:02d}"

def render(segment: Segment) -> str:
    # 低置信度片段保留原文,并显式标记供人工复核。
    uncertain = " [待复核]" if segment.confidence < 0.75 else ""
    text = " ".join(segment.text.strip().split())
    return (
        f"[{stamp(segment.start)}-{stamp(segment.end)}] "
        f"{segment.speaker}: {text}{uncertain}"
    )

segments = [
    Segment(0.0, 3.2, "SPEAKER_01", "大家好,今天确认 发布计划。", 0.96),
    Segment(3.2, 6.8, "SPEAKER_02", "周五 下午切换。", 0.68),
]

for segment in segments:
    print(render(segment))
预期输出:
[00:00-00:03] SPEAKER_01: 大家好,今天确认 发布计划。
[00:03-00:06] SPEAKER_02: 周五 下午切换。 [待复核]
这里故意没有自动改写“周五 下午”或补全专有名词。转写层首先要忠于识别结果;术语统一、数字校正和语句润色应放在后续步骤,并保留修改前文本。
验收与失败回退
验收时先看时间覆盖是否连续,再抽查低置信度、多人重叠、数字、日期、专有名词和长静音后的首句。若某个区段质量差,应只重跑该时间窗口,而不是整段音频全部重做。
适合生产使用的转写结果应同时保留两份数据:一份是便于阅读的整理稿,另一份是带时间戳、说话人和置信度的原始分段。前者服务人,后者负责追溯;两者分离后,清洗和润色才不会破坏可验证性。