
大模型应用开发 / 系统课时
并行处理请求
并行处理请求
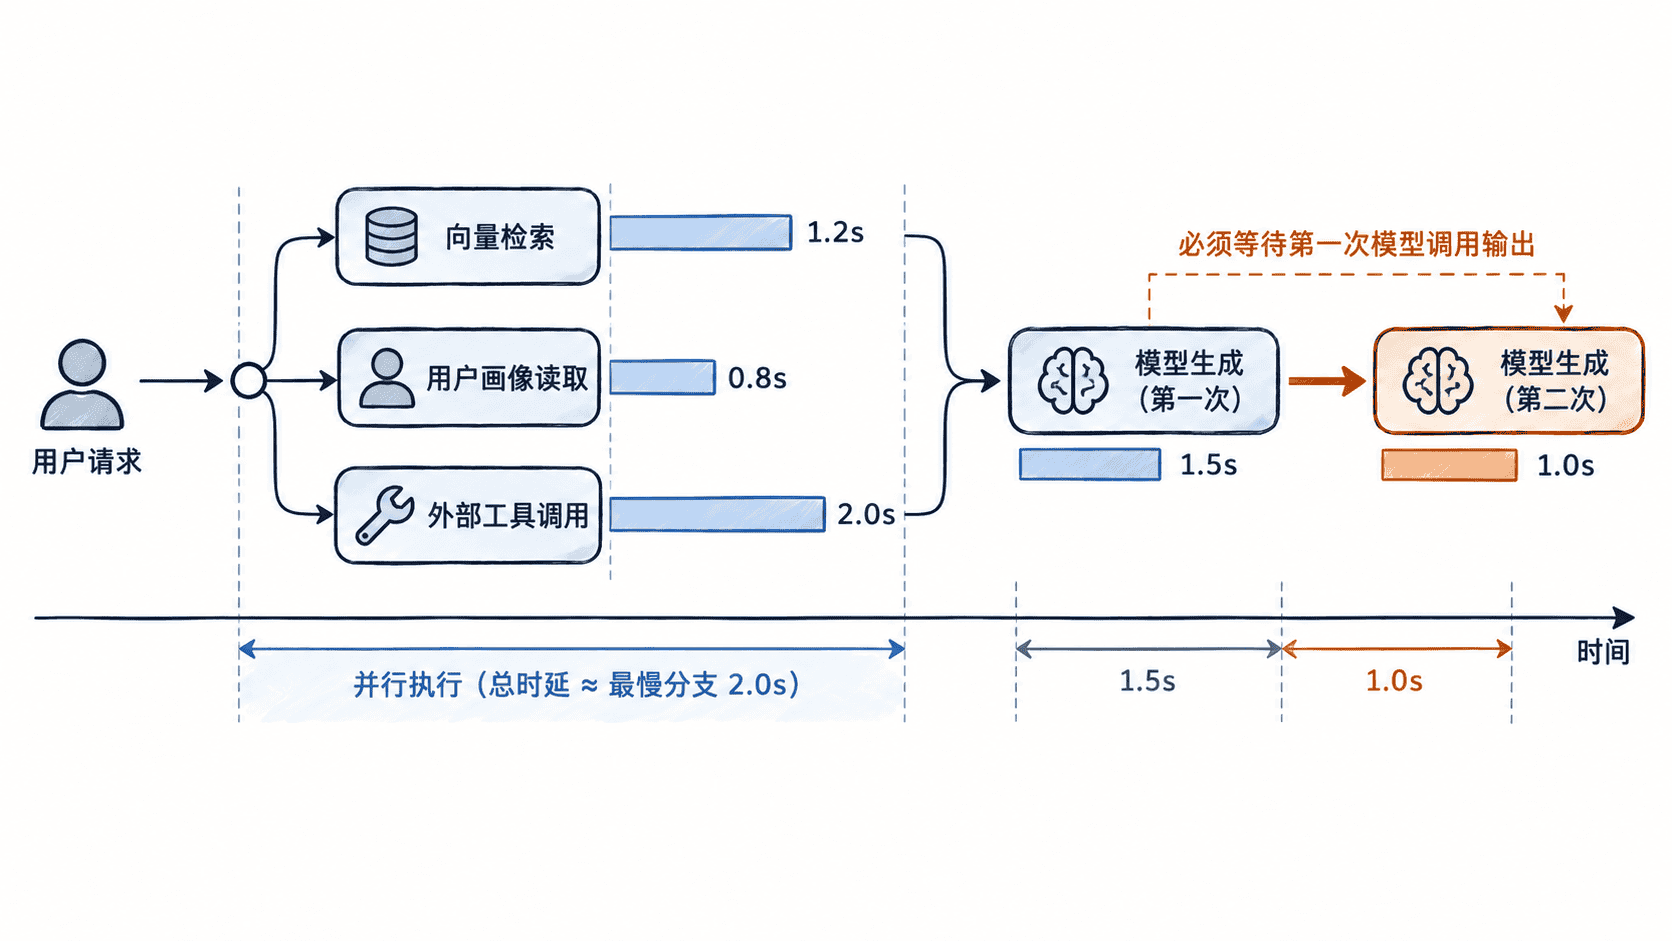
当一次 LLM 请求要同时访问模型、向量检索和外部工具时,串行执行会把每段等待时间直接累加。把彼此独立的调用并行化,可以在不改变业务结果的前提下,把总耗时压缩到最慢分支附近,同时保留统一的超时、异常和结果汇总策略。
学习目标
- 判断哪些模型、检索和工具调用可以安全并行,哪些必须保持依赖顺序。
- 使用异步并发缩短独立 I/O 请求的总等待时间。
- 为并行分支设置超时、异常隔离和结果汇总规则。
先判断能不能并行
并行化的前提不是“调用很多”,而是“分支之间没有数据依赖”。例如,用户问题到达后,同时执行知识库检索、用户画像读取和两个互不依赖的工具查询,通常可以并行;如果第二次模型调用必须使用第一次模型调用生成的参数,就必须串行。
判断时可用一个简单标准:某个分支能否只依赖当前已经拥有的输入启动。如果答案是能,就可以进入并行候选;如果必须等待其他分支的输出,就应保留顺序。
用 asyncio 并发执行独立调用
下面用三个异步函数模拟模型、检索和工具调用。asyncio.gather 会同时启动三个任务,并等待它们全部完成。示例中的 sleep 只是代替真实网络 I/O,实际项目里应换成支持异步的 SDK 或 HTTP 客户端。
import asyncio
import time

async def call_model():
    await asyncio.sleep(1.2)
    return "model:ok"

async def search_docs():
    await asyncio.sleep(0.8)
    return "search:ok"

async def call_tool():
    await asyncio.sleep(1.0)
    return "tool:ok"

async def main():
    started = time.perf_counter()

    # 三个分支没有数据依赖,因此同时启动。
    model_result, search_result, tool_result = await asyncio.gather(
        call_model(),
        search_docs(),
        call_tool(),
    )

    elapsed = time.perf_counter() - started
    print(model_result, search_result, tool_result)
    print(f"elapsed={elapsed:.1f}s")

asyncio.run(main())
预期输出
model:ok search:ok tool:ok
elapsed=<TIME>s
实际耗时会受调度和网络波动影响,因此 <TIME> 的实际值可能略高于 1.2。如果改成依次 await 三个函数,理论等待时间约为 1.2 + 0.8 + 1.0 = 3.0s。
给每个分支加超时和异常隔离
并行并不意味着所有分支必须一起成功。一个非关键工具超时,不应该让已经完成的检索结果也作废。可以在分支内部用 asyncio.wait_for 设置超时,并把异常转换成明确状态;对于关键分支,则可以选择失败即终止整次请求。
import asyncio

async def run_branch(name, coro, timeout):
    try:
        value = await asyncio.wait_for(coro, timeout=timeout)
        return {"name": name, "ok": True, "value": value}
    except Exception as exc:
        # 生产环境应记录异常类型和调用标识,不要只吞掉错误。
        return {"name": name, "ok": False, "error": type(exc).__name__}

async def slow_tool():
    await asyncio.sleep(2)
    return "done"

async def main():
    result = await run_branch("tool", slow_tool(), timeout=0.5)
    print(result)

asyncio.run(main())
预期输出
{'name': 'tool', 'ok': False, 'error': 'TimeoutError'}如果使用的运行时或库对超时异常命名不同,错误类型文本可能不同,但分支应被识别为失败,并且主流程仍可继续处理其他结果。
控制并发度而不是无限并发
并行能降低单次请求延迟,但并发量过高会把压力转移到模型配额、向量数据库、连接池或第三方 API。批量处理时应使用信号量、连接池上限或任务队列限制同时在途的请求数。
import asyncio

sem = asyncio.Semaphore(3)

async def limited_call(i):
    async with sem:
        await asyncio.sleep(0.2)
        return i

async def main():
    results = await asyncio.gather(*(limited_call(i) for i in range(6)))
    print(results)

asyncio.run(main())
预期输出
[0, 1, 2, 3, 4, 5]这个结果只说明六个任务最终都完成;真正的并发上限是任意时刻最多三个任务进入受保护区。生产环境还应同时观察吞吐、P95/P99 时延、超时率和下游限流错误,确认并行化没有把瓶颈推向别的系统。
什么时候保持串行
当后一步需要前一步输出、多个分支会修改同一状态、调用存在顺序副作用,或下游服务明确要求串行时,不应强行并行。最佳实践是先画出依赖关系,再只并行独立的 I/O 分支,并在汇总点统一处理超时、降级和失败,这样才能真正换来可控的延迟收益。