
大模型应用开发 / 系统课时
设置限流与配额
设置限流与配额
本节解决大模型应用在突发流量下如何避免单个用户、单个应用或高成本模型抢占全部资源。完成后,你会得到一套分层限流与配额方案,并能用代码验证并发门禁和用量扣减是否按预期工作。
学习目标
- 区分并发限制、速率限制与周期配额各自解决的问题
- 按用户、应用和模型三个维度组合限流策略
- 在拒绝请求时返回可重试、可观测的明确结果
把流量控制拆成三类门禁
并发限制控制“同一时刻有多少请求正在占用模型资源”,适合保护连接池、推理槽位和流式连接;速率限制控制“单位时间允许进入多少请求”,适合削峰;周期配额控制“一个统计周期最多消耗多少资源”,适合限制请求数、Token 或金额。
三类规则不应互相替代。只设每分钟请求数,仍可能在同一秒涌入大量长连接;只设并发数,又无法阻止某个调用方全天持续占用容量。实际服务通常先做并发门禁,再做速率门禁,最后在调用模型前检查剩余配额。
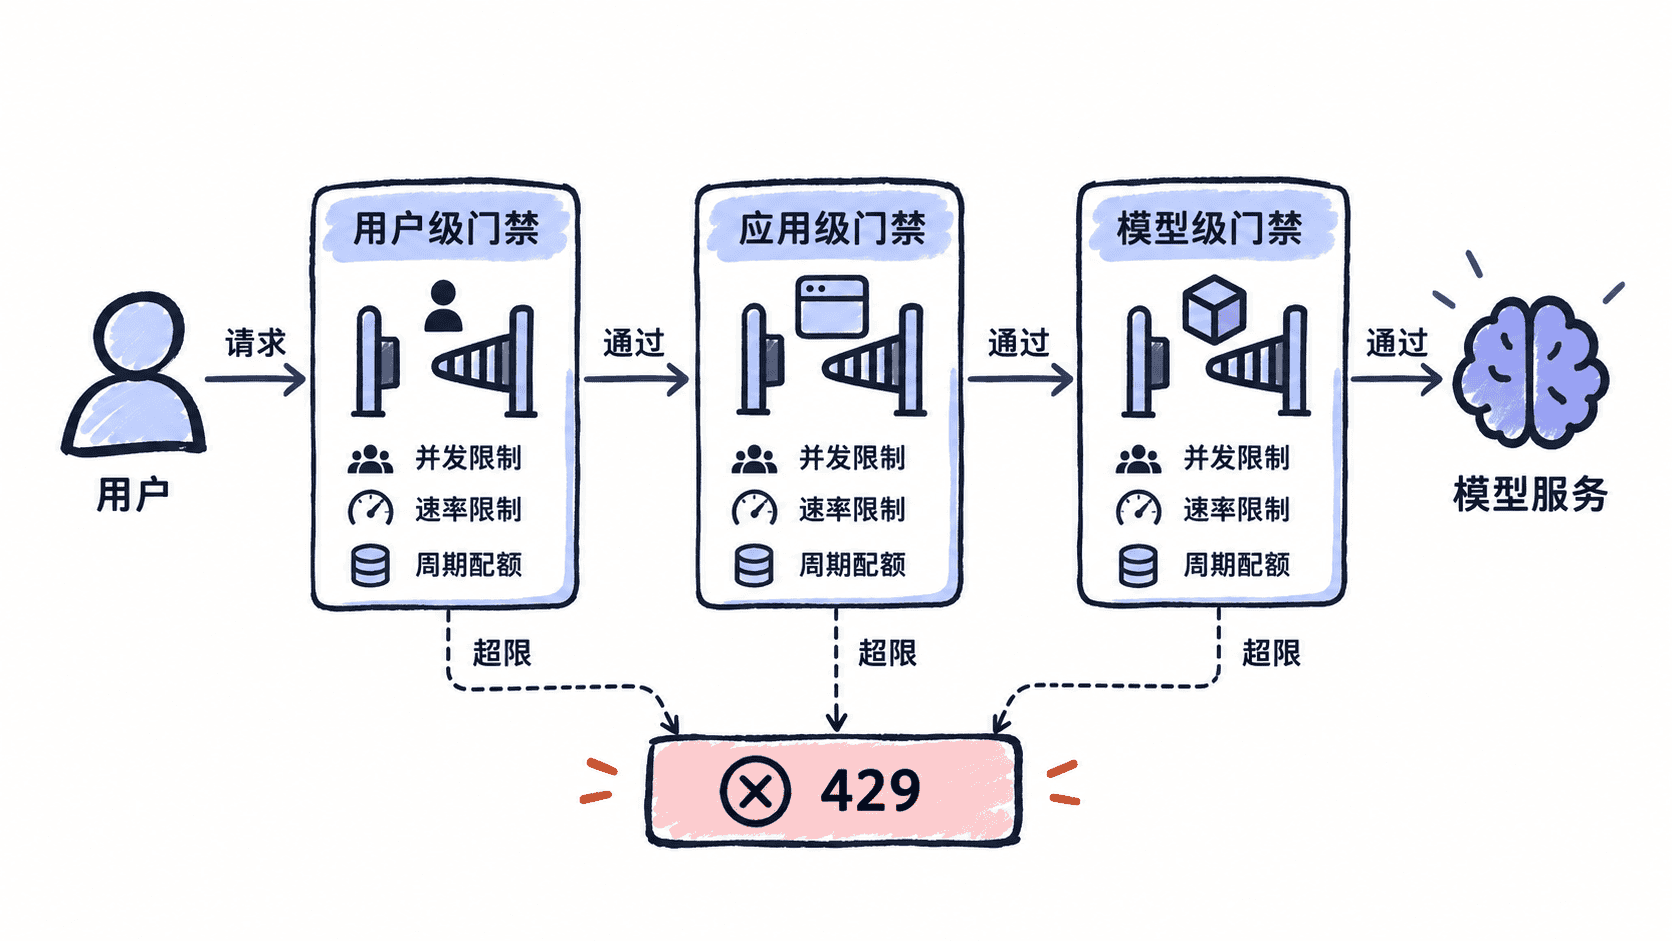
组合用户、应用和模型规则
一个请求可能同时命中三组策略。例如用户 u-42 的并发上限是 2,应用 support-bot 是 20,而模型 reasoning-model 是 8,那么这个请求必须同时满足三项条件;任意一项达到上限都应拒绝或排队。
配额也应使用同样的分层思路。用户可以有每日 Token 上限,应用可以有月度预算,模型可以有全局每分钟请求数。判断时不要把多个维度相加,而是分别检查,任何一个维度不足都应停止继续调用模型。
用最小实现验证并发与配额
下面的 Python 示例不依赖 Web 框架,直接模拟三个请求依次进入同一用户策略。它展示两个关键动作:进入前检查并发和剩余额度,完成后释放并发并扣减实际 Token。应用级和模型级规则可以复用同一检查方式,并在真正调用模型前全部通过。
from dataclasses import dataclass

@dataclass
class LimitState:
    concurrent: int
    max_concurrent: int
    used_tokens: int
    token_quota: int

def acquire(state: LimitState, estimated_tokens: int) -> tuple[bool, str]:
    # 并发门禁优先,避免请求先占用更多下游资源。
    if state.concurrent >= state.max_concurrent:
        return False, "concurrency_limit"
    if state.used_tokens + estimated_tokens > state.token_quota:
        return False, "quota_exceeded"
    state.concurrent += 1
    return True, "accepted"

def release(state: LimitState, actual_tokens: int) -> None:
    # 完成后按真实用量结算,并释放并发槽位。
    state.concurrent -= 1
    state.used_tokens += actual_tokens

user = LimitState(concurrent=1, max_concurrent=2, used_tokens=900, token_quota=1000)

ok1, reason1 = acquire(user, estimated_tokens=80)
ok2, reason2 = acquire(user, estimated_tokens=80)
print(ok1, reason1)
print(ok2, reason2)

if ok1:
    release(user, actual_tokens=60)

ok3, reason3 = acquire(user, estimated_tokens=80)
print(ok3, reason3)
print(user)
预期输出:
True accepted
False concurrency_limit
False quota_exceeded
LimitState(concurrent=1, max_concurrent=2, used_tokens=960, token_quota=1000)
第二个请求因为并发已达到 2 被拒绝;第一个请求完成后释放并发,但实际消耗 60 Token,使剩余额度只剩 40,因此第三个请求又被配额门禁拒绝。生产环境应把状态放到具备原子操作能力的共享存储中,避免多实例分别计数。
设计可重试的拒绝响应
限流拒绝建议使用 HTTP 429 Too Many Requests,同时返回稳定的机器可读错误码。速率限制可以提供 Retry-After;并发限制可以给出短暂重试时间;周期配额耗尽则通常不能通过立即重试解决,应返回配额恢复时间或升级提示。
{
  "error": {
    "code": "RATE_LIMITED",
    "message": "model concurrency limit reached",
    "retryAfterSeconds": 2
  }
}
这是响应结构片段示例,依赖实际 HTTP 服务返回。验证时应确认调用方能根据 code 区分“稍后重试”和“本周期额度已耗尽”,而不是把所有 429 都做无上限重试。
上线前检查关键边界
限流状态必须按稳定标识统计,用户维度不要直接相信客户端可伪造的 ID;流式请求应在连接真正结束后再释放并发;异常、超时和客户端断开也必须执行释放逻辑。对于分布式部署,还要保证计数、扣减和过期是原子的,并为策略命中率、拒绝原因和剩余配额建立监控。
真正有效的限流不是简单“挡住更多请求”,而是让不同用户、应用和模型都在明确的资源边界内运行,并让被拒绝的请求知道何时重试、为什么失败。