
大模型应用开发 / 系统课时
设置终止条件
设置终止条件
智能工作流一旦允许模型循环调用工具,就必须同时限制步数、总耗时和资源预算。本节用一个可运行的 Python 示例把三类终止条件放进同一控制循环,并区分“正常完成”和“被安全阈值强制停止”。
学习目标
- 能为循环式工作流设置最大步骤、截止时间和资源预算
- 能统一返回终止原因,便于日志、告警与上层重试
- 能判断不同阈值应当放在循环的哪个位置检查
先定义可观测的终止原因
终止条件不应只写成一个模糊的 break。工作流至少要区分任务自然完成、步骤超限、超时和预算耗尽,因为它们对应完全不同的后续动作:自然完成可以提交结果,预算耗尽可能需要降级,超时则可能意味着外部工具卡住。
可把终止原因统一成少量稳定状态,例如 completed、max_steps、timeout 和 budget_exhausted。上层只依赖这些状态,不依赖模型生成的自由文本。
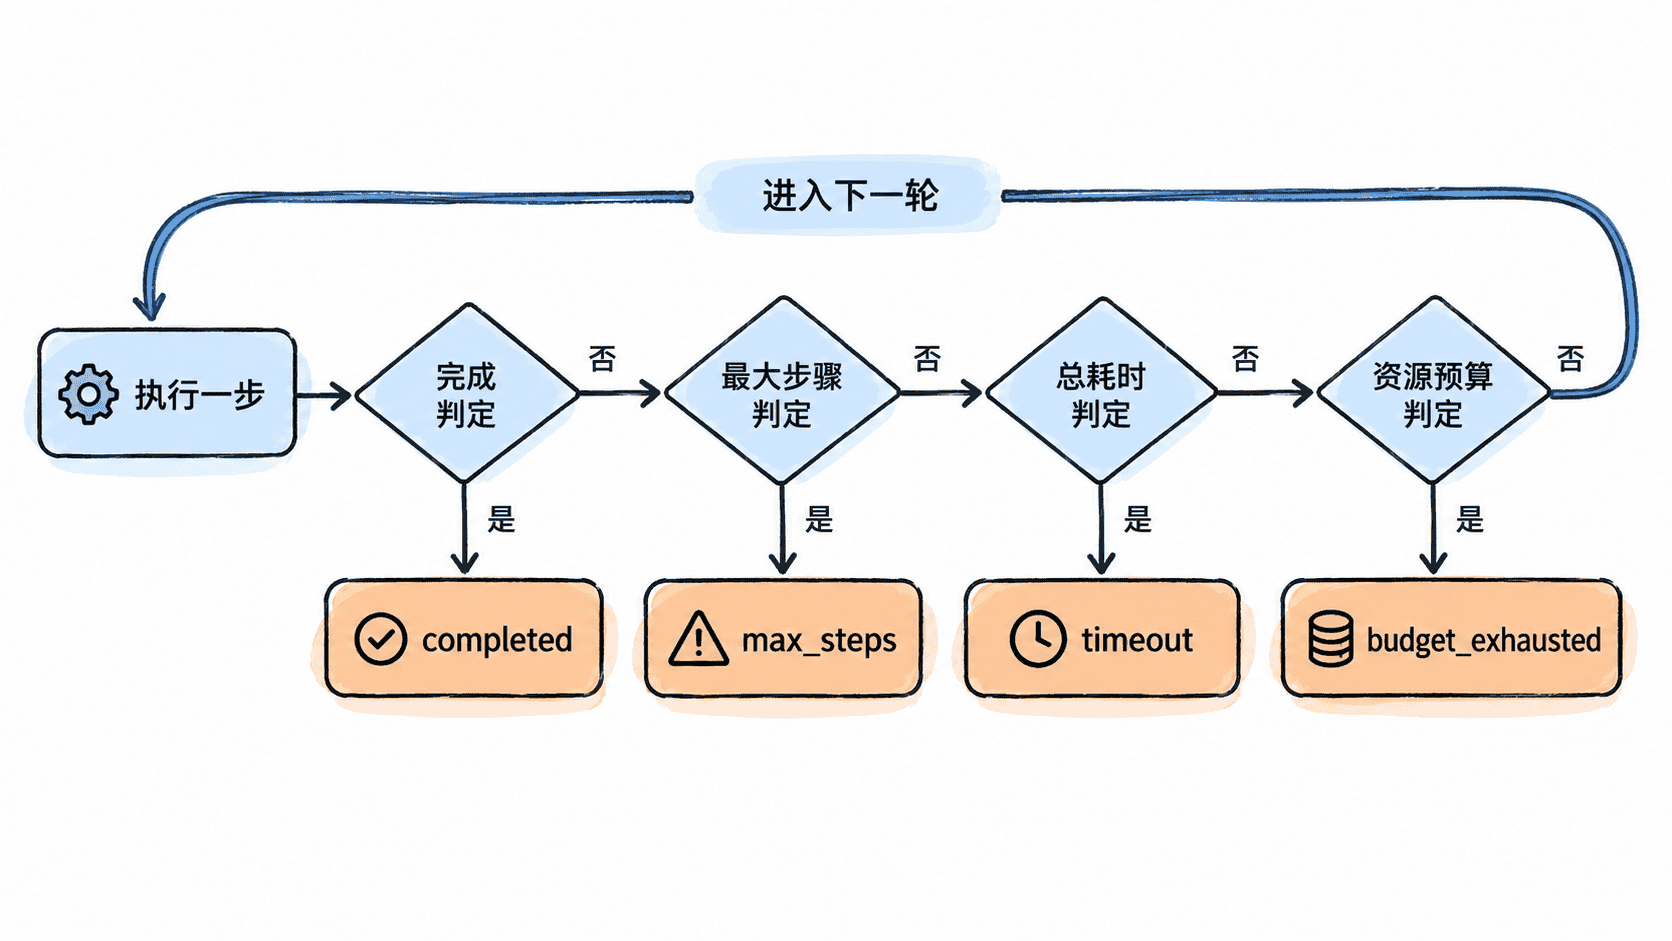
把三类限制放进同一控制循环
下面的程序模拟一个会持续执行步骤的智能工作流。每轮消耗固定资源,真实项目中可把 used_units 替换为 token、API 调用次数、费用或其他可计量资源。
import time

def run_workflow(max_steps: int, max_seconds: float, max_units: int) -> dict:
    started_at = time.monotonic()
    used_units = 0

    for step in range(1, max_steps + 1):
        # 在执行新一轮前检查时间和预算,避免已经超限后再发起昂贵调用。
        if time.monotonic() - started_at >= max_seconds:
            return {"status": "stopped", "reason": "timeout", "step": step - 1}

        next_cost = 4
        if used_units + next_cost > max_units:
            return {
                "status": "stopped",
                "reason": "budget_exhausted",
                "step": step - 1,
            }

        used_units += next_cost
        print(f"step={step}, used_units={used_units}")

        # 示例任务故意不自然完成,让最大步骤成为最后一道兜底。
        time.sleep(0.01)

    return {"status": "stopped", "reason": "max_steps", "step": max_steps}

if __name__ == "__main__":
    result = run_workflow(max_steps=3, max_seconds=5, max_units=20)
    print(result)
预期输出
step=1, used_units=4
step=2, used_units=8
step=3, used_units=12
{'status': 'stopped', 'reason': 'max_steps', 'step': 3}
这里把超时和预算检查放在昂贵操作之前,而把最大步骤直接编码到循环边界中。这样即使模型始终给出“继续执行”的建议,程序也不会无限运行。
选择阈值时看最坏损失
max_steps 约束的是推理链长度,最适合防止模型在规划、反思或工具重试中无限循环。它通常是最确定、最容易测试的一层保护,但不能替代超时,因为单个步骤本身也可能卡住很久。
max_seconds 约束整条工作流的墙钟时间。若单次工具调用可能阻塞,还要给工具请求设置更短的单调用超时;否则总超时只能在调用返回后才有机会被检查。
max_units 约束资源消耗。预算单位应尽量贴近真正的成本来源,例如累计 token、付费 API 次数或金额。不要只限制循环次数后就默认成本可控,因为不同步骤的消耗可能相差几个数量级。
让终止结果可恢复
安全停止并不等于把当前进度丢掉。每轮执行后应保存当前步骤、已使用预算、最近一次工具结果和必要的业务状态;触发阈值时返回结构化终止原因,并由上层决定是人工接管、缩小任务、换低成本模型还是稍后重试。
如果任务具有不可逆副作用,例如发送邮件、扣款或修改生产数据,还要把“是否已经执行副作用”写入检查点。这样即使工作流因超时被重新启动,也能从已确认状态继续,而不是重复执行同一操作。